CMake 构建指南
在现代 C/C++ 开发中,源码变为二进制可执行程序需要经过项目描述、构建规则生成、依赖调度、编译链接等阶段。CMake 并非编译器,而是一个元构建工具(Meta-Build System)。
为什么要用CMake?
学习 C/C++ 时,你是否也产生过这样的困惑:明明敲一句 gcc main.c -o app 就能跑通代码,为什么还要折腾复杂的 CMake?
这就好比在 Java 开发中,难道真的有人会在企业级项目里只靠 javac 一条条去编译源码吗? 显然不可能,我们必然会用 Maven 或 Gradle 来管理项目。
同样的逻辑放在 C/C++ 领域也完全成立。单文件时 gcc 确实方便,但当项目膨胀到数十个模块、依赖多个第三方库、还需要同时在 Windows 和 Linux 上运行时,直接裸敲编译器会让你瞬间陷入命令行参数膨胀、每次修改都全量重编译、以及跨平台命令不兼容的噩梦。而 CMake 恰恰就是 C/C++ 世界里的那个“跨平台构建指挥官”——它不直接干编译的活,而是让你用一份统一的 CMakeLists.txt 声明项目规则,自动在不同操作系统上生成原生的构建工程,彻底把开发者从繁琐的编译命令中解放出来。
NOTE
需要强调的是,C/C++ 的跨平台不是 Java 那种“一次编译,处处运行”,而是“源码级跨平台。
CMake 解决的正是这个“处处编译”的痛点——你不需要为了在 Linux 上编译去手写 Makefile,也不需要为了在 Windows 上开发去手动配置 Visual Studio 项目,而是用同一套 CMakeLists.txt 源码脚本,在目标平台上自动生成对应的原生构建工程,最终编译出特定系统专属的二进制文件。
Cmake的构建过程
我们通过一个极简的 C++ 项目,直观感受 CMake 的实际工作机制。
hello/
├── CMakeLists.txt     # 项目构建描述文件
├── main.cpp           # 程序入口
└── add.cpp # 业务逻辑实现add.cpp
int add(int a, int b) {
    return a + b;
}main.cpp
#include <iostream>

int add(int a, int b);

int main() {
    std::cout << "10 + 20 = " << add(10, 20) << std::endl;
    return 0;
}CMakeLists.txt
cmake_minimum_required(VERSION 3.20)
project(hello VERSION 1.0 LANGUAGES CXX)

# 设置 C++ 标准
set(CMAKE_CXX_STANDARD 20)
set(CMAKE_CXX_STANDARD_REQUIRED ON)
set(CMAKE_CXX_EXTENSIONS OFF)

# 定义构建目标:将 main.cpp 和 add.cpp 编译并链接为名为 hello 的可执行文件
add_executable(hello
    main.cpp
    add.cpp
)配置与生成(Configure & Generate Stage)
在现代 CMake 中,配置与生成阶段通常通过一条简单的命令自动完成:
cmake -S . -B build-S .:指定源码根目录(Source Directory,.代表当前目录)。-B build:指定构建输出目录(Build Directory),不存在则会自动创建。
幕后发生了什么?
当你敲下这条命令时,CMake 在后台连续完成了两件事:
- 配置阶段(Configure):读取
CMakeLists.txt,检测系统环境(自动寻找g++、clang++或cl.exe编译器)、检查 C++20 标准支持情况,并将相关配置写入build/CMakeCache.txt。 - 生成阶段(Generate):根据探测到的环境和系统默认生成器(如 Linux 下的
Unix Makefiles、Windows 下的Visual Studio,或通过-G Ninja指定的Ninja),在build/目录下生成底层的工程文件(如Makefile或build.ninja)。
最佳实践:源码外构建(Out-of-source Build)
永远不要在源码根目录下直接运行裸
cmake .(这叫源码内构建)。通过-B build将所有编译中间文件、缓存和目标脚本隔离在独立的build/目录中,既能保持源码目录干净,又能随时清理(直接删除build文件夹即可),还能方便地切换 Debug/Release 等不同构建版本。
编译与链接(Build Stage)
生成底层构建脚本后,我们不需要手动进入 build 目录去敲 make 或 ninja,直接使用 CMake 提供的跨平台编译命令:
cmake --build build幕后发生了什么?
- CMake 会自动识别
build/目录下使用的是哪种生成器(Makefile、Ninja 还是 VS 工程),并调用对应的底层工具(如make或ninja)。 - 底层工具分析源码依赖,调度编译器(如
g++)将main.cpp和add.cpp分别编译为.o目标文件,最后调用链接器合并生成最终的可执行文件hello。
运行编译好的程序:
./build/hello
# 输出:10 + 20 = 30构建目录核心产物
执行完 cmake -S . -B build 配置生成以及 cmake --build build 编译链接后,build/ 目录下会生成如下典型结构:
build/
├── CMakeCache.txt       # 配置缓存文件
├── CMakeFiles/          # 过程日志与中间目标文件(.o)
├── cmake_install.cmake  # (可选)安装规则脚本
├── Makefile             # (或 build.ninja)底层构建工具调用的脚本
└── hello # 最终编译链接生成的可执行程序CMakeCache.txt(配置缓存)记录配置阶段探测到的编译器路径、系统环境及通过
-D传入的自定义参数。再次运行cmake时会优先读取该文件,避免重复进行耗时的系统探测。CMakeFiles/(临时与中间过程目录)存放 CMake 在测试编译器特性、搜索依赖时生成的日志,以及编译过程中产生的可重定位目标文件(
.o)。Makefile或build.ninja(底层构建脚本)由 CMake 根据当前的生成器(Generator)直接导出的工程配置文件,作为底层构建引擎(如
make或ninja)调度的直接依据。hello(最终二进制产物)将
main.o和add.o进行符号重定位并链接标准库后导出的最终 ELF 二进制文件,可以直接载入内存运行。
编译过程
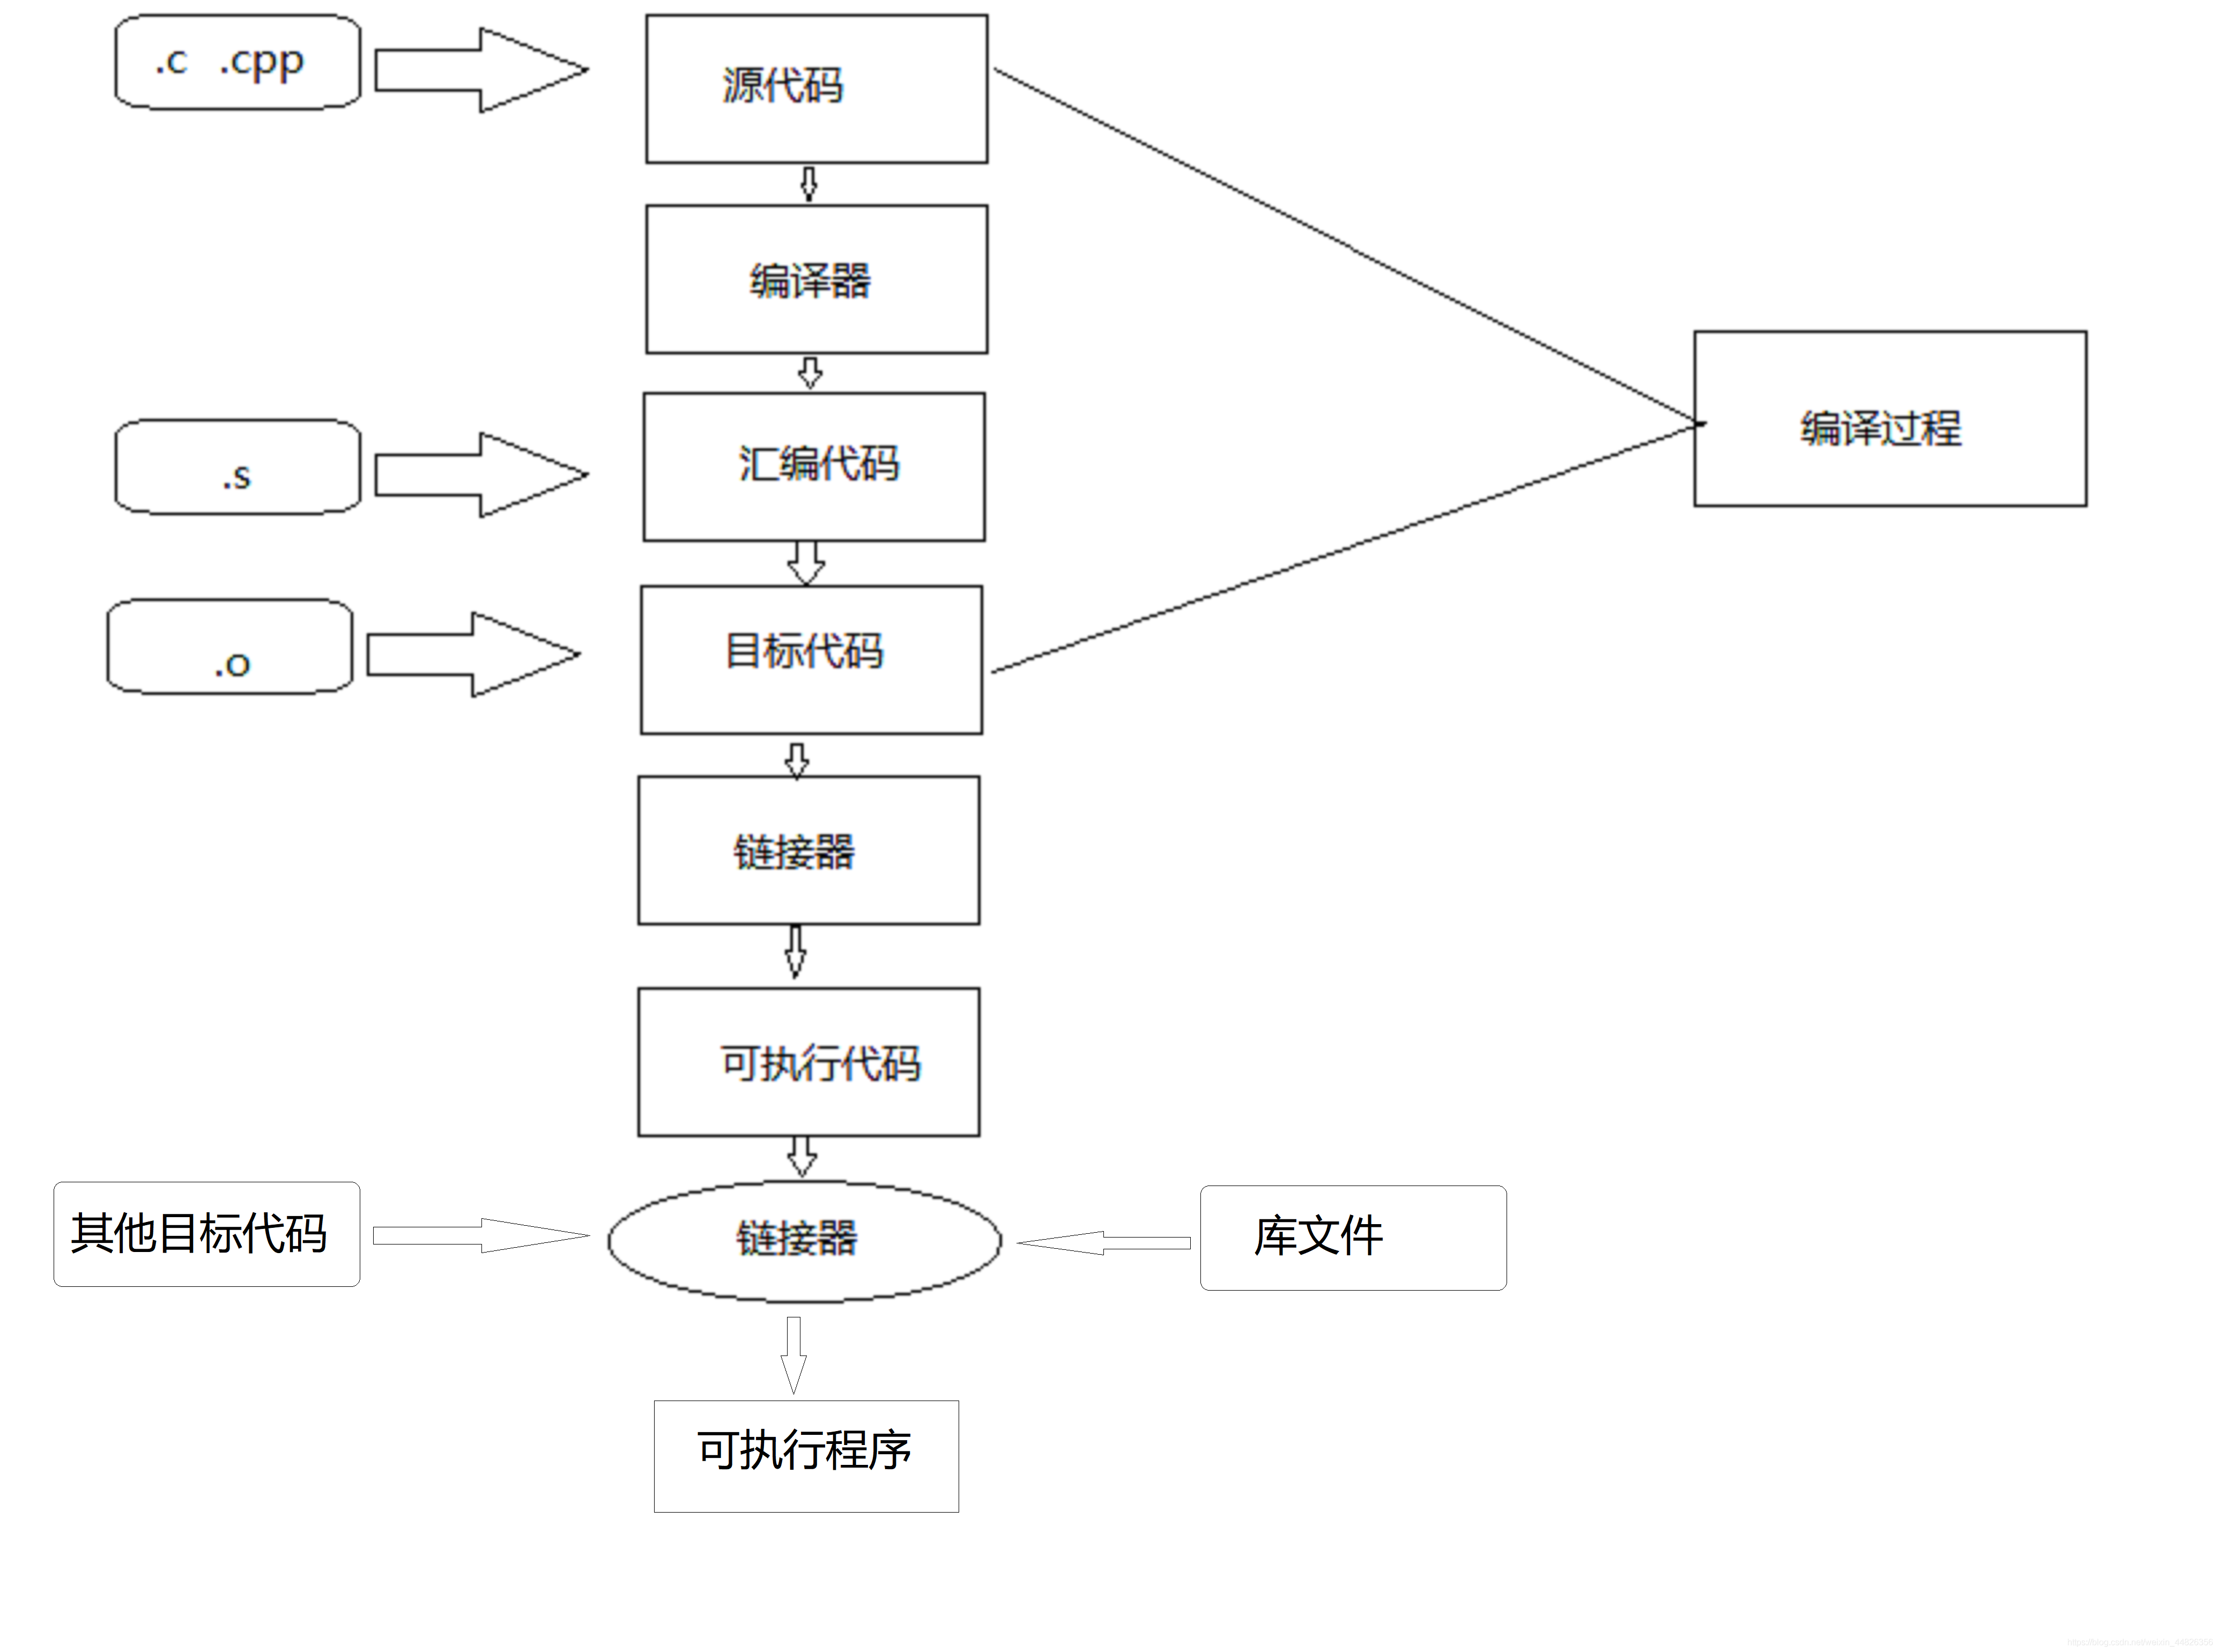
平时我们执行 gcc main.c -o main 时,GCC 会在后台自动完成这 4 个步骤。这段代码通过不同的命令行参数(-E、-S、-c),把内部隐藏的过程一步步拆解展示了出来:
1. 预处理 (Preprocessing)
- 命令:
gcc -E main.c -o main.i - 输入输出:
main.c(源码) →main.i(预处理文件) - 实质: 纯文本级别的替换与清理。
- 展开头文件: 把
#include <stdio.h>等包含的内容完整复制粘贴进文件。 - 宏替换: 将
#define MAX 100这类宏定义全部替换为具体的值。 - 删除注释: 清除所有的
//和/* */注释。 - 条件编译: 处理
#ifdef、#ifndef等分支逻辑。
- 展开头文件: 把
2. 编译 (Compilation)
- 命令:
gcc -S main.i -o main.s - 输入输出:
main.i→main.s(汇编代码) - 实质: 语法分析与指令翻译。
- 检查代码是否有语法错误。
- 将 C 语言的逻辑(如
if、for、变量加减)翻译成特定的机器 CPU 指令集对应的汇编语言(如mov,add,push)。
3. 汇编 (Assemble)
- 命令:
gcc -c main.s -o main.o - 输入输出:
main.s→main.o(二进制目标文件) - 实质: 汇编代码转机器码。
- 将文本格式的汇编指令翻译成计算机真正能理解的
0和1二进制二进制机器码(Object File)。 - 注意: 此时的文件虽然是二进制,但还不能独立运行,因为像
printf这类标准库函数的具体地址还没有绑定。
- 将文本格式的汇编指令翻译成计算机真正能理解的
4. 链接 (Linking)
- 命令:
gcc main.o -o main - 输入输出:
main.o(及其他目标文件或.so/.a库文件) →main(可执行文件) - 实质: 打包拼装与地址重定位。
- 将你写的多个
.o文件与系统提供的 C 运行时库(如libc.so)打包拼接在一起。 - 解决外部符号引用(找到
printf在系统库里的实际入口地址),生成操作系统可以直接加载运行的程序。
- 将你写的多个
编译连接原理
为了彻底搞懂构建过程,我们抛开 CMake,直接用最基础的命令行,顺着“源码 → 目标文件 → 链接 → 装载”的主线,解剖 main.cpp 和 add.cpp 的真实命运。
// add.cpp
int add(int a, int b) {
    return a + b;
}

// main.cpp
#include <iostream>
int add(int a, int b); // 声明

int main() {
    std::cout << "10 + 20 = " << add(10, 20) << std::endl;
    return 0;
}main.cpp 中 int add(int a, int b); 是一句声明,它向编译器保证:“别管去哪找,这个函数肯定存在,它的参数和返回值是这样的,你先放行。” 真正的定义(机器逻辑)则躺在 add.cpp 里。
编译阶段
执行以下命令,加上 -c 参数告诉编译器:只编译,不链接。
g++ -c main.cpp -o main.o
g++ -c add.cpp -o add.o此时生成了两个可重定位目标文件(.o)。它们已经是机器码,但还不能运行。我们可以用 nm 命令偷窥一下 main.o 的内部符号表:
nm -C main.o核心输出只有两种状态(T 和 U):
0000000000000000 T main:T (Text) 代表“我这里有这个函数的实现代码”。U add(int, int):U (Undefined) 代表“我需要调用这个函数,但我不知道它在哪”。
同理,查看 add.o:
0000000000000000 T add(int, int):明确表示“我有add的代码”。
阶段总结:编译阶段,各个 .cpp 文件各自为战。main.o 是个带着空缺的拼图,它知道自己需要 add,但不知道 add 的真实内存地址,只能先留下一个 U 的记号。
链接阶段
执行链接命令:
g++ main.o add.o -o hello链接器(Linker)此时登场,它主要干了三件惊天动地的事:
符号解析(Symbol Resolution):
链接器看到
main.o喊着U add(我缺 add),立刻去其他文件里找,发现add.o举手说T add(我有 add),于是成功将它们匹配。段合并(Section Merging):
.o文件内部划分了不同的数据区(.text存代码,.rodata存常量)。链接器会把main.o的.text和add.o的.text拼接到一起,形成最终可执行文件的大.text段。地址重定位(Relocation):
在
.o文件中,main和add的初始地址都是相对地址0x0000(各自在自己的小地图里)。链接器把它们拼成大地图后,赋予了真实的全局地址(例如main分配到0x1189,add分配到0x11e8),并回头把main.o中调用add的占位符替换成真正的0x11e8。
静态链接与动态链接
如果你此时查看最终生成的 main 文件:
nm -C hello你会惊讶地发现,虽然 add 变成了 T(已解决),但里面依然存在大量未解决的 U:
U std::coutU __libc_start_main
既然是最终可执行文件,为什么还有 U?
这就自然引出了链接的两种终极形态:
- 静态链接(刚才
add.o的做法):我们自己写的add.o被完整拷贝进了hello里,这种物理打包就是静态链接(对应的库叫.a或.lib)。 - 动态链接(
std::cout的做法):C++ 标准库和系统底层接口太庞大了,如果全塞进程序里,文件会大得离谱。所以链接器允许hello保留这些U。当你在终端敲下./hello时,操作系统的动态链接器会在程序载入内存的瞬间,去系统目录里找到libstdc++.so和libc.so,映射进内存,填补最后这些缺失的地址。
目标文件
目标文件由汇编器和链接器创建,是文本程序的二进制形式,可以直接在处理器上运行。那些需要虚拟机才能够执行的程序 (Java) 不属于这一范围。
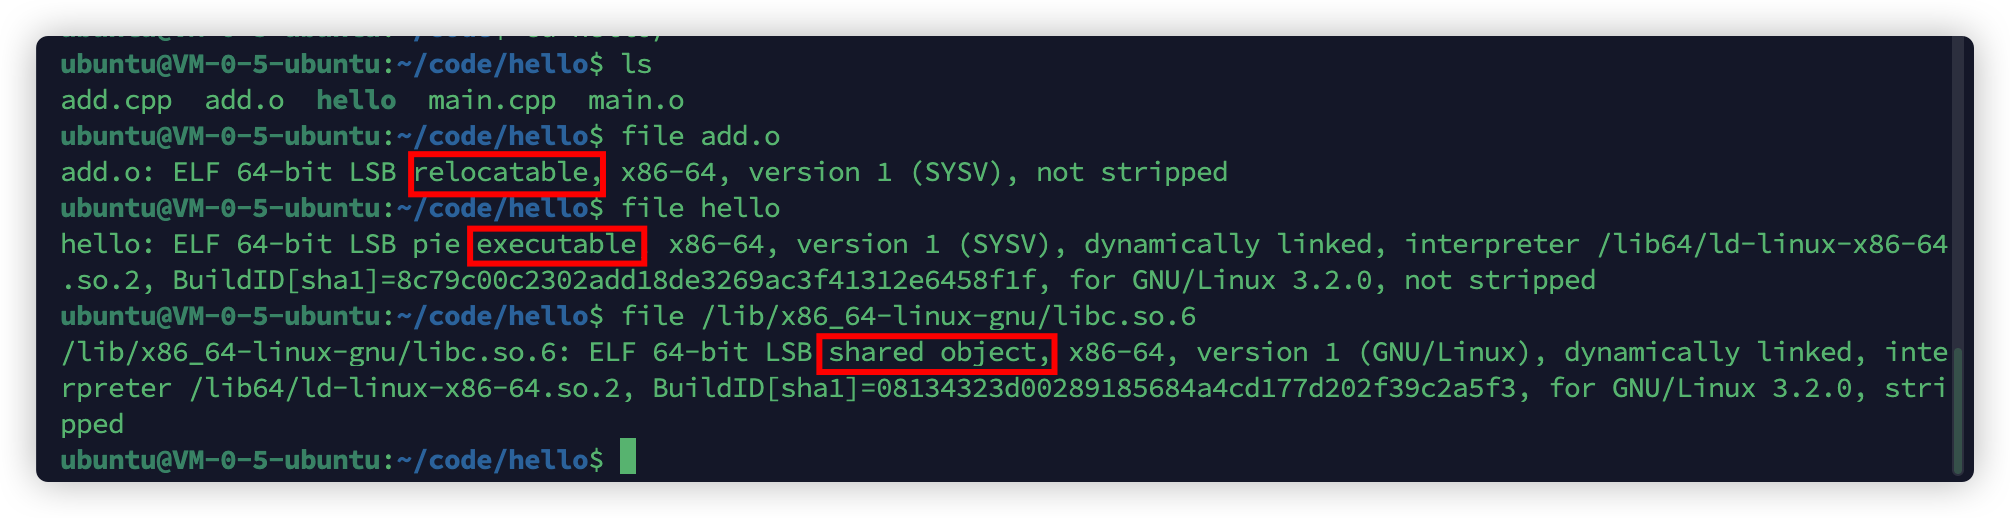
可重定位目标文件(Relocatable Object File,*.o)
- 由源文件(如
.c、.cpp)经过编译生成。 - 包含已经编译好的代码和数据,但其中部分符号的地址尚未确定。
- 可以与其他可重定位目标文件组合,通过链接形成可执行目标文件或共享目标文件。
可执行目标文件(Executable Object File,a.out)
- 经过链接器将一个或多个可重定位目标文件组合生成。
- 代码和数据已经完成相应的地址分配,可以由操作系统加载到内存并执行。
- Linux 下通常为 ELF 可执行文件,Windows 下通常为 PE 格式的
.exe文件。
共享目标文件(Shared Object File,*.so)
- 一种特殊的可重定位目标文件。
- 可以在程序加载时或运行时被加载到内存,并与程序进行动态链接。
- Linux 下通常使用
.so作为文件扩展名,例如libc.so。 - Windows 中对应的概念通常称为动态链接库(DLL,Dynamic Link Library),文件扩展名为
.dll。
ELF(Executable and Linkable Format)主要是 Linux/Unix 世界使用的二进制文件格式。macOS 和 Windows 通常不用 ELF,而是各自有自己的格式。可以先记住这一张表:
| 操作系统 | 主要二进制文件格式 | 常见后缀/形式 |
|---|---|---|
| Linux | ELF | 无后缀、.o、.so |
| macOS | Mach-O | 无后缀、.o、.dylib、.bundle |
| Windows | PE/COFF | .exe、.dll、.obj |
ELF文件格式
我们以linux下的文件格式ELF作为介绍,andorid系统也会用到,我们可以看到这三种文件均是ELF文件
目标文件既会参与程序链接又会参与程序执行。出于方便性和效率考虑,根据过程的不同,目标文件格式提供了其内容的两种并行视图,如下
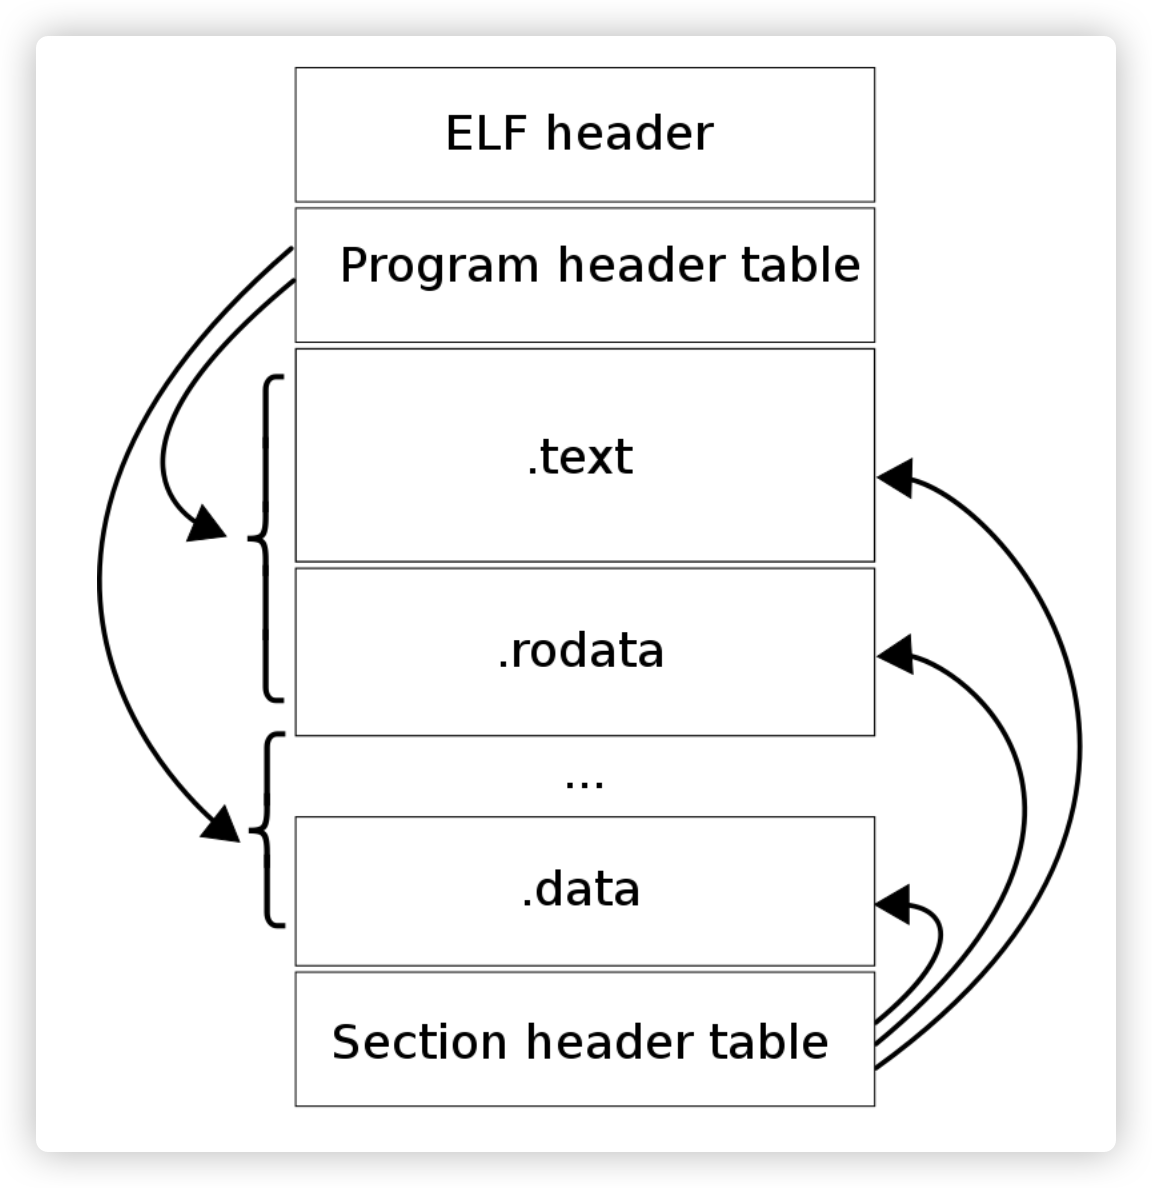
执行视图:当文件装载进内存时,操作系统出于内存对齐和权限防护(如可读、可写、可执行)的考虑,将多个权限相同的 Section 归类合并为粒度较大的 Segment(段),这套内存映射蓝图则存放在 Program Header Table(程序头表) 中。
链接视图:文件由众多粒度较细的 Section(节) 构成,用于按功能(如代码、只读数据、BSS)区分内容,其索引信息存放在 Section Header Table(节头表) 中。
ELF Header
ELF 文件头(ELF Header)位于整个 ELF 文件的最前端,物理位置固定占用文件前 64 字节(64 位架构)。它是操作系统的“文件身份证”与“导航蓝图”,包含了校验文件有效性、确定目标硬件架构、定位程序入口以及寻址节头表(Section Header Table)和程序头表(Program Header Table)所需的一切元数据。
通过执行 readelf -h 命令,我们可以直接提取 ELF 文件头的内容。以下针对未链接的中间产物 add.o(可重定位文件)与链接后的最终产物 hello(可执行文件)进行对比解读。
可执行文件的文件头
ubuntu@VM-0-5-ubuntu:~/code/hello$ readelf -h hello
ELF Header:
  Magic:   7f 45 4c 46 02 01 01 00 00 00 00 00 00 00 00 00  # ELF魔数与系统标识(固定16字节,用于确定文件规范与体系)
  Class:                             ELF64              # 架构类别:64位系统
  Data:                              2's complement, little endian # 数据编码:二进制补码,小端序(Little-Endian)
  Version:                           1 (current)        # ELF规范主版本号(当前恒定为1)
  OS/ABI:                            UNIX - System V    # 目标操作系统及应用二进制接口(System V ABI)
  ABI Version:                       0                  # ABI具体版本号
  Type:                              DYN (Position-Independent Executable file) # 文件类型:位置无关可执行文件(PIE)
  Machine:                           Advanced Micro Devices X86-64              # 硬件平台:x86_64 架构
  Version:                           0x1                # 文件版本号
  Entry point address:               0x10a0             # 程序执行入口(内存虚拟地址,指向 _start)
  Start of program headers:          64 (bytes into file) # 程序头表(PHT)在物理文件中的偏移量(紧跟文件头后)
  Start of section headers:          14624 (bytes into file) # 节头表(SHT)在物理文件中的偏移量(位于文件末尾附近)
  Flags:                             0x0                # 处理器特定标志位(x86架构通常为0)
  Size of this header:               64 (bytes)         # ELF文件头自身固定的物理尺寸(64字节)
  Size of program headers:           56 (bytes)         # 程序头表单个表项(Segment Entry)的大小
  Number of program headers:         13                 # 程序头表项数量(即包含 13 个 Segment)
  Size of section headers:           64 (bytes)         # 节头表单个表项(Section Entry)的大小
  Number of section headers:         31                 # 节头表项数量(即包含 31 个 Section)
Section header string table index: 30 # 存储节名字符串表(.shstrtab)的Section索引号可重定位文件头
ubuntu@VM-0-5-ubuntu:~/code/hello$ readelf -h add.o
ELF Header:
  Magic:   7f 45 4c 46 02 01 01 00 00 00 00 00 00 00 00 00  # 魔数与hello完全相同,证明遵循相同的底层文件规范
  Class:                             ELF64              # 同样编译为 64位 格式
  Data:                              2's complement, little endian # 小端序
  Version:                           1 (current)
  OS/ABI:                            UNIX - System V
  ABI Version:                       0
  Type:                              REL (Relocatable file) # 文件类型:可重定位文件(未链接的中间目标文件)
  Machine:                           Advanced Micro Devices X86-64
  Version:                           0x1
  Entry point address:               0x0                # 无入口地址(未完成符号解析与重定位,无法独立执行)
  Start of program headers:          0 (bytes into file)# 无程序头表(物理偏移量为0,不存在执行视图)
  Start of section headers:          472 (bytes into file) # 节头表(SHT)在物理文件中的起始偏移量
  Flags:                             0x0
  Size of this header:               64 (bytes)         # 文件头固定占用64字节
  Size of program headers:           0 (bytes)          # 程序头表表项尺寸为0
  Number of program headers:         0                  # 程序头表表项数量为0(无Segment概念)
  Size of section headers:           64 (bytes)         # 节头表单个表项的大小(64字节)
  Number of section headers:         12                 # 节头表项数量(包含 12 个 Section)
Section header string table index: 11 # 节名字符串表(.shstrtab)索引号为11其实上面我们通过nm命令就看了ELF文件的内部的信息了ELF 文件全是 0 和 1 的二进制数据,你用普通的文本编辑器(比如记事本)打开只会看到一堆乱码。nm 命令看的就是 ELF 文件内部的特定内容——符号表(Symbol Table)。
在 Linux 世界里,探究 ELF 文件内部内容通常有三个经典的工具,它们各司其职:
nm:专门看符号表(是谁?在哪?缺谁?)。objdump(尤其是objdump -d):专门看.text代码段,它能把机器码反汇编成人类能看懂的汇编语言。readelf:这是最全能的 ELF 解剖刀。比如readelf -S可以列出 ELF 里面的所有“房间”(Section),readelf -h可以看文件头(比如它是为 x86 还是 ARM 编译的)。
所以,你前面看到 U add 和 T main,就是 nm 从 ELF 文件的符号表中读取并为你呈现的底层真相。
接下来我们就用这几个命令来看看ELF的格式
Section
ubuntu@VM-0-5-ubuntu:~/code/hello$ readelf -S hello
There are 31 section headers, starting at offset 0x3920:

Section Headers:
  [Nr] Name              Type             Address           Offset
       Size              EntSize          Flags  Link  Info  Align
  [ 0]                   NULL             0000000000000000  00000000
       0000000000000000  0000000000000000           0     0     0
  [ 1] .interp           PROGBITS         0000000000000318  00000318
       000000000000001c  0000000000000000   A       0     0     1
  [ 2] .note.gnu.pr[...] NOTE             0000000000000338  00000338
       0000000000000030  0000000000000000   A       0     0     8
  [ 3] .note.gnu.bu[...] NOTE             0000000000000368  00000368
       0000000000000024  0000000000000000   A       0     0     4
  [ 4] .note.ABI-tag     NOTE             000000000000038c  0000038c
       0000000000000020  0000000000000000   A       0     0     4
  [ 5] .gnu.hash         GNU_HASH         00000000000003b0  000003b0
       0000000000000028  0000000000000000   A       6     0     8
  [ 6] .dynsym           DYNSYM           00000000000003d8  000003d8
       0000000000000120  0000000000000018   A       7     1     8
  [ 7] .dynstr           STRTAB           00000000000004f8  000004f8
       0000000000000167  0000000000000000   A       0     0     1
  [ 8] .gnu.version      VERSYM           0000000000000660  00000660
       0000000000000018  0000000000000002   A       6     0     2
  [ 9] .gnu.version_r    VERNEED          0000000000000678  00000678
       0000000000000060  0000000000000000   A       7     2     8
  [10] .rela.dyn         RELA             00000000000006d8  000006d8
       00000000000000f0  0000000000000018   A       6     0     8
  [11] .rela.plt         RELA             00000000000007c8  000007c8
       0000000000000048  0000000000000018  AI       6    24     8
  [12] .init             PROGBITS         0000000000001000  00001000
       000000000000001b  0000000000000000  AX       0     0     4
  [13] .plt              PROGBITS         0000000000001020  00001020
       0000000000000040  0000000000000010  AX       0     0     16
  [14] .plt.got          PROGBITS         0000000000001060  00001060
       0000000000000010  0000000000000010  AX       0     0     16
  [15] .plt.sec          PROGBITS         0000000000001070  00001070
       0000000000000030  0000000000000010  AX       0     0     16
  [16] .text             PROGBITS         00000000000010a0  000010a0
       0000000000000160  0000000000000000  AX       0     0     16
  [17] .fini             PROGBITS         0000000000001200  00001200
       000000000000000d  0000000000000000  AX       0     0     4
  [18] .rodata           PROGBITS         0000000000002000  00002000
       0000000000000012  0000000000000000   A       0     0     4
  [19] .eh_frame_hdr     PROGBITS         0000000000002014  00002014
       000000000000003c  0000000000000000   A       0     0     4
  [20] .eh_frame         PROGBITS         0000000000002050  00002050
       00000000000000d4  0000000000000000   A       0     0     8
  [21] .init_array       INIT_ARRAY       0000000000003d90  00002d90
       0000000000000008  0000000000000008  WA       0     0     8
  [22] .fini_array       FINI_ARRAY       0000000000003d98  00002d98
       0000000000000008  0000000000000008  WA       0     0     8
  [23] .dynamic          DYNAMIC          0000000000003da0  00002da0
       0000000000000200  0000000000000010  WA       7     0     8
  [24] .got              PROGBITS         0000000000003fa0  00002fa0
       0000000000000060  0000000000000008  WA       0     0     8
  [25] .data             PROGBITS         0000000000004000  00003000
       0000000000000010  0000000000000000  WA       0     0     8
  [26] .bss              NOBITS           0000000000004040  00003010
       0000000000000118  0000000000000000  WA       0     0     64
  [27] .comment          PROGBITS         0000000000000000  00003010
       000000000000002d  0000000000000001  MS       0     0     1
  [28] .symtab           SYMTAB           0000000000000000  00003040
       0000000000000450  0000000000000018          29    22     8
  [29] .strtab           STRTAB           0000000000000000  00003490
       0000000000000375  0000000000000000           0     0     1
  [30] .shstrtab         STRTAB           0000000000000000  00003805
       000000000000011a  0000000000000000           0     0     1
Key to Flags:
  W (write), A (alloc), X (execute), M (merge), S (strings), I (info),
  L (link order), O (extra OS processing required), G (group), T (TLS),
  C (compressed), x (unknown), o (OS specific), E (exclude),
D (mbind), l (large), p (processor specific)最核心的 ELF Section 只有以下 6 个:
| Section 名称 | 核心作用 | 内存权限 | 磁盘占用 |
|---|---|---|---|
.text | 存放编译后的 CPU 机器指令(如 main 函数代码)。 | 可读、可执行 | 占用 |
.rodata | 存放只读常量(如字符串 "Hello World"、const 全局变量)。 | 只读 | 占用 |
.data | 存放显式初始化且值不为 0 的全局/静态变量(如 int a = 10;)。 | 可读、可写 | 占用 |
.bss | 存放未初始化或初始化为 0 的全局/静态变量(如 int b[100];)。 | 可读、可写 | 不占用(仅标记所需内存大小,加载时自动清零) |
.got / .plt | 动态链接表,负责运行时跳转并调用 C 标准库函数(如 printf)。 | 混合 | 占用 |
.symtab | 符号表,记录函数名、变量名及其内存地址对应关系,供 gdb 调试使用。 | 不装载 | 占用 |
一句话记忆口诀
- 代码看
.text:程序怎么跑。 - 常量看
.rodata:只读不改。 - 变量分两家:有初值存
.data,没初值存.bss(只占内存不占体积)。 - 调库靠
.got/.plt:找到printf的真实地址。 - 调试找
.symtab:记录所有函数和变量的名字(执行strip命令删掉的就是它)。
评论区
欢迎分享你的思考、补充或问题。