从基础开始学习 PySyft
让我们从基础开始,学习如何使用 PySyft。在本教程中,我们将逐步介绍 PySyft 启用的数据科学工作流的主要步骤,并学习 PySyft 如何在不获取或查看数据副本的情况下对非公开数据进行数据科学分析。
示例:乳腺癌数据研究
没有什么比通过实际的用例学习更好的方式了!
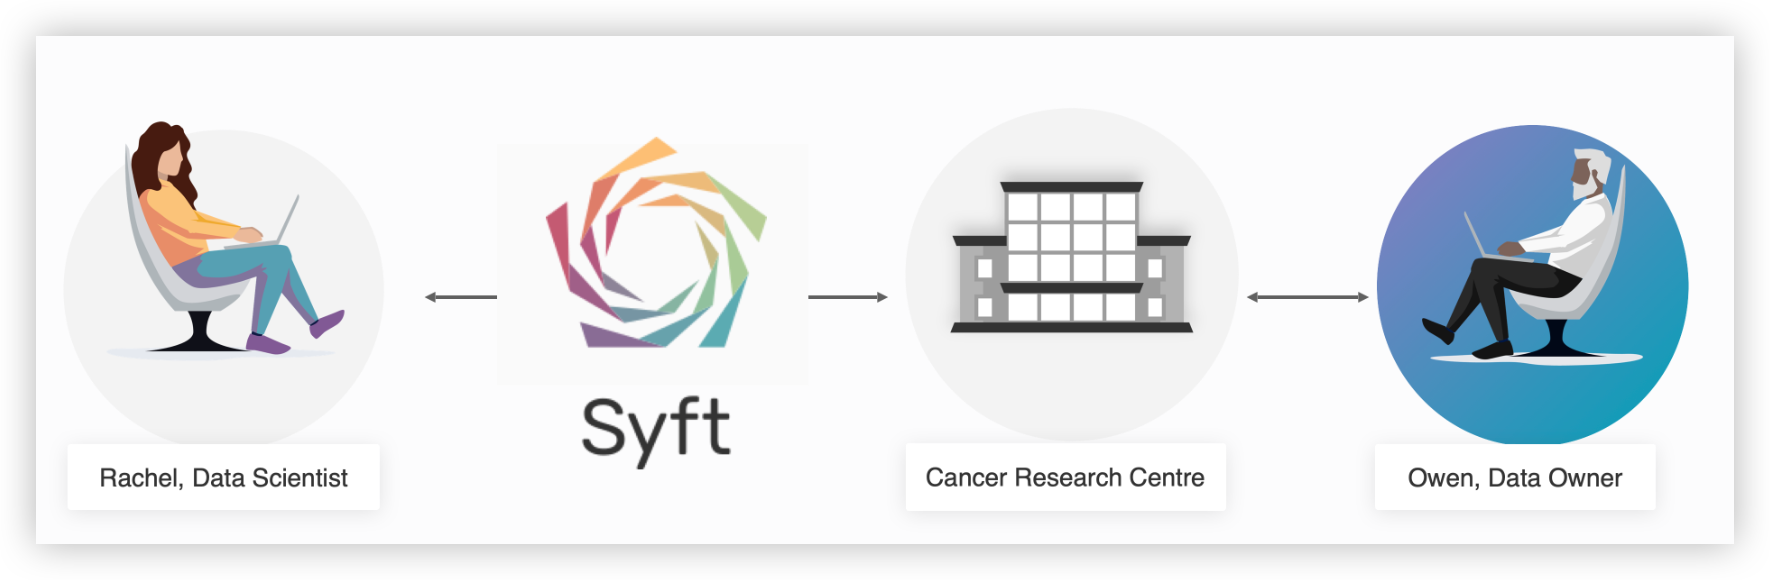
在本教程中,我们将使用 PySyft 来研究乳腺癌数据。在我们的场景中——简要总结如下图所示——将有两个主要角色:
Rachel,数据科学家:
Rachel 是一名数据科学家和研究员,正在进行一个项目,使用机器学习来研究乳腺癌数据。为此,Rachel 想要使用(非公开的)“乳腺癌生物标志物”数据集,这个数据集已经在癌症研究中心的 Datasite 上提供。
Owen,数据拥有者:
Owen 是癌症生物标志物研究小组的实验室数据经理。Owen 负责组织和管理从匿名化患者样本中收集的临床数据。由于法律和监管的限制,这个数据集不能公开提供,任何副本也不能离开他们研究中心的场地。然而,Owen 非常愿意允许研究人员将“乳腺癌生物标志物”数据集用于他们的项目。因此,Owen 设置了一个 PySyft Datasite 来托管该数据集。作为数据拥有者,Owen 将负责:
- 上传数据
- 管理凭证和用户资料
- 审查任何外部数据科学家提交的项目提案
数据科学工作流
我们为本教程选择的用例场景将帮助我们深入了解 PySyft 启用的数据科学工作流的各个步骤:
步骤 1:Owen 设置新的癌症研究中心 Datasite,通过(a)上传非公开的“乳腺癌生物标志物”数据集,并(b)为 Rachel 配置登录凭证以访问该 Datasite。
步骤 2:Rachel 连接到癌症研究中心;准备他们的机器学习代码以使用“乳腺癌生物标志物”数据集;并将他们的研究提案提交给 Datasite。
步骤 3:Owen,作为 Datasite 的数据所有者,收到请求并审查 Rachel 的代码以供批准。
步骤 4:一旦获得批准,Rachel 就能够在 Datasite 上远程执行代码,并使用“乳腺癌数据集”获取他们的机器学习研究结果。
总结,通过使用 PySyft:
- Owen 通过允许 Rachel 在隐私保障下使用“乳腺癌生物标志物”数据集进行研究,解锁了 Rachel 的研究。
- Rachel 能够通过 PySyft 在不查看数据本身的情况下,远程运行代码并使用“乳腺癌生物标志物”数据集。
在本教程中,我们将学习 如何! 🤓
教程结构 本教程将分为 五个部分。每个部分将集中于数据科学工作流的一个步骤,并强调 PySyft 的所有相关功能。在每个部分的开始,学习目标将被强调,并说明完成每个部分所需的预期成就。
- 第一部分:数据集和资源
- 第二部分:客户端和Datasite访问
- 第三部分:提交研究提案
- 第四部分:审查代码请求
- 第五部分:获取结果
准备工作 我们假设您已安装了 PySyft。您可以通过在终端提示符中运行以下命令来查看 PySyft 是否已安装以及其版本(通常用 $ 符号表示):
$ python -c "import syft; print(syft.__version__)"如果 PySyft 已安装,您应该会看到安装版本。如果没有,您会收到一个 Python 错误,提示 ModuleNotFoundError: No module named 'syft'。
本教程适用于 PySyft 0.9 版本,支持 Python 3.10 或更高版本。
有关如何快速安装 PySyft 的更多信息,或者如果您使用的是 PySyft 的旧版本,请参考 PySyft 快速安装指南。
评论区
欢迎分享你的思考、补充或问题。