第1部分:数据集与资产
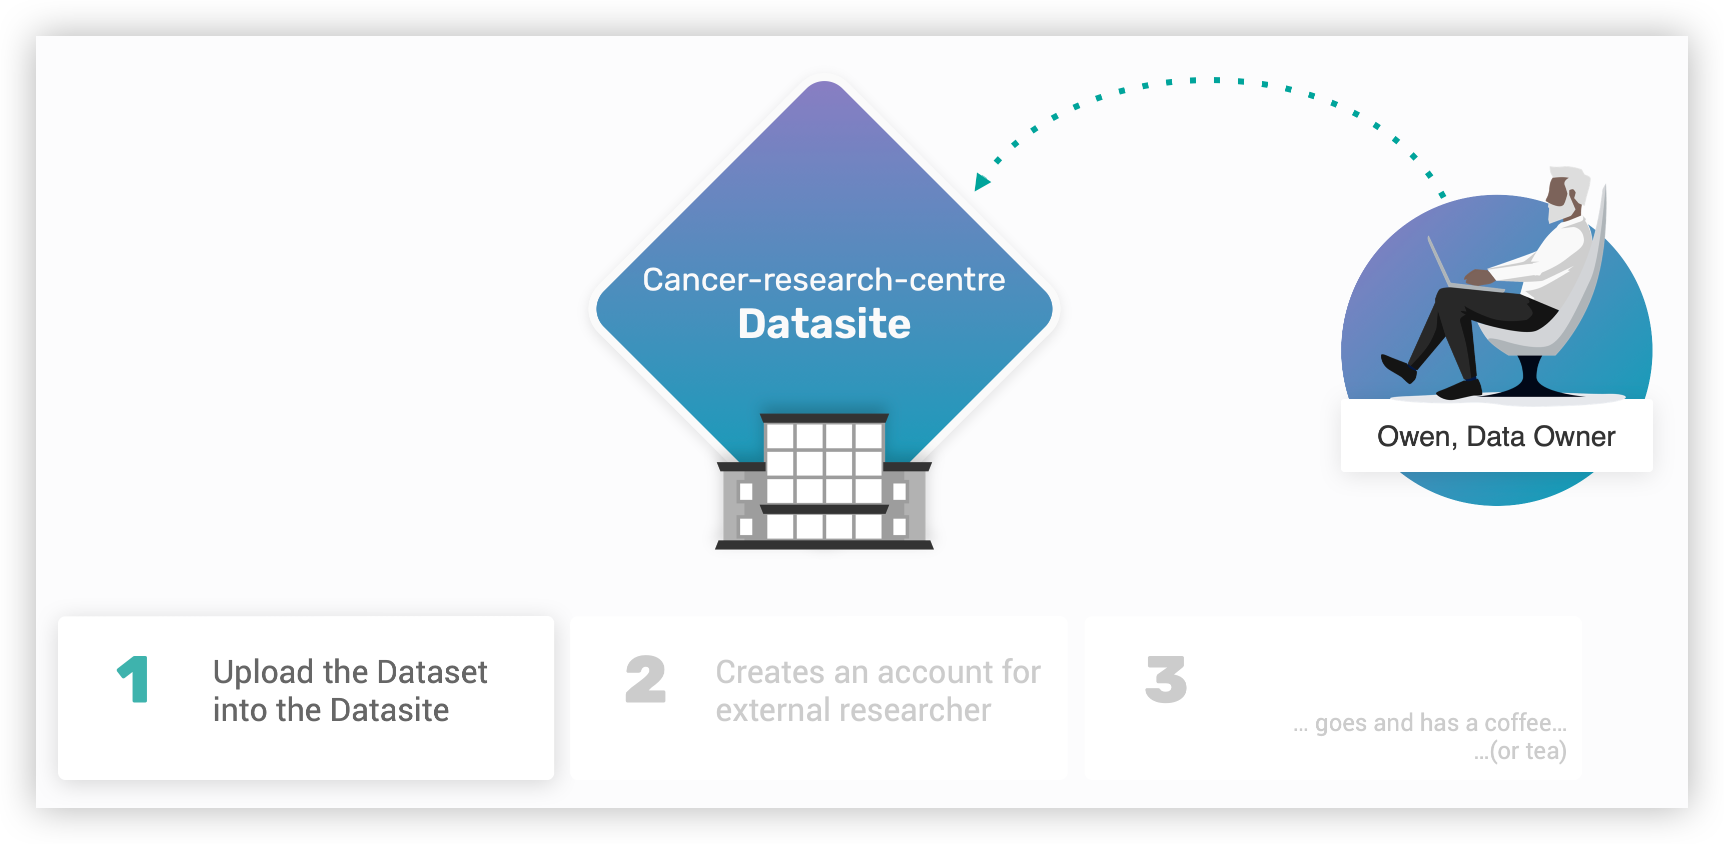
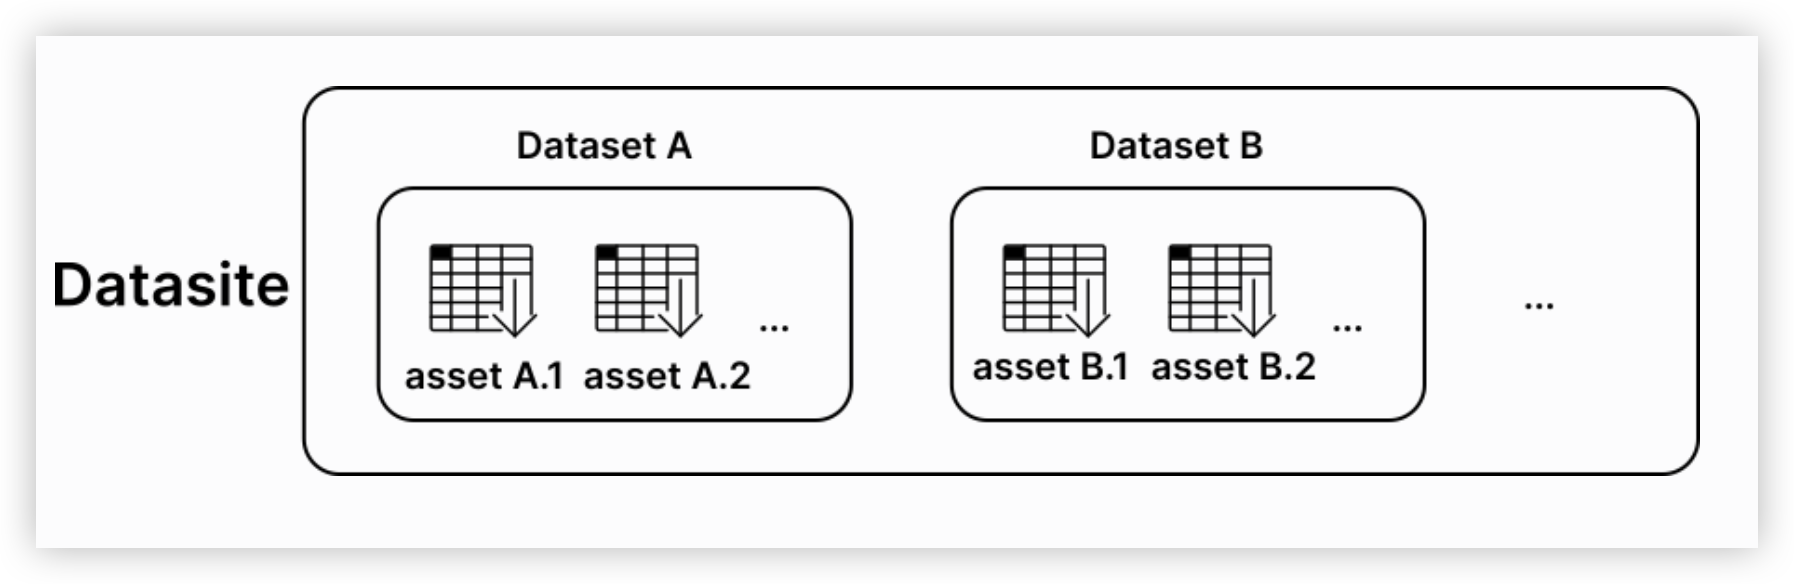
如果你是 PySyft 的新用户,那么需要了解一个关键词:Datasite。Datasite 类似于网站,但主要是为了数据服务。传统的 Web 服务器允许下载文件(例如 .html 和 .css 文件)到浏览器,而 Datasite 不会这样做。相反,Datasite 帮助数据科学家从服务器中的数据中获取 问题的答案,而无需下载实际的数据本身。Datasite 中的数据以 数据集 的形式提供,每个数据集包含多个资产。在本教程的第一部分中,我们将学习如何创建和上传资产以及数据集到 Datasite。
你将学到什么?
到第1部分结束时,你将掌握以下技能:
- 如何使用 PySyft 快速启动本地 Datasite;
- 如何创建和配置包含公共信息与非公共信息的资产;
- 如何将数据集上传到 Datasite。
1.1 启动本地开发环境的 Datasite
你可以通过以下三种方式启动 Datasite 服务器:
- 使用
syft.orchestra.launch:适合本地开发; - 使用单容器(Docker 或 Podman):适合轻量化部署;
- 使用 Kubernetes:适合生产环境。
在本教程中,我们将使用 syft.orchestra.launch。有关 Datasite 和部署选项的更多信息,请参阅文档中的相关章节。
首先导入 syft(在本教程中,我们将使用这种编码约定):
import syft as sysyft.orchestra.launch 函数运行一个特殊的本地 Datasite 服务器,仅供开发使用。每个服务器通过其唯一名称标识,PySyft 使用该名称在重启时恢复其内部状态。我们将使用 reset=True 参数确保服务器实例是第一次初始化。
data_site = sy.orchestra.launch(name="cancer-research-centre", reset=True)当服务器启动并运行后,我们可以登录到 Datasite:
client = data_site.login(email="info@openmined.org", password="changethis")TIP
管理用户账户
作为第一步,Owen 将使用默认管理员凭据登录 Datasite。在第2部分中,我们将学习如何更新和个性化这些凭据,以及如何管理用户账户。
1.2 下载示例数据集
我们将使用 ucimlrepo Python 包来下载示例数据集,可以通过以下命令安装:
$ pip install ucimlrepo确保使用正确的 Python 环境
请确认在安装该包时,PySyft 也在同一个 Python 环境中。具体操作见快速安装指南。
安装完成后,使用以下代码下载数据集:
from ucimlrepo import fetch_ucirepo

# 获取数据集
breast_cancer_wisconsin_diagnostic = fetch_ucirepo(id=17)

# 数据(以 pandas dataframe 格式表示)
X = breast_cancer_wisconsin_diagnostic.data.features
y = breast_cancer_wisconsin_diagnostic.data.targets

# 元数据
metadata = breast_cancer_wisconsin_diagnostic.metadata
# 变量信息
variables = breast_cancer_wisconsin_diagnostic.variables我们将使用广受欢迎的乳腺癌数据集模拟 Owen 的“乳腺癌生物标志物”数据集。
X.head(n=5) # n 指定预览的行数该数据集包含 596 个样本,组织为 30 个临床特征(即 X)。
X.shape每个样本对应一个分类目标,表示肿瘤的结果:B 表示良性,M 表示恶性:
y.sample(n=5, random_state=10)1.3 创建资产和数据集
在本教程开头,我们提到 PySyft 允许在不下载数据或查看数据副本的情况下使用数据。不过你可能会疑惑:
- 数据科学家在没有数据的情况下如何编写代码?
- 他们甚至如何开始?🤔
PySyft 通过托管两类数据解决这个问题:
- 真实数据(稍后会详细介绍);
- 模拟数据,即真实数据的虚拟版本,数据科学家可以下载并查看。
创建模拟数据(Mock)
在将数据集上传到数据站点 (Datasite) 之前,Owen 需要为其数据创建一个模拟版本。以下是具体操作:
import numpy as np

# 设置随机种子以保证可重复性
SEED = 12345
np.random.seed(SEED)

X_mock = X.apply(lambda s: s + np.mean(s) + np.random.uniform(size=len(s)))
y_mock = y.sample(frac=1, random_state=SEED).reset_index(drop=True)- 临床特征
X_mock是通过对原始特征X的每一列加上其算术平均值和正态分布中的一些随机噪声生成的。 - 类别目标
y_mock则通过对原始目标值进行简单的随机重排生成。
这样处理后,数据类型和类别分布保持不变,同时消除了样本中的任何可能模式。
TIP
生成模拟数据的注意事项
决定何种模拟数据方案是否合适取决于具体的使用场景和数据集。最终,这种选择应由数据所有者决定,以确保满足预期的数据使用需求。在我们的示例中,Owen 决定上述生成方法足以避免从真实数据中泄露任何私人信息。
创建资产 (Assets)
在拥有真实数据和模拟数据后,我们可以在 PySyft 中创建相应的资产 (Assets),每个资产都由其在数据站点中的唯一名称标识:
features_asset = sy.Asset(
    name="Breast Cancer Data: Features",
    data = X,      # 真实数据
    mock = X_mock  # 模拟数据
)

targets_asset = sy.Asset(
    name="Breast Cancer Data: Targets",
    data = y,      # 真实数据
    mock = y_mock  # 模拟数据
)每个资产都包含了对 data 和 mock 的引用,这两者是 syft.Asset 对象的属性,我们可以查看它们的内容:
features_asset.data.head(n=3)
features_asset.mock.head(n=3)创建数据集 (Dataset)
我们已经有了两个资产:features_asset 和 targets_asset。那么,现在是否可以直接将它们上传到数据站点呢?不完全是。
如果我们直接上传这些资产而没有任何额外的信息,外部数据科学家将无法发现或正确使用这些数据。
因此,PySyft 要求每个资产必须作为 syft.Dataset 对象的一部分存储。每个数据集在 PySyft 中都有唯一名称,并包含额外的元数据(如描述、引用、贡献者),以进一步说明核心数据及其资产。
收集元数据并创建数据集对象
# 收集元数据
description = f'{metadata["abstract"]}\n{metadata["additional_info"]["summary"]}'

paper = metadata["intro_paper"]
citation = f'{paper["authors"]} - {paper["title"]}, {paper["published_in"]}, {paper["year"]}'

summary = "The Breast Cancer Wisconsin dataset can be used to predict whether the cancer is benign or malignant."

# 创建数据集
breast_cancer_dataset = sy.Dataset(
    name="Breast Cancer Biomarker",
    description=description,
    summary=summary,
    citation=citation,
    url=metadata["dataset_doi"],
)然后,将两个资产添加到数据集:
breast_cancer_dataset.add_asset(features_asset)
breast_cancer_dataset.add_asset(targets_asset)最后,我们可以通过 PySyft 提供的默认富表示功能查看新创建的数据集对象:
breast_cancer_dataset1.4 上传数据集到数据站点
通过客户端的 upload_dataset 函数,将新数据集上传到数据站点:
client.upload_dataset(dataset=breast_cancer_dataset)上传成功后,可以通过客户端对象查看所有可访问的数据集:
client.datasets1.5 关闭数据站点
完成数据集上传后,可以使用 land 函数关闭运行中的服务器:
data_site.land()恭喜完成第一部分 🎉
在第一部分中,我们学习了如何为“癌症研究中心”设置数据站点。为了简化操作,我们使用 PySyft 提供的本地开发服务器快速在本地机器上托管数据站点。随后,我们创建并上传了一个新的 syft.Dataset,其中包括“乳腺癌生物标志物”数据的特征和目标资产。
在第二部分中,我们将学习如何管理用户凭据以及设置数据站点的访问权限。
评论区
欢迎分享你的思考、补充或问题。