1. 操作系统定义
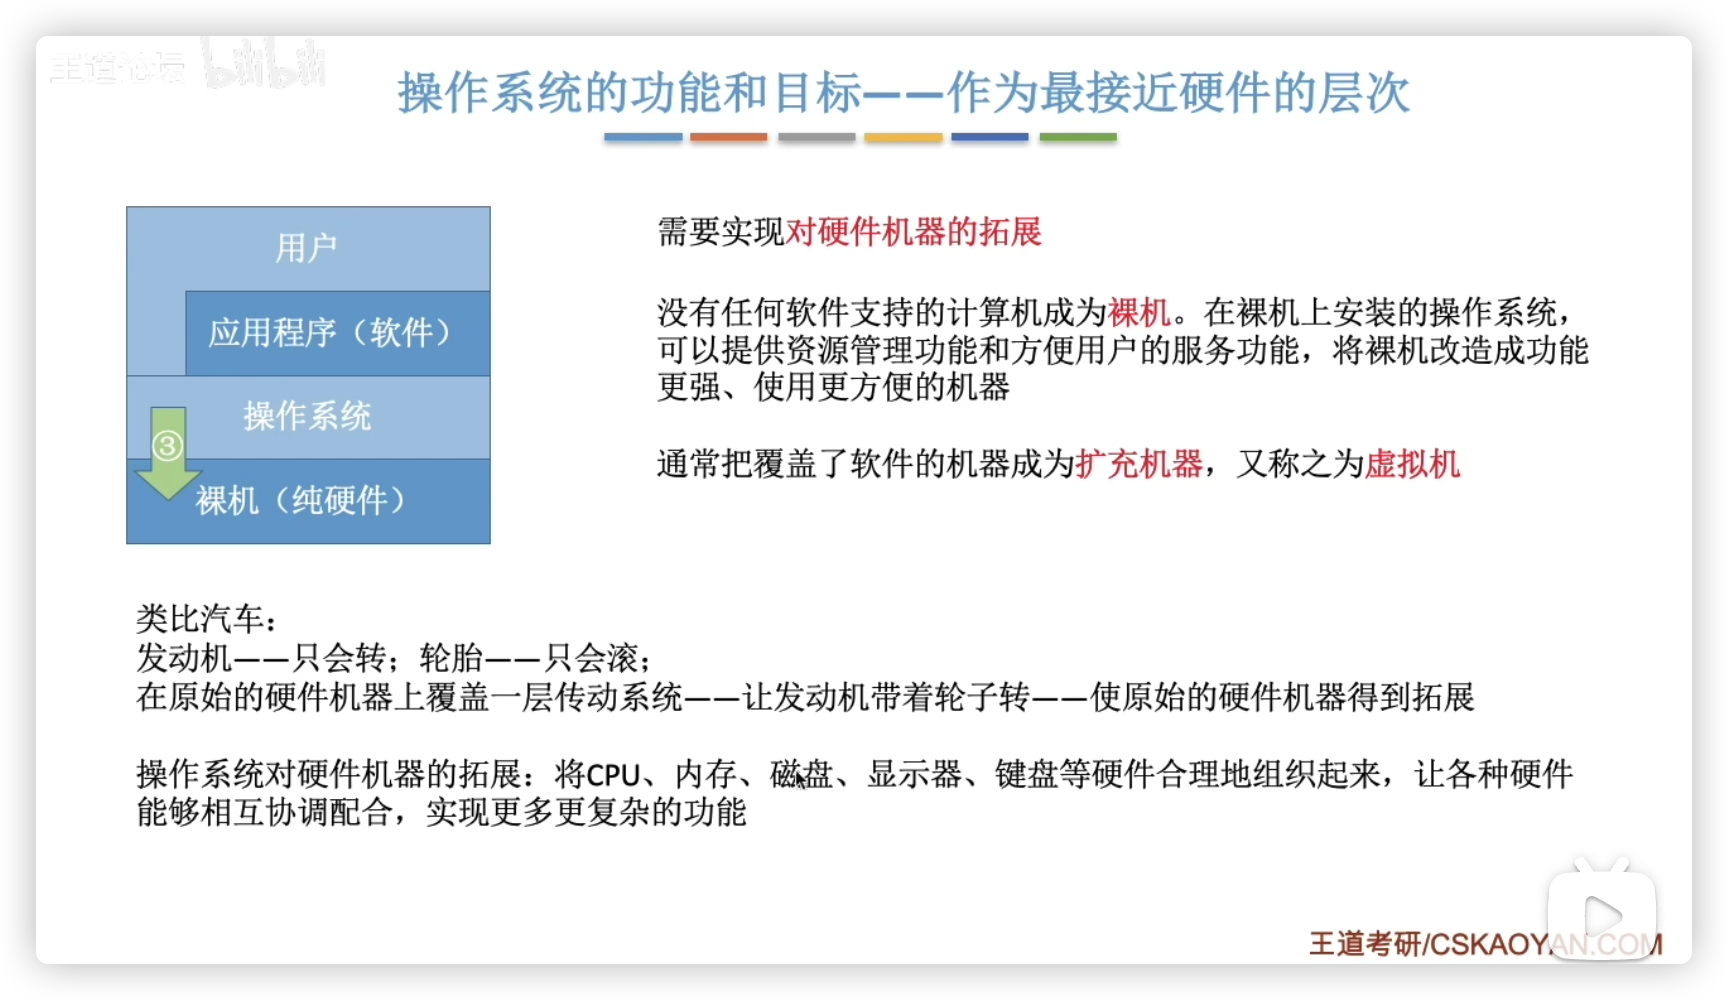
操作系统 (Operating System,OS)是指控制和管理整个计算机系统的硬件和软件资源,并合理地组织调 度计算机的工作和资源的分配;以提供给用户和其他软件方便的接口和环境;它是计算机系统中最基本的系统软件。
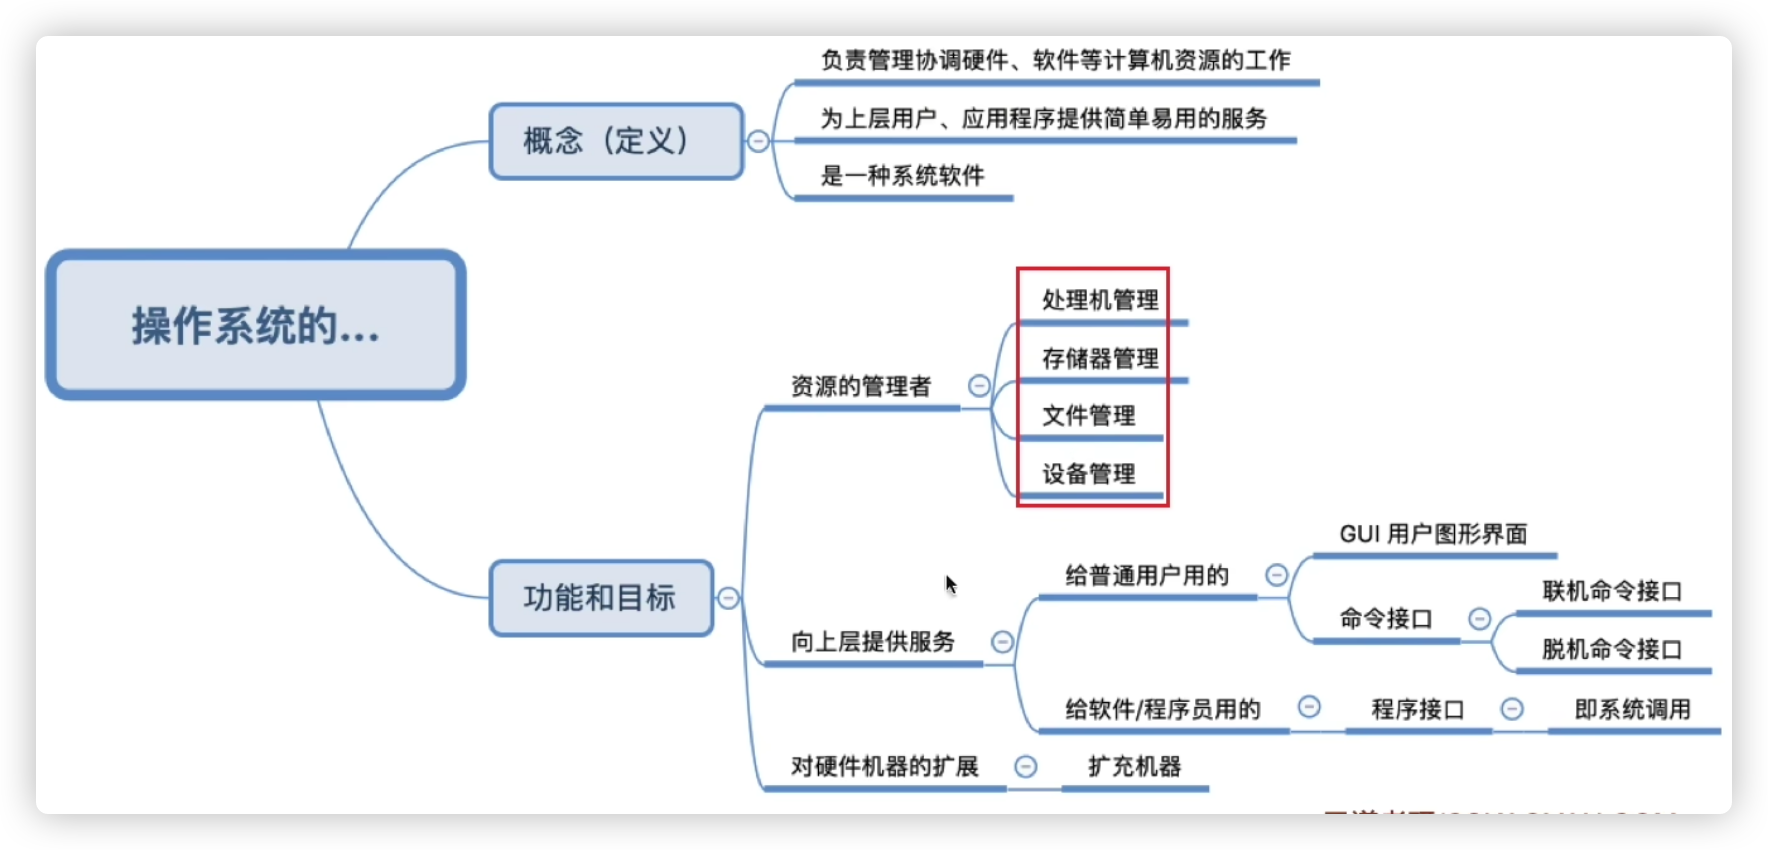
1.1 系统资源的管理者
操作系统负责管理计算机的各种硬件和软件资源,以确保系统的稳定运行和资源的高效利用。主要的资源管理包括:
- 处理器管理:调度进程,使多个任务能够高效地共享CPU(如时间片轮转、优先级调度)。
- 内存管理:分配和回收内存,提供虚拟内存机制,以支持多任务运行。
- 文件管理:提供文件存储、访问和保护机制,支持不同文件系统(如NTFS、EXT4)。
- 设备管理:协调输入输出设备(如磁盘、键盘、打印机)的使用,提供驱动程序支持。
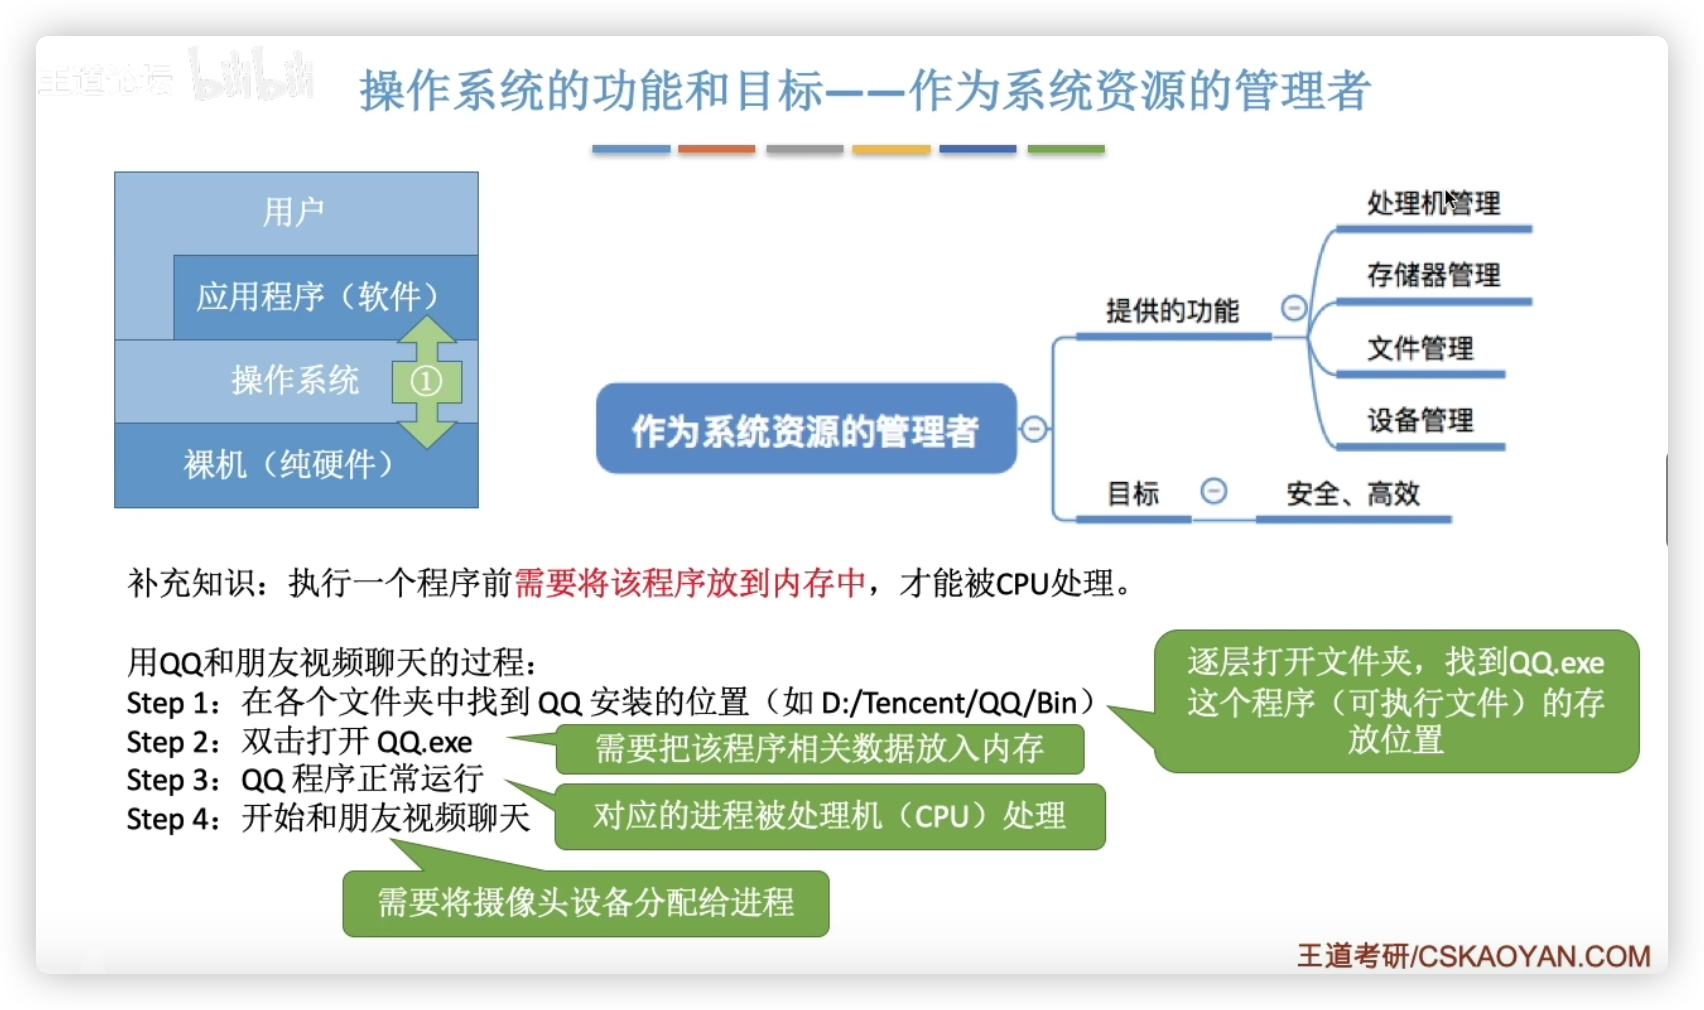
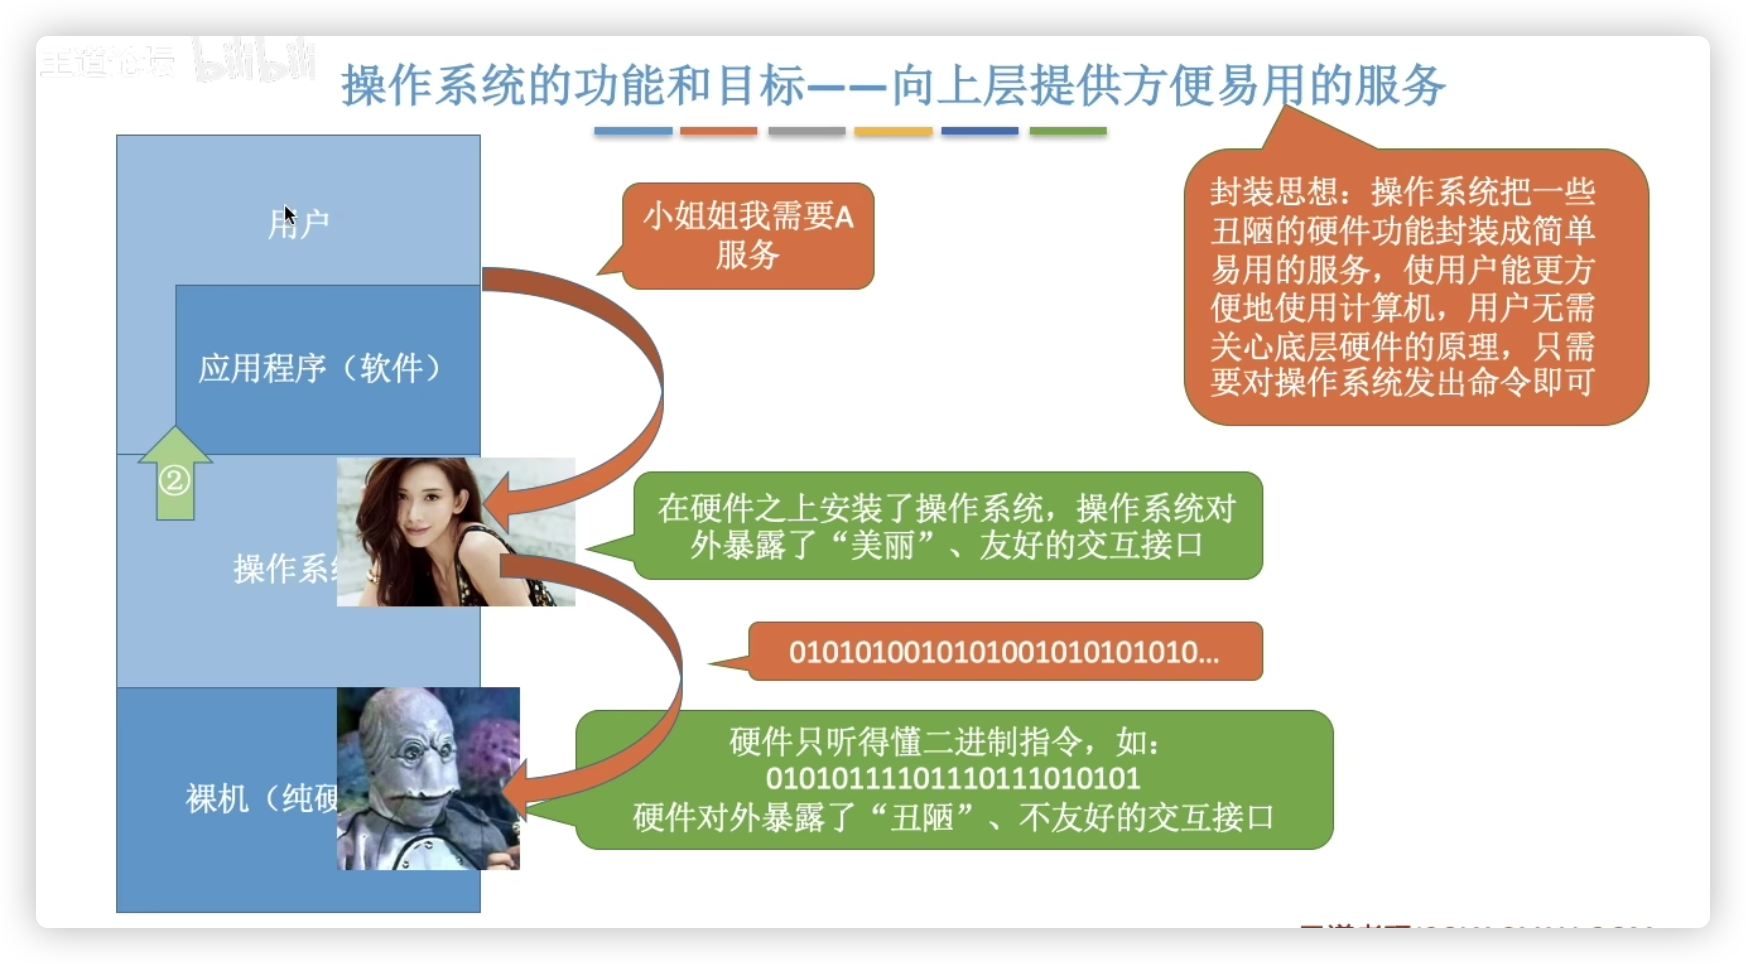
1.2 向上层提供方便易用的接口
操作系统通过系统调用(System Call)和API(Application Programming Interface)向应用程序提供访问硬件资源的能力,使开发者能够专注于软件逻辑,而无需直接操作底层硬件。例如:
- POSIX API(Linux/Unix) 和 WinAPI(Windows) 提供标准化的系统调用接口。
- 进程和线程管理:允许程序创建进程(如
fork()在Unix/Linux上)或管理线程(如pthread)。 - 文件操作:通过
open()、read()、write()等函数访问文件系统。 - 网络通信:提供
socketAPI,使应用程序能够进行网络通信。
1.3 最基本的系统软件
操作系统是计算机系统中最基础的软件,所有其他应用软件都运行在它之上。它的核心组成包括:
- 内核(Kernel):控制系统资源的核心部分,管理CPU、内存、进程、设备等。
- 驱动程序(Device Drivers):用于操作特定硬件设备的程序,使操作系统能与各种外设交互。
- 系统库(System Libraries):提供一组标准库函数,简化应用程序的开发(如C标准库
libc)。 - 用户界面(User Interface):包括命令行界面(CLI,如Shell)和图形用户界面(GUI,如Windows桌面环境)。
2. 操作系统的特征
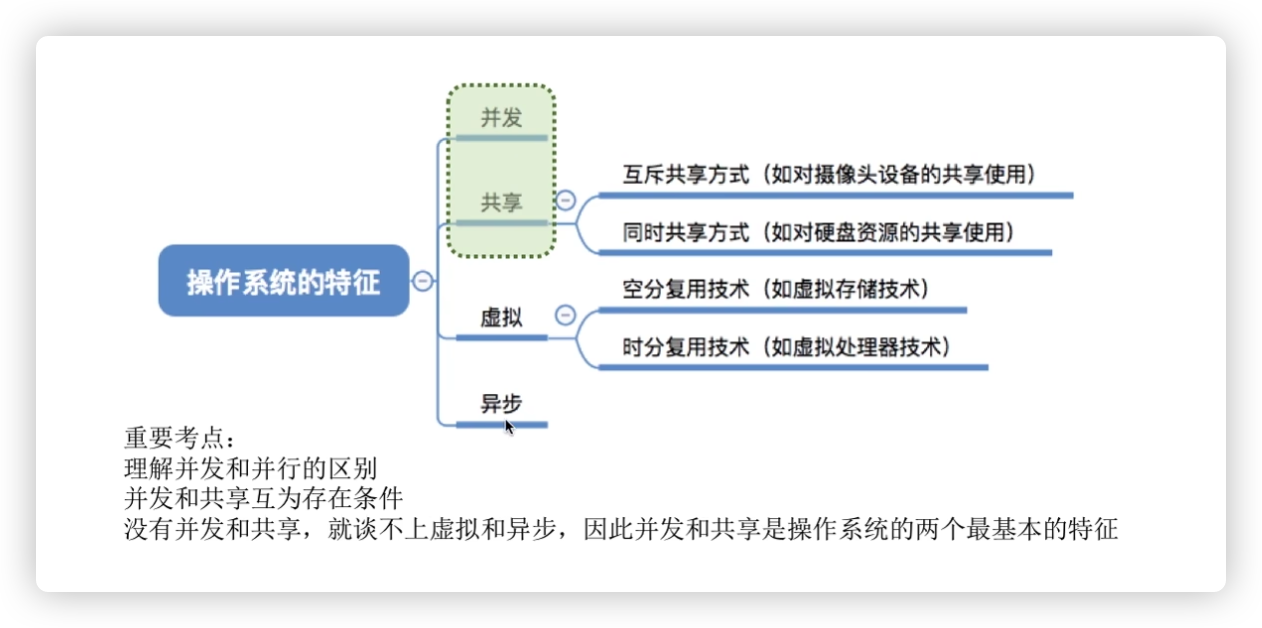
操作系统的四大特征:并发、共享、虚拟和异步。这四大特征相互关联、相互影响:并发导致了共享的需求,共享需要虚拟的支持,而异步则是并发与共享的必然结果。这些特征共同构成了现代操作系统的基础,使计算机系统能够高效、安全地运行。
2.1并发(Concurrency)
定义:并发是指在同一时间间隔内,系统中有多个程序或进程同时执行的特性。
特点:
- 宏观上看,多个程序在同时运行
- 微观上看,CPU通过时间片轮转等机制在多个程序间快速切换
- 与并行(Parallelism)有区别:并行是指多个处理器同时执行多个任务,而并发可以在单处理器上实现
实现机制:
- 进程调度算法
- 进程同步与互斥
- 多线程
意义:提高系统资源利用率和吞吐量
2.2 共享(Sharing)
定义:共享是指系统中的资源可以被多个并发执行的程序或进程同时使用。
共享方式:
- 互斥共享:一个时间段内只允许一个进程访问资源(如打印机)
- 同时共享:多个进程可以同时访问资源(如只读文件)
共享资源:
- 硬件资源:CPU、内存、I/O设备等
- 软件资源:文件、数据、代码等
实现机制:
- 内存管理
- 文件系统
- 临界区管理
- 锁机制
2.3 虚拟(Virtualization)
定义:虚拟是指将物理上的实体资源抽象为逻辑上的对应物,使用户与系统交互时感受不到底层的复杂性。
主要形式:
- 时间虚拟化:CPU时间片轮转使用户感觉程序独占CPU
- 空间虚拟化:虚拟内存使程序感觉拥有连续的大内存空间
虚拟技术:
- 虚拟内存
- 虚拟处理器
- 虚拟设备
- 虚拟机
意义:
- 隐藏硬件细节,简化用户使用
- 扩展物理资源的能力
- 提高资源利用率
2.4 异步(Asynchrony)
定义:异步是指程序的执行不是一次性完成的,而是走走停停,以不可预知的速度向前推进。
特点:
- 程序执行的结果与时间无关
- 进程以人们不可预知的速度向前推进
- 并发程序执行时互相制约
产生原因:
- 系统中各种资源的速度不匹配
- 进程间的相互竞争与协作
- I/O操作与计算操作的速度差异
处理机制:
- 缓冲技术
- 中断机制
- 通信机制
- 同步互斥机制
3. 操作系统运行机制
操作系统(Operating System, OS)是计算机系统中的核心软件,它负责管理硬件资源,并为用户和应用程序提供运行环境。尽管现代操作系统功能繁多,但它们的运行机制主要围绕 指令的执行、处理器状态的管理、程序的分类、特权控制和内核的运行 展开。
3.1 计算机的两种程序
计算机上的软件可以分为两类:
- 内核程序(Kernel Programs)
- 应用程序(Application Programs)
3.11 内核程序
内核程序是操作系统的一部分,运行在 核心态,用于管理计算机资源和提供系统服务。微软、苹果有一帮人负责实现操作系统,他们写的是“内核程序” 。由很多内核程序组成了“操作系统内核”,或简称“内核(Kernel)”。它是操作系统最重要最核心的部分,也是最接近硬件的部分
内核程序的作用:
- 进程管理:调度 CPU,控制进程的创建、销毁和状态切换。
- 内存管理:分配、释放物理内存,维护虚拟内存。
- 文件系统:提供文件的读写、存储和权限控制。
- 设备管理:管理磁盘、网络、显示器等外部设备。
- 系统调用接口:为应用程序提供访问系统资源的方法。
操作系统的核心部分就是 内核(Kernel),它是计算机系统最重要的软件组件。
3.22 应用程序
应用程序是用户运行的软件(如浏览器、视频播放器、游戏等),它们运行在 用户态,必须通过 系统调用 与操作系统交互,通常我们编写的程序。
特点:
- 不能直接访问硬件,只能使用 OS 提供的 API。
- 只能执行非特权指令,确保系统安全。
3.23 内核是操作系统的核心
在现代计算机系统中,内核是操作系统最重要的部分,它直接管理硬件资源并提供系统服务,由很多内核程序组成了操作系统内核。严格来说,一个最小化的操作系统只需要 内核(Kernel),用户可以通过其他方式运行应用程序。例如:
- Docker 只需要 Linux 内核:Docker 并不需要完整的 Linux 发行版,它只依赖 Linux 内核提供的进程调度、文件系统和网络功能即可运行容器化应用。
- 嵌入式系统:许多嵌入式设备(如路由器、智能家居设备)只运行一个精简的 Linux 内核,而不需要完整的 GUI 桌面环境。
3.2 操作系统的两种指令
计算机的指令分为两大类:
- 特权指令(Privileged Instructions)
- 非特权指令(Non-Privileged Instructions)
这两种指令的划分,决定了不同程序在不同处理器状态下的权限,确保系统安全性和稳定性。
3.21 特权指令
特权指令是只有操作系统内核可以执行的指令。这些指令涉及对计算机关键资源(如内存管理、I/O 设备)和安全机制的控制,普通用户程序不能直接调用。
常见特权指令包括:
- 中断管理指令:启用/禁用中断(
cli、sti) - I/O 操作指令:直接访问 I/O 设备
- CPU 状态切换指令:从用户态切换到内核态
- 内存管理指令:修改页表、分配/回收物理内存
- 特权级修改指令:改变 CPU 运行模式
这些指令必须由 操作系统内核 控制,防止普通应用程序滥用系统资源,影响系统稳定性。
3.22 非特权指令
非特权指令是普通程序可以直接执行的指令,这些指令不会影响系统的安全和稳定性。
常见非特权指令包括:
- 基本算术运算(加、减、乘、除)
- 数据传输指令(
MOV、PUSH、POP) - 逻辑运算(
AND、OR、XOR) - 普通跳转指令(
JMP、CALL、RET)
当普通用户程序需要执行特权指令时,必须通过 系统调用(System Call) 由操作系统代理执行。
3.3 处理器的两种状态
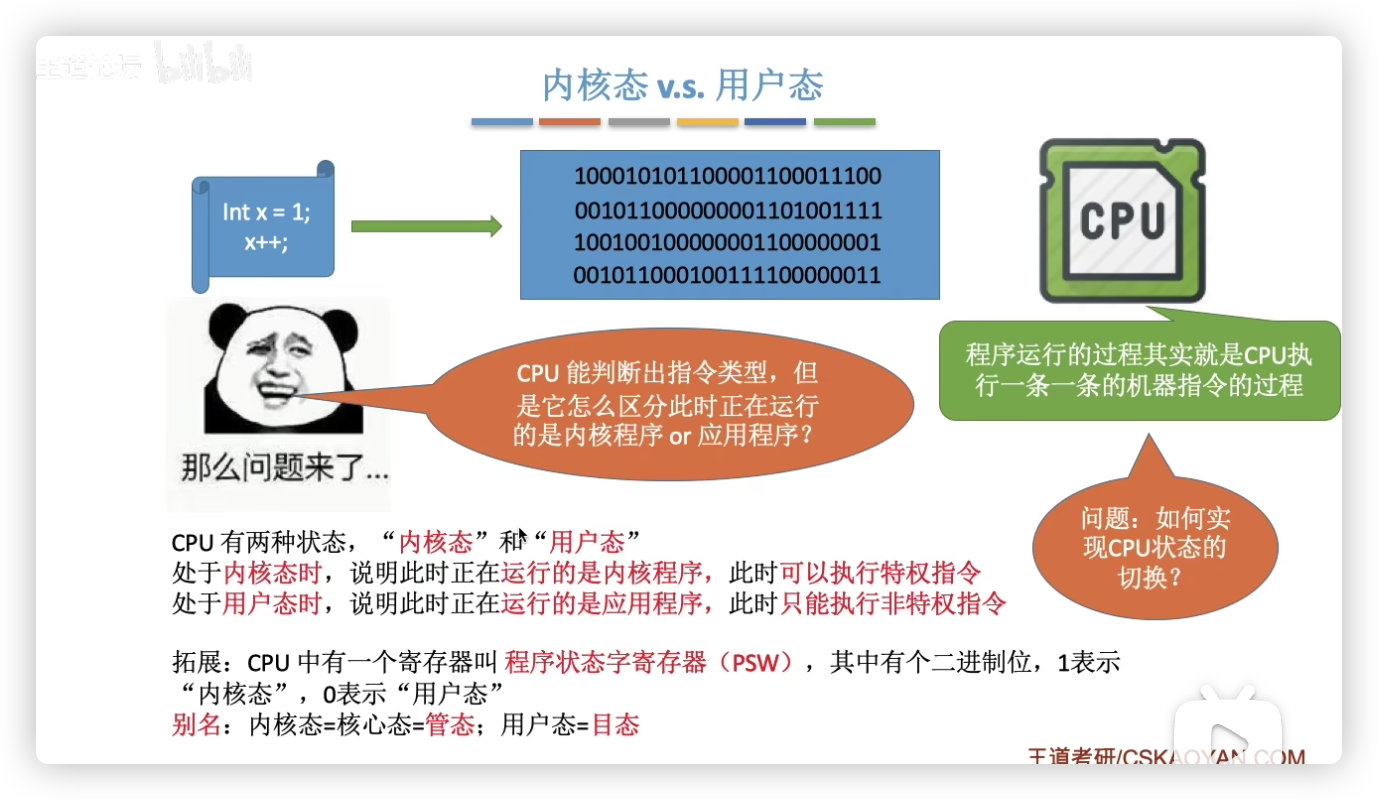
CPU 在执行程序时,始终运行在以下两种状态之一:
- 核心态(Kernel Mode)
- 用户态(User Mode)
3.31 核心态(Kernel Mode)
核心态是 CPU 具有最高权限 的运行模式,在该模式下:
- CPU 可以执行所有指令(包括特权指令)。
- 可以直接访问硬件设备(如磁盘、内存、I/O 设备)。
- 操作系统内核程序运行在该模式下,管理整个系统。
应用场景:
- 进程调度
- 设备管理(磁盘、网络)
- 内存管理
- 处理系统调用和中断
3.32 用户态(User Mode)
用户态是 CPU 受限的运行模式,普通应用程序在该模式下运行:
- 不能执行特权指令,只能执行非特权指令。
- 不能直接访问硬件,必须通过操作系统提供的 API 进行访问。
3.33 用户态与内核态的切换机制
在操作系统中,CPU 在 用户态(User Mode) 和 内核态(Kernel Mode) 之间不断切换,以保证用户程序能够安全、受控地访问系统资源。这种切换主要由以下两种机制实现:
- 用户态 → 内核态:由 中断(Interrupt) 或 陷入(Trap) 触发,操作系统夺回 CPU 控制权。
- 内核态 → 用户态:执行一条特权指令,修改 程序状态字(PSW, Program Status Word) 标志位为“用户态”,主动让出 CPU。
| 切换方向 | 触发方式 | 机制 |
|---|---|---|
| 用户态 → 内核态 | 系统调用 | syscall 触发 Trap 进入内核 |
| 外部中断 | 设备触发中断(如键盘输入),CPU 进入内核态 | |
| 异常 | 非法操作(如除零)触发异常,进入内核态 | |
| 内核态 → 用户态 | 特权指令 | 执行 IRET,恢复用户态 |
| 进程调度 | 时间片到期,调度新进程,CPU 进入用户态 |
4. 中断机制
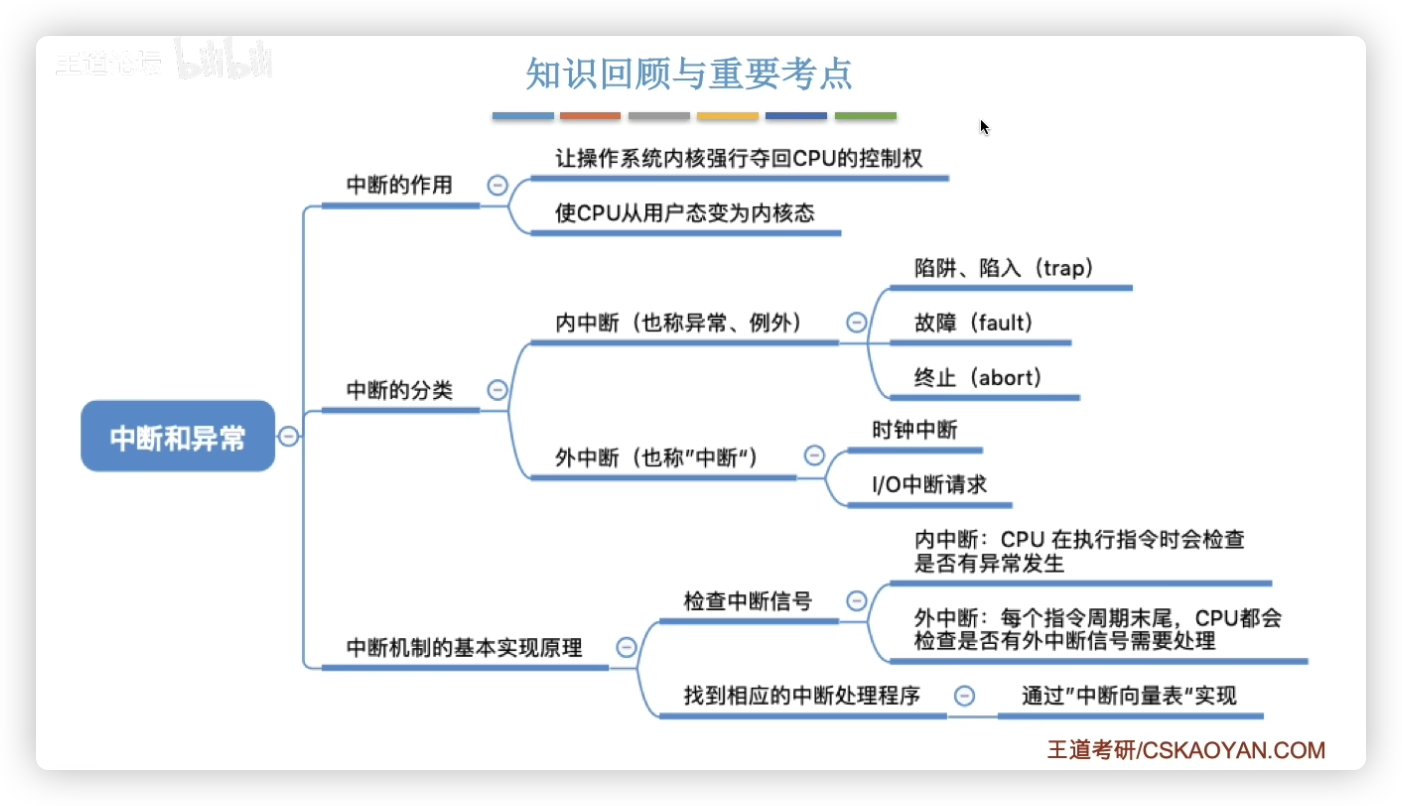
在计算机系统中,中断(Interrupt)是一种重要的机制,它能够使CPU暂时中断当前正在执行的指令,让操作系统内核强行夺回CPU的控制权,使CPU从用户态变为内核态。根据中断的来源和处理方式,中断可以分为内中断(异常)和外中断(狭义的中断)。
4.1 内中断
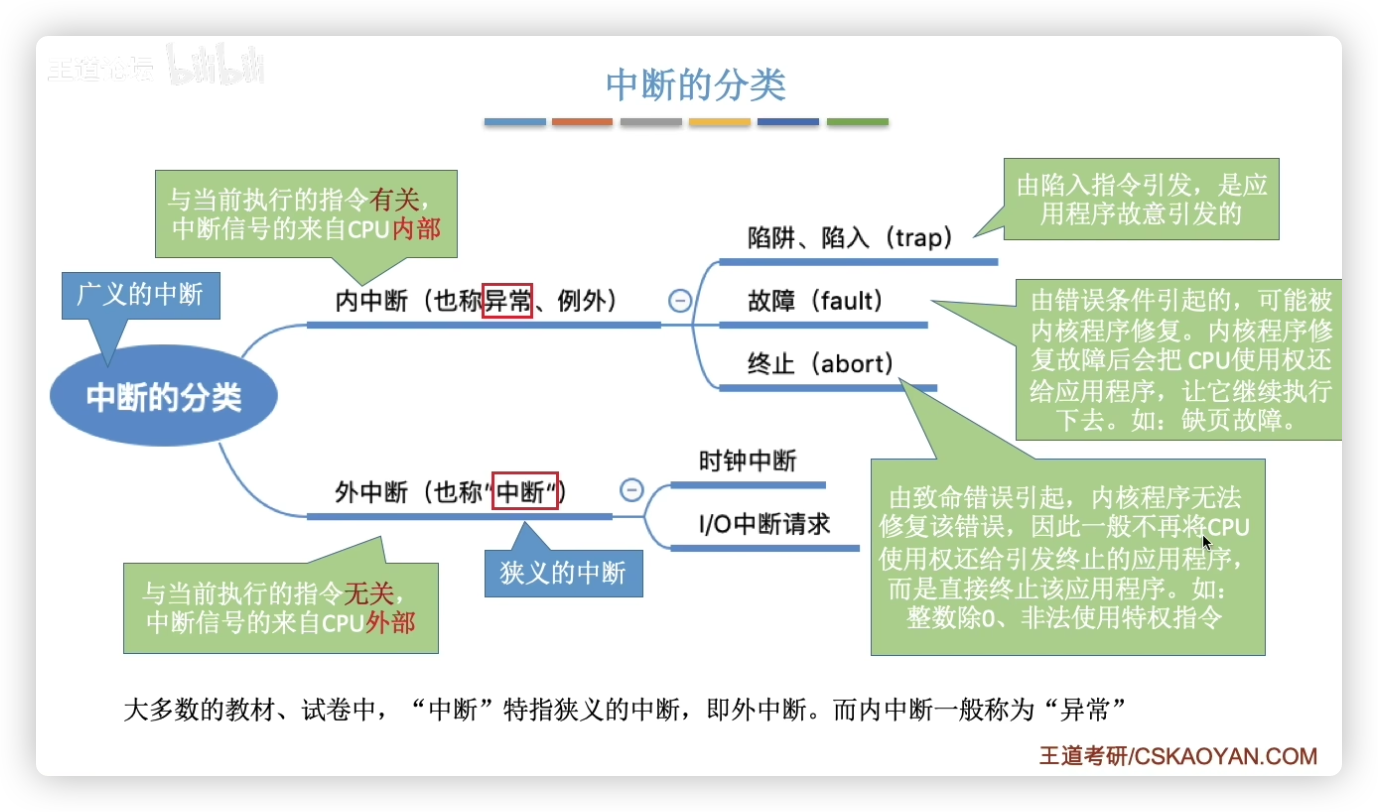
内中断(Exception)是由CPU内部产生的,通常与当前正在执行的指令密切相关。它可以进一步分为三类:
4.12 陷阱(Trap)
- 由程序使用**陷入指令(INT、SYSCALL等)**故意引发。
- 目的是执行特权操作,如系统调用。
- 处理完毕后,CPU会将控制权还给应用程序。
4.13 故障(Fault)
- 由错误条件引发,可能被操作系统内核修复。
- 例如:缺页故障(Page Fault),当程序访问未加载到内存的页面时,操作系统可调入页面后恢复程序执行。
4.14 终止(Abort)
- 由致命错误引发,操作系统无法修复,通常导致程序终止。
- 例如:
- 整数除零错误
- 非法使用特权指令
4.2 外中断
外中断是指与当前执行的指令无关,由CPU外部设备产生的中断信号。它一般由硬件事件触发,例如:
- 时钟中断:定时器定期触发,使操作系统可以进行任务调度。
- I/O 中断:当外设(如键盘、硬盘、网络设备)完成数据传输后,向CPU发送中断信号,以便处理输入或输出。
注意: 在大多数教材和试卷中,“中断”通常指的是狭义的中断(外中断),而内中断则被称为**“异常”**(Exception)。
4.3 中断的实现原理
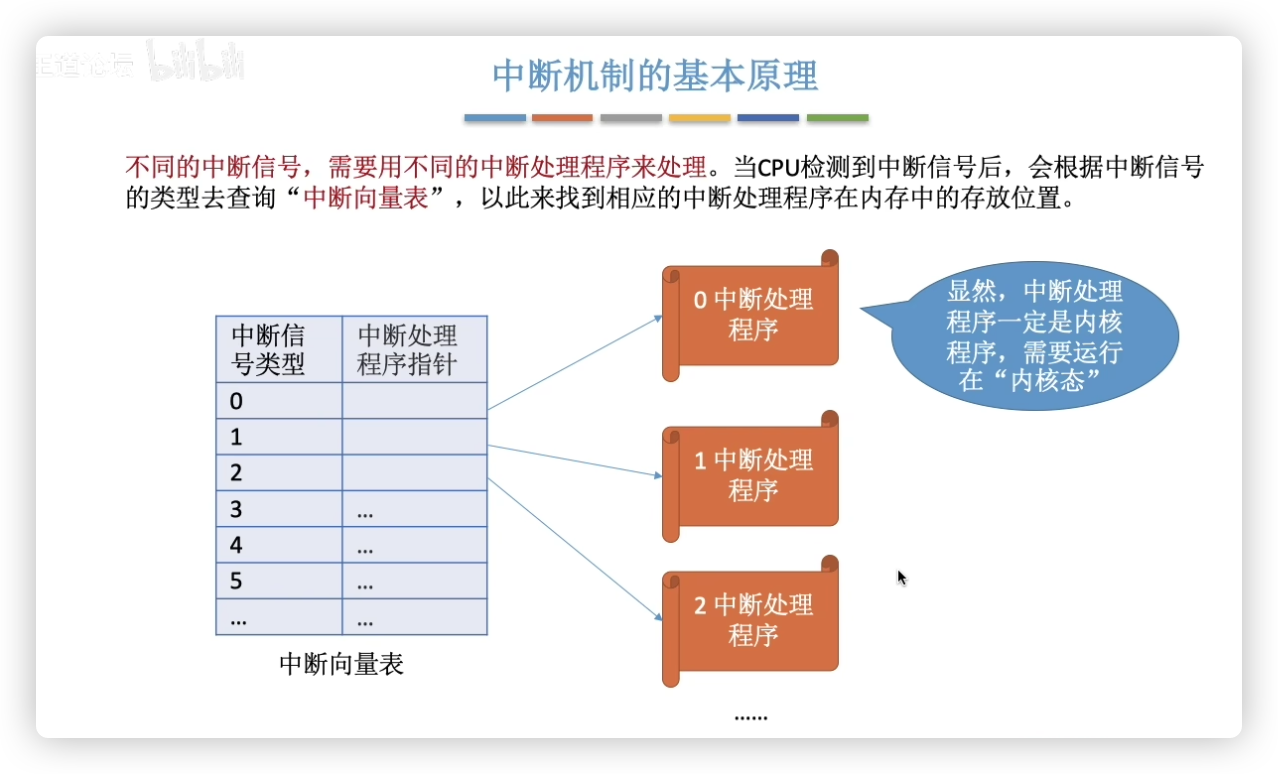
通过“中断向量表”找到相应的中断处理程序。中断处理程序的地址存储在**中断向量表(Interrupt Vector Table, IVT)**中,该表位于固定的内存地址。
- 每个中断源(例如键盘、硬盘、定时器)在中断向量表中都有一个对应的入口。
- 当中断发生时,CPU会查询中断向量表,找到对应的中断服务程序(Interrupt Service Routine, ISR)的地址,并跳转执行。
5. 系统调用详解
系统调用(System Call)是应用程序与操作系统之间的接口,允许用户程序请求操作系统内核执行特权操作,如文件访问、进程管理、设备控制等。由于操作系统内核运行在特权模式(内核态),而普通应用程序运行在用户模式(用户态),直接访问系统资源是不允许的,因此必须通过系统调用来请求内核的帮助。
5.1系统调用与库函数的区别
5.11 库函数
库函数(Library Function)是用户程序调用的一种封装好的功能,如 printf()、malloc()、strcpy() 等。这些函数可能会调用系统调用,也可能只是简单的计算和内存操作,不涉及操作系统的资源管理。
5.12 系统调用
系统调用是直接由操作系统内核提供的接口,用于完成与硬件或资源管理相关的任务。例如:
open()用于打开文件read()读取文件内容fork()创建新进程exec()执行新程序
系统调用 vs. 库函数
| 对比项 | 系统调用 | 库函数 |
|---|---|---|
| 执行位置 | 运行在内核态 | 运行在用户态 |
| 是否直接与内核交互 | 是,直接请求操作系统服务 | 可能会调用系统调用,但本身不一定与内核交互 |
| 功能 | 访问硬件、管理资源 | 计算、数据处理、封装系统调用 |
| 示例 | read(), write(), fork() | printf(), strlen(), malloc() |
5.2 小例子:为什么系统调用是必须的?
假设我们在 Word 和 WPS 这两个应用程序中同时点击打印按钮。问题来了:
- 这两个程序都需要使用同一个打印机,但如果它们直接访问打印设备,可能会造成数据混乱。
- 由于打印机是共享资源,操作系统必须协调多个程序对打印机的访问,确保按顺序打印。
解决方案:
- Word 和 WPS 不能直接访问打印机,而是通过系统调用向操作系统请求打印服务。
- 操作系统内核负责排队处理打印请求,避免冲突。
这说明:凡是涉及共享资源的操作(如设备管理、文件管理等),都必须通过系统调用来实现,以确保系统的稳定性和安全性。
5.3 什么功能必须使用系统调用?
**设备管理:**例如打印机、键盘、鼠标、硬盘等硬件设备的访问,必须通过系统调用(如
ioctl()、read()、write())来完成。**文件管理:**文件的创建、删除、读写、权限设置等操作涉及共享资源,必须通过系统调用:
open()打开文件read()读取文件write()写入文件close()关闭文件
**进程控制:**进程的创建、终止、等待等操作需要操作系统介入:
fork()创建新进程exec()替换当前进程映像exit()终止进程wait()等待子进程结束
**进程通信:**进程间通信(IPC)涉及数据共享和同步,必须通过操作系统完成:
pipe()创建管道shmget()申请共享内存msgsnd()发送消息队列semop()信号量操作
**内存管理:**进程不能直接操作物理内存,而是通过系统调用请求操作系统分配或释放内存:
brk()和sbrk()改变进程的堆区大小mmap()进行内存映射munmap()释放映射的内存
凡是涉及共享资源的操作,或会影响其他进程的操作,都必须通过系统调用由操作系统内核来管理,以确保安全和稳定。
5.4 系统调用的执行过程
系统调用的执行过程涉及用户态(User Mode)和内核态(Kernel Mode)的转换,主要步骤如下:
1.传递参数
- 应用程序需要向操作系统传递参数,例如
read(fd, buf, count)需要传递文件描述符fd、缓冲区buf和读取字节数count。 - 参数可以通过寄存器、栈或内存进行传递。
2. 触发系统调用
- 应用程序使用陷入指令(Trap Instruction),也称系统调用指令(syscall 或 int 0x80),将CPU切换到内核态,并跳转到相应的系统调用入口。
3. 由内核处理系统调用请求
- 操作系统内核查找系统调用号,执行相应的内核函数,完成文件访问、进程管理、设备操作等任务。
4. 返回用户程序
- 处理完毕后,内核将返回值传回用户程序,并恢复到用户态,继续执行用户程序的后续指令。
5.5 系统调用的实际示例
下面是一个使用 write() 系统调用的示例,它直接调用 Linux 内核来输出字符串,而不使用 printf():
#include <unistd.h>

int main() {
    const char *msg = "Hello, System Call!\n";
    write(1, msg, 20);  // 使用系统调用 write(),向标准输出(文件描述符 1)写入数据
    return 0;
}解析:
write()是一个系统调用,它通过文件描述符1(标准输出stdout)将msg写入终端。- 这段代码直接与操作系统交互,而
printf()只是 C 标准库提供的封装,它最终也会调用write()。
6. 操作系统的体系结构
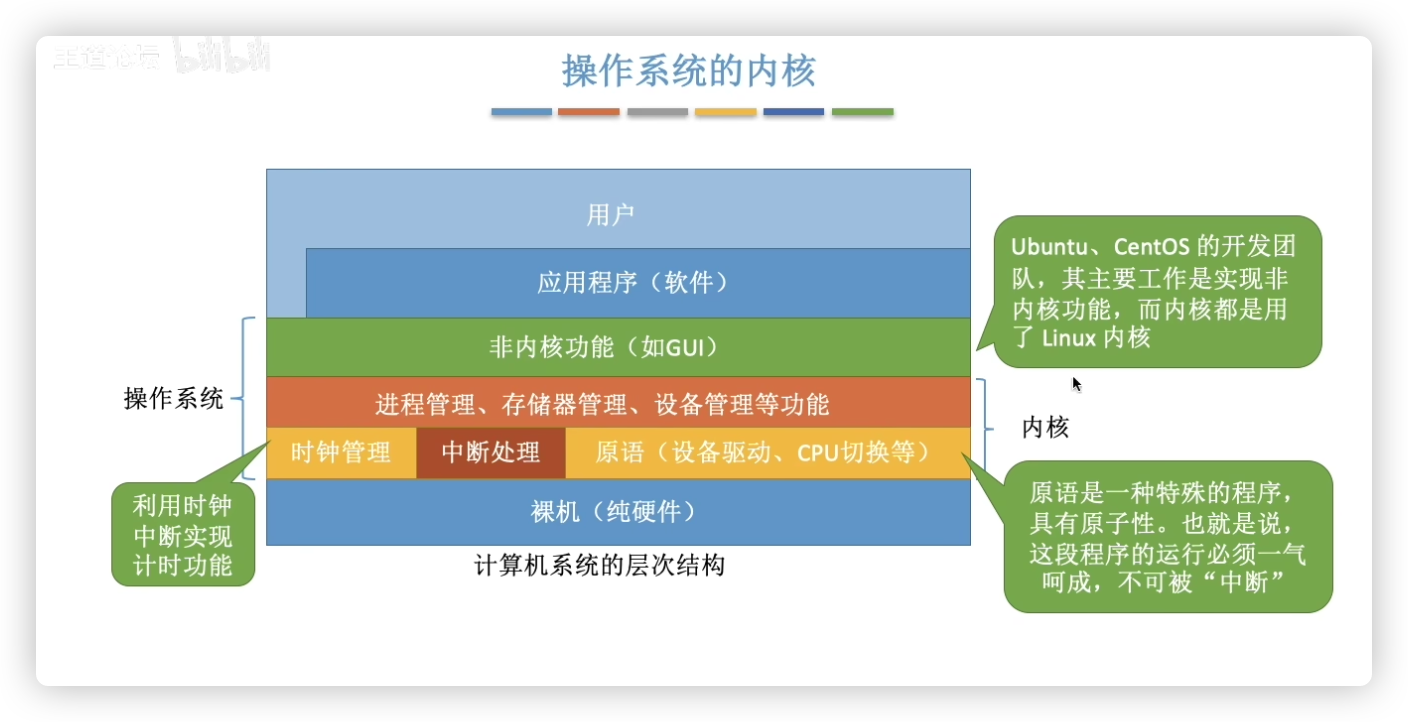
操作系统的体系结构决定了其功能模块的组织方式,以及内核(Kernel)如何管理系统资源、处理用户请求。常见的操作系统架构主要包括大内核(宏内核,Monolithic Kernel)和微内核(Microkernel)。
6.1 大内核(宏内核,Monolithic Kernel)
6.11 结构特点
- 将操作系统的主要功能模块都集成在内核中,运行在核心态(Kernel Mode)。
- 包含进程管理、内存管理、文件系统、设备驱动、网络协议栈等功能。
- 进程在用户态执行,只有当需要操作系统服务时才会切换到核心态执行系统调用。
✅ 优点:高性能
- 由于所有功能模块都在内核中运行,函数调用速度快,无需频繁的用户态和核心态切换,从而提高了系统性能。
- 设备驱动、文件系统等模块之间通信无需额外的消息传递机制,减少了通信开销。
❌ 缺点:代码庞大、难以维护
- 内核代码庞大:随着功能增加,内核变得越来越复杂,不易维护和扩展。
- 结构混乱:不同模块紧密耦合,一个模块出现问题可能会影响整个系统。
- 稳定性较差:如果某个模块(如设备驱动)崩溃,整个系统可能都会崩溃。
6.12 代表性操作系统
- Linux:采用大内核架构,但支持可加载模块(Loadable Kernel Module, LKM),允许动态加载驱动和功能模块。
- Windows(早期版本):如 Windows 95/98 采用了宏内核设计。
6.2 微内核(Microkernel)
6.21 结构特点
- 仅保留最基本的核心功能在内核中,如:进程管理、内存管理、进程间通信(IPC)
- 其他功能(如文件系统、设备驱动、网络协议等)移出内核,运行在用户态(User Mode),作为独立的服务(Servers) 通过消息传递(Message Passing)与内核交互。
✅ 优点:结构清晰,易维护
- 内核规模小,代码简单,易于维护和扩展。
- 模块化设计,各个系统组件(如文件系统、设备驱动)相互独立,崩溃不会影响整个系统,提高了稳定性和安全性。
- 可移植性高,微内核架构易于适配不同硬件架构。
❌ 缺点:性能较低
- 系统调用需要在用户态和核心态之间频繁切换,导致上下文切换开销较大,性能较低。
- 进程间通信(IPC)依赖消息传递,相比函数调用效率较低。
6.22 代表性操作系统
- MINIX:微内核架构,主要用于教学和研究。
- QNX:工业级实时操作系统,广泛应用于嵌入式系统。
- Windows NT(部分采用微内核思想):虽然 Windows NT 不是完全的微内核,但其设备驱动、子系统 运行在用户态,部分借鉴了微内核的设计。
6.3 大内核 vs. 微内核 对比
| 对比项 | 大内核(宏内核) | 微内核 |
|---|---|---|
| 核心功能 | 进程管理、内存管理、文件系统、设备驱动、网络协议等 | 仅保留进程管理、内存管理、进程间通信(IPC) |
| 性能 | 高(因为系统调用是函数调用,开销小) | 低(用户态与核心态频繁切换,IPC 开销大) |
| 系统稳定性 | 低(内核崩溃会导致整个系统崩溃) | 高(非核心功能崩溃不会影响系统) |
| 可维护性 | 代码庞大,难以维护 | 代码精简,易维护 |
| 扩展性 | 扩展困难,需修改内核 | 模块化设计,易扩展 |
| 代表系统 | Linux、Windows 早期版本 | MINIX、QNX、部分 Windows NT 组件 |

6.4 其他操作系统架构
除了传统的大内核和微内核外,还有一些混合架构:
6.41 混合内核(Hybrid Kernel)
- 结合大内核和微内核的优点,允许部分组件在用户态运行,同时仍然保留高效的核心服务。
- Windows NT、macOS X、iOS、Android 采用混合架构。
6.42 外核(Exokernel)
- 让应用程序直接管理硬件资源,而不是由操作系统管理,极大提高了灵活性和性能。
- 主要用于研究和实验。
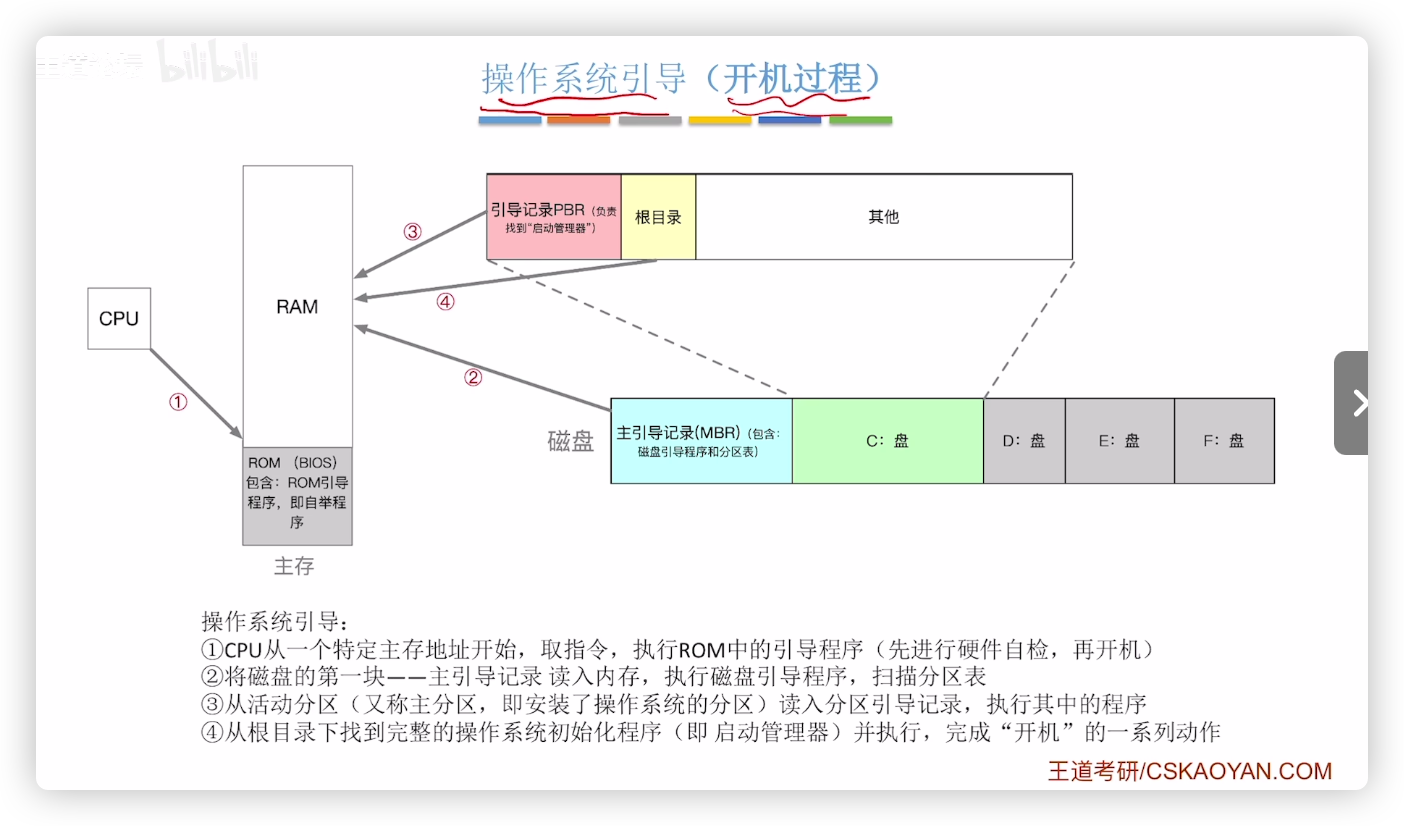
操作系统引导(Boot)是计算机开机后,让操作系统运行起来的过程。这个过程涉及多个阶段,包括固件(BIOS/UEFI)初始化、引导加载程序(Bootloader)加载、内核启动等。下面我们来详细拆解整个启动过程,并讲解新磁盘的分区方式。
7. 操作系统引导(Boot)
7.1 开机时如何让操作系统运行起来?
计算机启动时,CPU 还没有加载操作系统,需要通过一系列步骤找到操作系统并加载到内存中。整个过程可以分为5 个阶段:
(1) CPU 加电执行 ROM 中的引导程序
- CPU 一旦通电,会从一个固定的地址开始执行指令。
- 这个地址对应的是 ROM(只读存储器,Read-Only Memory),里面存储了固件(BIOS 或 UEFI)。
- BIOS/UEFI 作用:
- 进行自检(POST,Power-On Self-Test),检查 CPU、内存、显卡等硬件是否正常。
- 识别并初始化硬盘、USB 设备、网卡等外部设备。
- 寻找启动设备(通常是硬盘、U 盘、网络等)。
(2) BIOS/UEFI 加载引导加载程序(Bootloader)
- 现代计算机一般使用 UEFI,老旧系统可能仍使用 BIOS。
- BIOS 方式:
- 读取磁盘的第一个扇区(MBR,主引导记录,512 字节)。
- MBR 里存储了Bootloader(引导加载程序),如
GRUB或Windows Boot Manager。 - 将 Bootloader 加载到内存,并交给 CPU 执行。
- UEFI 方式:
- 直接从磁盘上读取 EFI 分区中的
bootx64.efi(UEFI Bootloader)。 - 支持更复杂的启动逻辑,比如安全启动(Secure Boot)。
- 直接从磁盘上读取 EFI 分区中的
(3) 引导加载程序(Bootloader)加载操作系统内核
- Bootloader 作用:
- 让用户选择启动的操作系统(如果有多个)。
- 读取操作系统的内核文件并加载到内存中。
- 启动内核,并将控制权交给它。
- 常见 Bootloader:
- Linux:GRUB、LILO、Syslinux
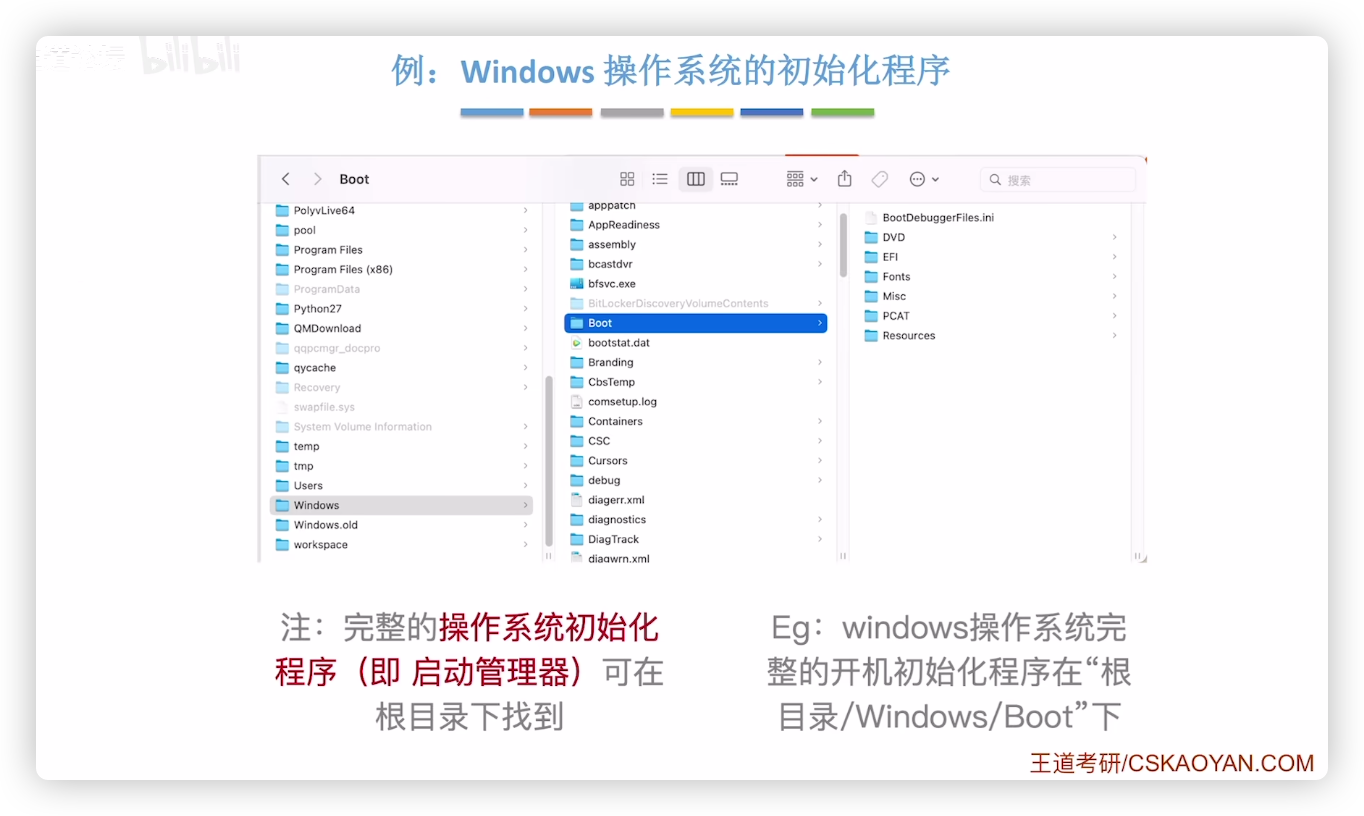
- Windows:Windows Boot Manager
- macOS:EFI Boot Manager
(4) 操作系统内核初始化
- Bootloader 加载了内核(例如
vmlinuz)后,内核开始执行。 - 内核初始化步骤:
- 设置 CPU 工作模式(如 64 位模式)。
- 初始化内存管理(建立分页表)。
- 检测和初始化硬件设备(如显卡、磁盘、网络设备)。
- 挂载根文件系统(Root Filesystem),以便访问存储设备上的文件。
(5) 启动用户空间程序(init/systemd)
- 内核初始化完成后,会启动用户空间的第一个进程:
- Linux:
init(或systemd) - Windows:
wininit.exe
- Linux:
init/systemd负责:- 运行服务(如 SSH、数据库等)。
- 设定用户权限、挂载磁盘等。
- 启动登录界面(TTY 或 GUI),用户可以登录使用系统。
7.2 新买的磁盘如何划分?
一块新磁盘买回来是空白的,要进行分区、格式化、挂载才能使用。
(1) 选择分区表格式:MBR vs GPT
- MBR(主引导记录,Master Boot Record)
- 适用于传统 BIOS 启动模式。
- 最多 4 个主分区,如果需要更多分区,需要使用扩展分区+逻辑分区。
- 单个分区最大 2TB(适用于小型磁盘)。
- 不支持 UEFI 安全启动。
- GPT(GUID 分区表)
- 适用于UEFI 启动,未来主流。
- 最多支持 128 个分区。
- 单个分区支持 8ZB(1ZB = 10¹² GB),适用于大容量硬盘。
- 支持冗余备份,防止数据丢失。
👉 新磁盘推荐使用 GPT,除非是老旧系统才使用 MBR。
(2) 创建分区
Linux 使用
fdisk(MBR)或gdisk(GPT)shsudo fdisk /dev/sdb # 进入分区工具(适用于 MBR) sudo gdisk /dev/sdb # 适用于 GPT在
fdisk里可以:n创建新分区d删除分区p查看分区表w写入分区表并退出
Windows 使用“磁盘管理”
- 右键“此电脑” → “管理” → “磁盘管理”。
- 选择新磁盘,初始化为 GPT(推荐)。
- 右键未分配空间,创建新分区。
(3) 格式化分区
Linux 格式化
shsudo mkfs.ext4 /dev/sdb1 # 格式化为 ext4(常用于 Linux) sudo mkfs.xfs /dev/sdb1 # 格式化为 XFS(适用于大文件)Windows 格式化
- 右键分区 → “格式化” → 选择 NTFS(推荐)或 exFAT(兼容 macOS)。
(4) 挂载磁盘
Linux 挂载
shsudo mount /dev/sdb1 /mnt- 让
/dev/sdb1映射到/mnt目录,可以使用cd /mnt访问。
- 让
Windows 挂载
- Windows 自动挂载到
D:\、E:\这样的盘符。
- Windows 自动挂载到
8. 虚拟机
在现代计算机系统中,虚拟机(Virtual Machine, VM)被广泛应用于服务器管理、软件开发、云计算、测试环境等多个领域。那么,为什么我们需要虚拟机呢?主要有以下几个原因:
资源利用率低,物理机成本高。在传统计算模式下,每个服务器通常运行一个操作系统和一组应用,但计算资源往往得不到充分利用。例如:
- 一个数据库服务器可能只有 20% 的 CPU 使用率,但却占用了整台物理机。
- 购买和维护多台物理服务器成本高昂,且能源消耗大。
虚拟机的作用:
- 多个虚拟机可以共享同一台物理服务器的资源,大幅提高资源利用率。
- 降低硬件采购和维护成本,减少空间占用和电力消耗。
7.1 系统虚拟机(System Virtual Machine)
- 作用:提供完整的硬件虚拟化环境,允许在同一台物理机上运行多个操作系统。
- 实现方式:
- 裸金属虚拟机(Type 1 Hypervisor):直接运行在物理硬件上,不依赖宿主操作系统。例如:
- VMware ESXi
- Microsoft Hyper-V
- Xen
- 托管型虚拟机(Type 2 Hypervisor):运行在宿主操作系统之上,需要依赖宿主操作系统。例如:
- VMware Workstation
- VirtualBox
- Parallels Desktop
- 裸金属虚拟机(Type 1 Hypervisor):直接运行在物理硬件上,不依赖宿主操作系统。例如:

9. 进程概念
**程序如何运行的?**首先,程序的源代码通过编译器(对于像 C、C++ 这样的语言)或解释器(对于像 Python 这样的语言)转换为机器能够理解的指令,通常是二进制文件或字节码。然后,操作系统将程序加载到内存中,分配所需的资源,并为其创建一个进程。接着,CPU 执行程序中的指令,程序根据输入数据进行处理,输出结果。对于 Java 等语言,JVM(Java 虚拟机)会将字节码解释执行或通过即时编译(JIT)转换为本地机器码运行。程序在执行过程中会进行内存分配、栈帧创建和资源管理等,直到执行结束并释放资源。
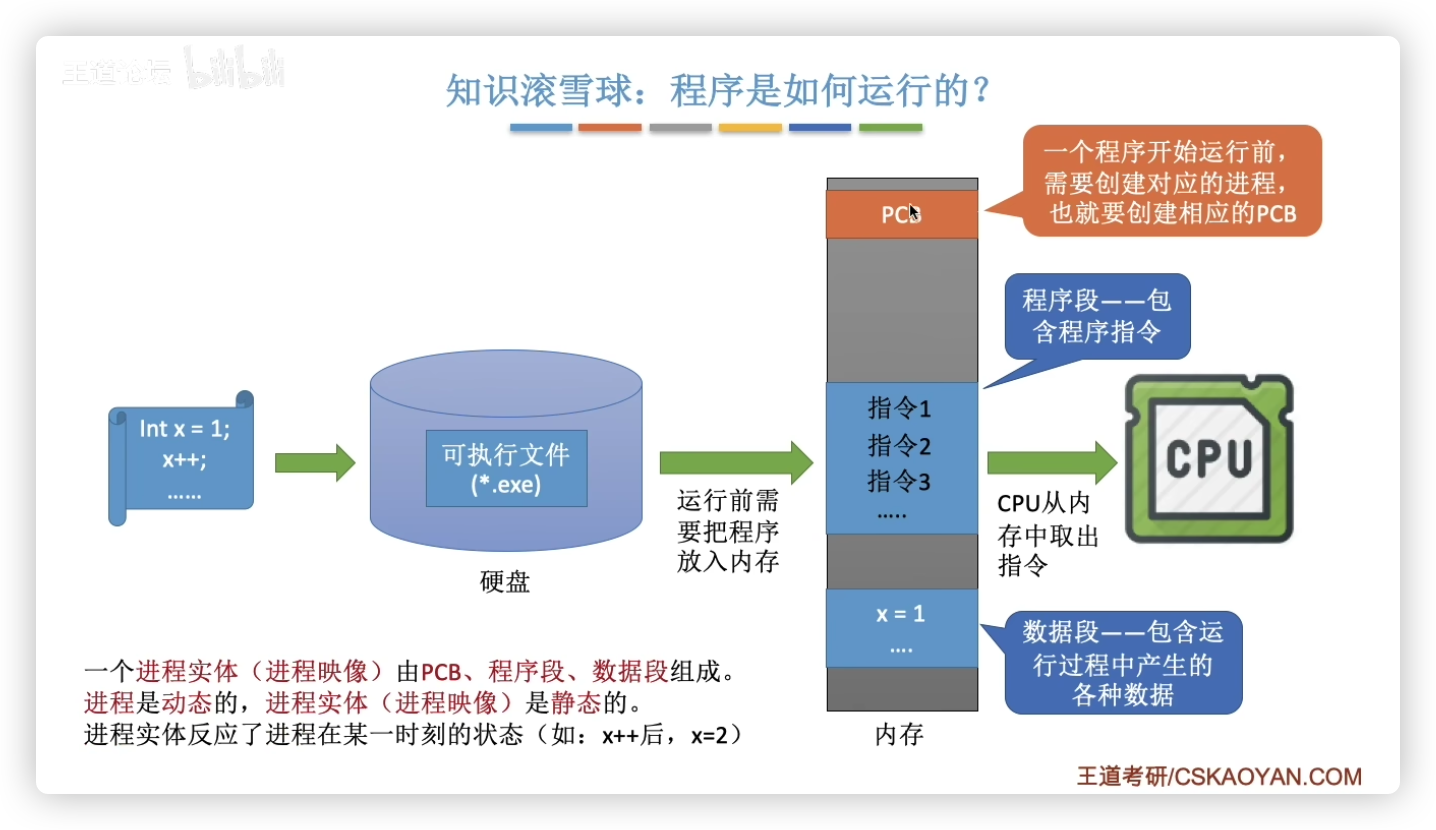
9.1 概念:理解“进程”和“程序”的区别
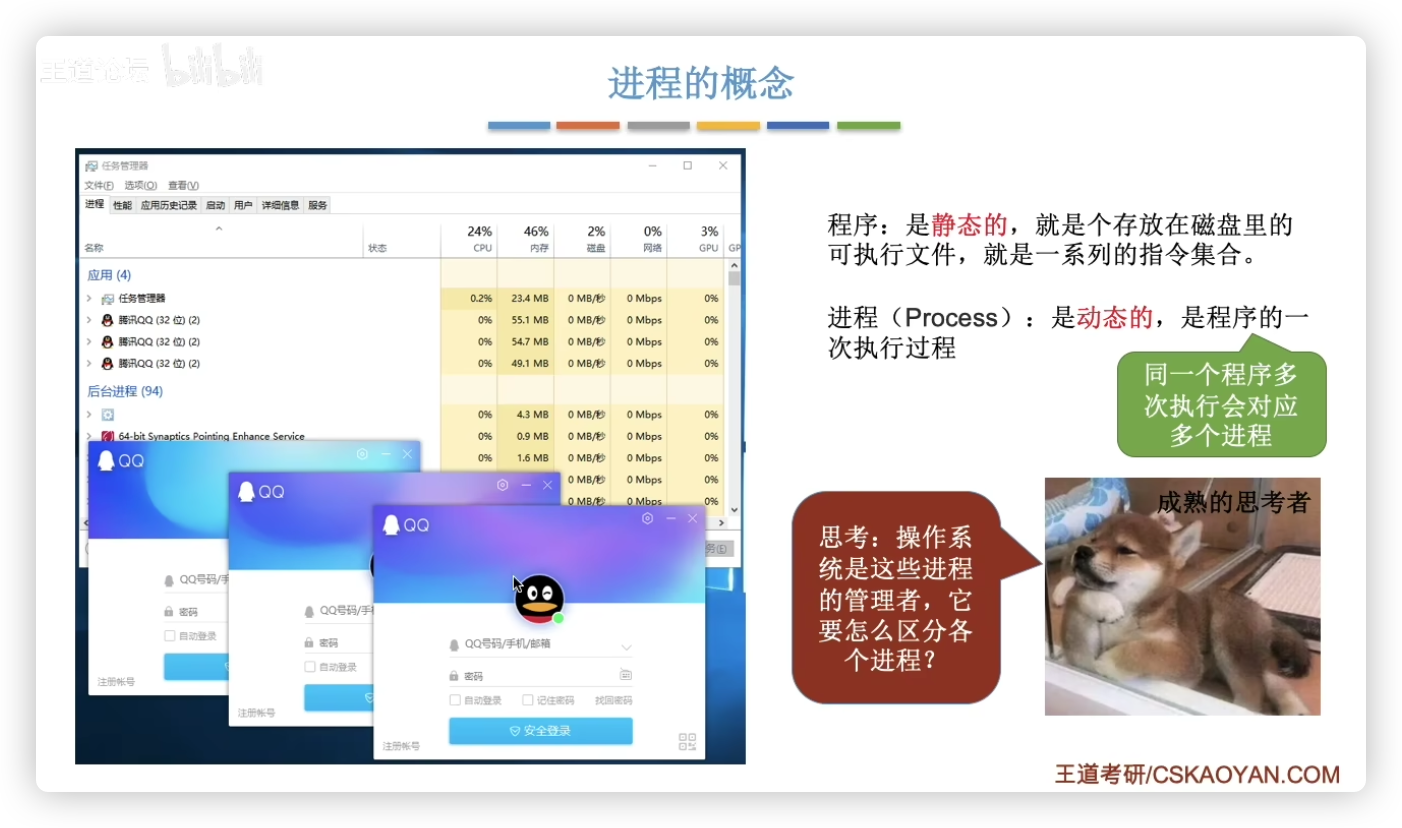
- 程序(Program):一组指令的有序集合,是静态的代码实体,本身不具备运行的能力。
- 进程(Process):程序在操作系统中的一次执行实例,是一个动态运行的实体,拥有独立的资源和执行环境。
主要区别:
- 动态 vs 静态:程序是静态的,而进程是程序的动态执行实例。
- 拥有资源:进程具有独立的资源(如内存、文件、I/O 设备),而程序本身不占用资源。
- 调度和并发:进程可被调度执行,支持并发运行,而程序仅是指令的集合,不能主动执行。
9.2 组成:一个进程由哪些部分组成
一个进程通常由以下部分组成:
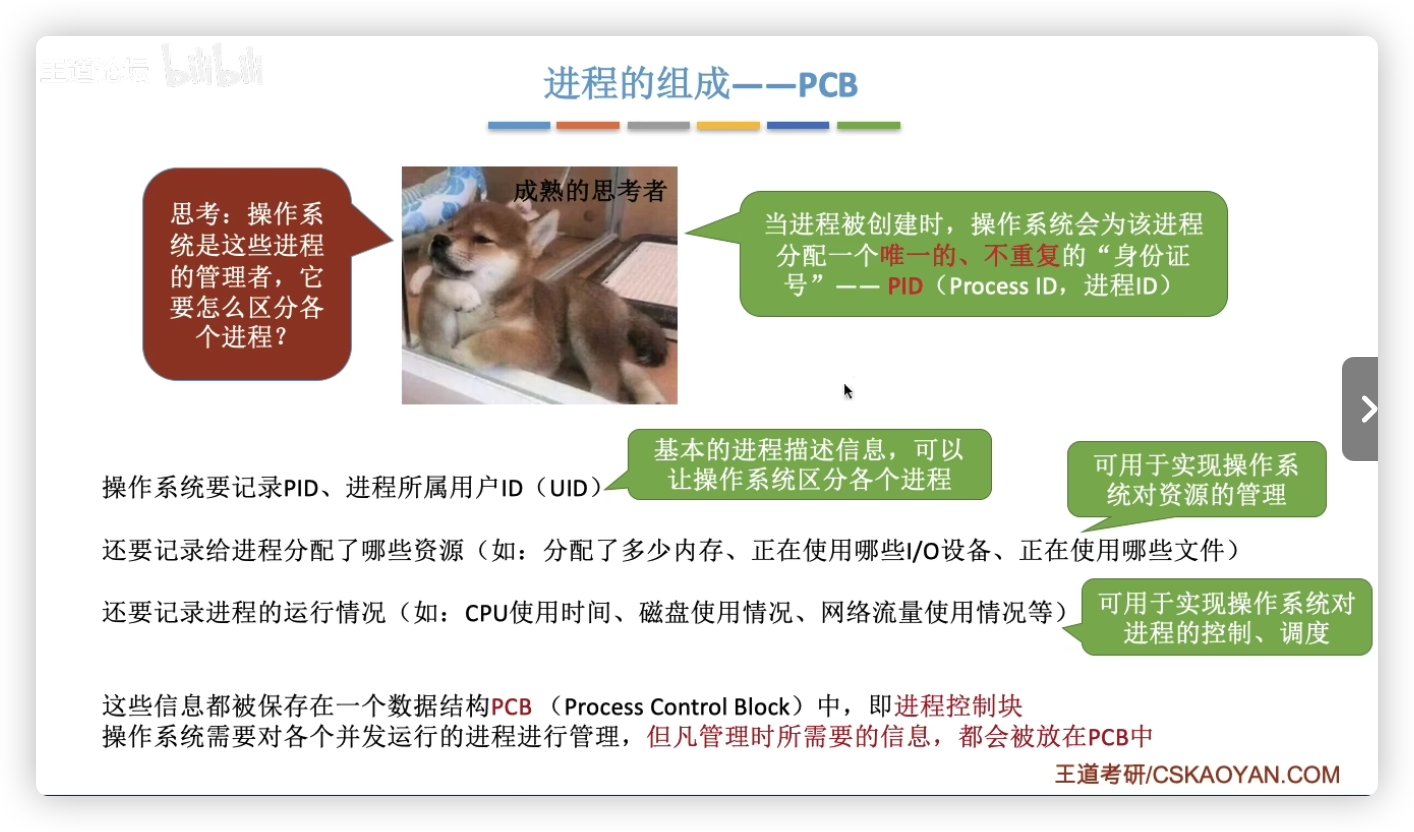
- 进程控制块(PCB,Process Control Block):存储进程的状态、标识符、CPU寄存器、调度信息等,是操作系统管理进程的核心数据结构。
- 程序代码(Code Segment):存放进程要执行的指令。
- 数据段(Data Segment):包含全局变量和已初始化数据。
- 堆(Heap):用于动态分配的内存区域,存放运行时创建的对象。
- 栈(Stack):存放函数调用时的局部变量、返回地址等信息。
9.3 特征:进程有哪些重要的特征
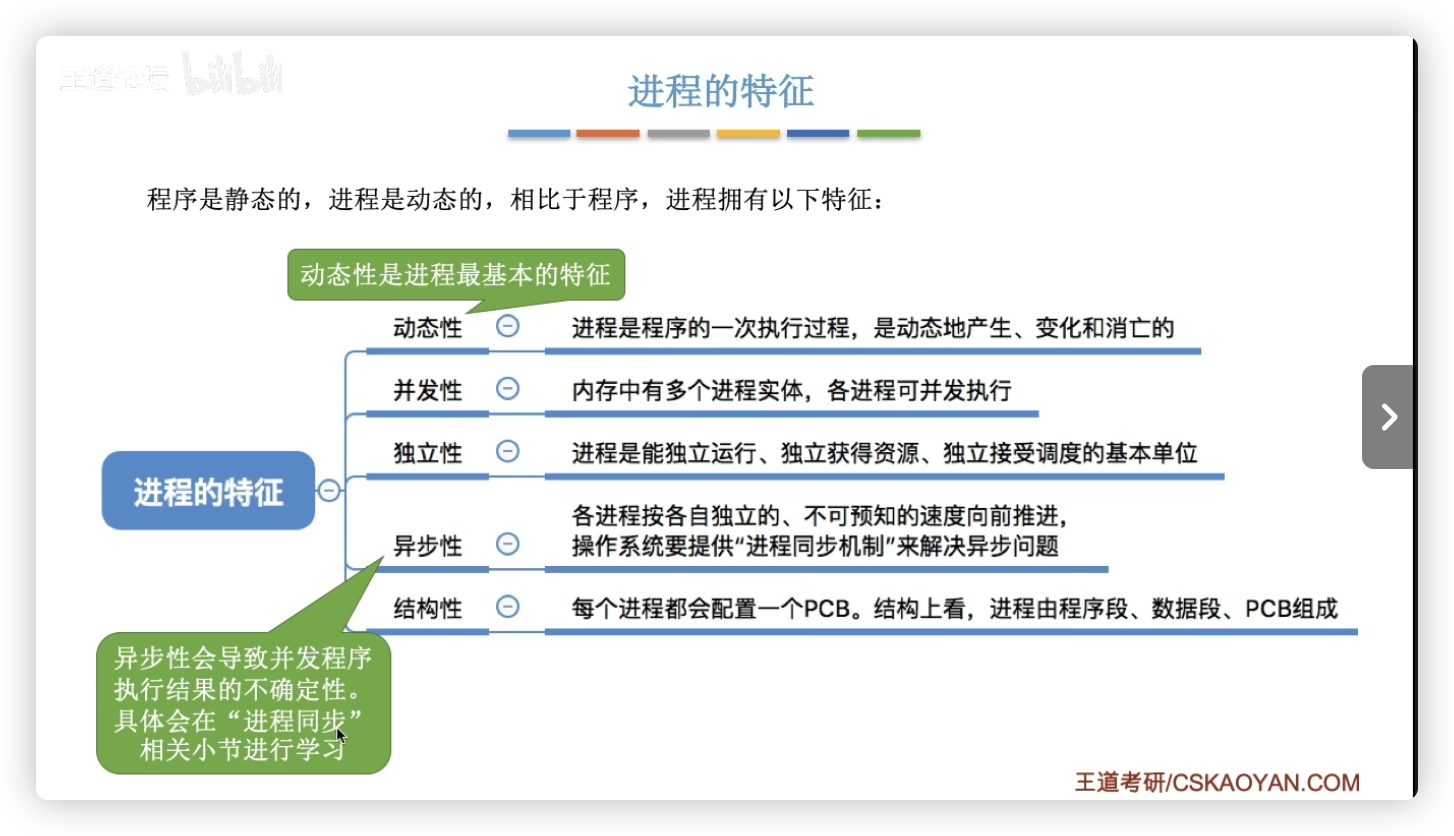
- 动态性:进程是程序的执行实例,会随着执行状态的变化而动态运行。
- 并发性:多个进程可以在操作系统上同时运行(宏观上并行,微观上交替执行)。
- 独立性:进程具有独立的地址空间和资源,不会直接影响其他进程。
- 异步性:由于进程的执行需要调度,因此运行速度不可预测,具有异步特性。
- 可创建与终止:进程可以由父进程创建,并在执行完毕后终止,释放资源。
- 拥有资源:进程在运行时占有 CPU 时间、内存、文件等资源。
这些特性使得进程成为操作系统进行任务管理和资源分配的基本单位。
10. 进程状态与转换
10.1 进程的五种状态
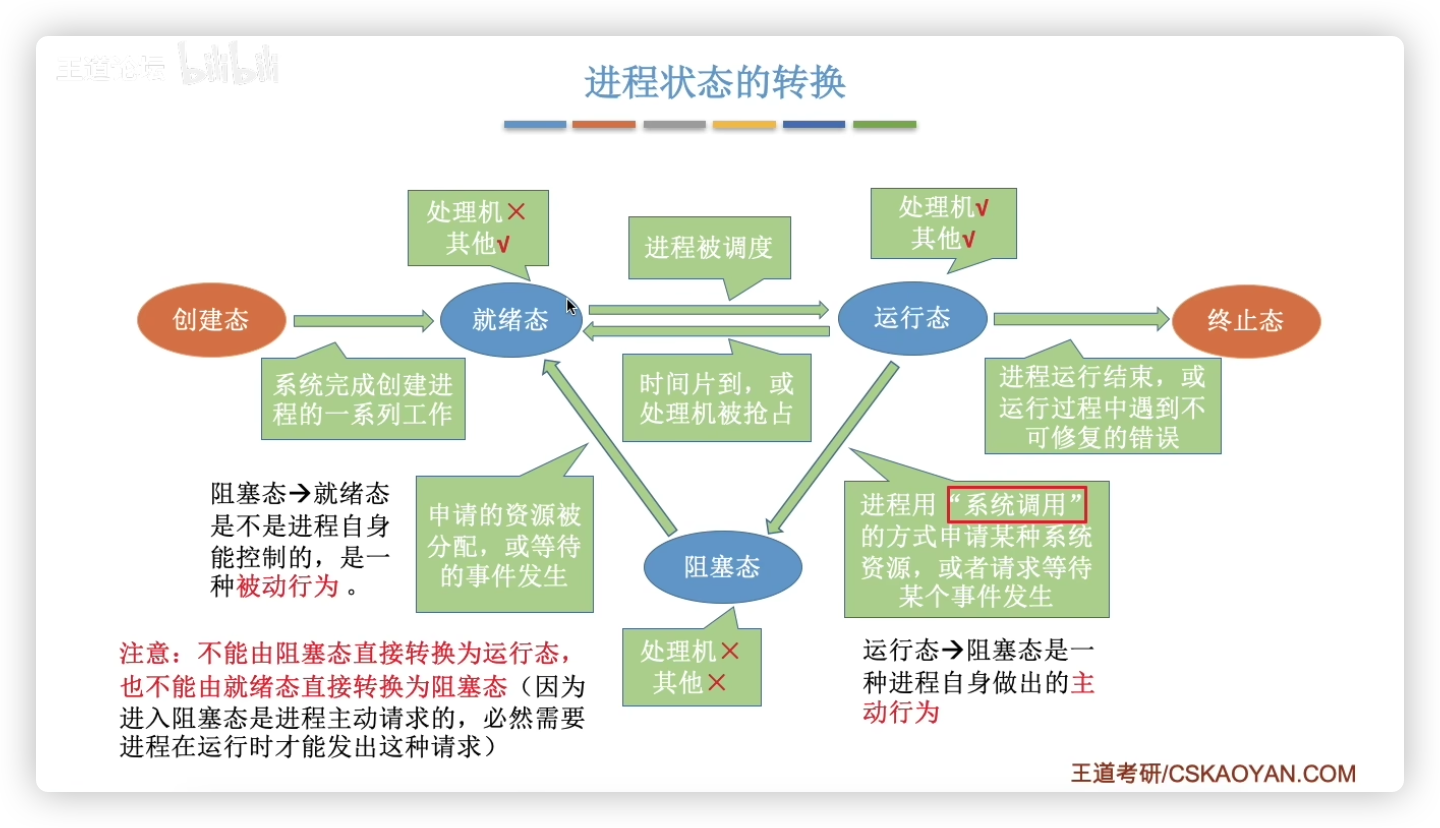
进程在执行过程中,会根据系统调度和资源状况在不同的状态之间切换。一般来说,进程具有以下 五种状态:
- 运行状态(Running)
- 进程正在 CPU 上执行,此时进程拥有 CPU 资源。
- 在单核 CPU 系统中,任意时刻最多只有 一个进程 处于运行状态。
- 在多核 CPU 系统中,可以有多个进程同时处于运行状态。
- 就绪状态(Ready)
- 进程已经具备运行的条件(如代码、数据和资源都已准备好),但因为 CPU 资源被其他进程占用,暂时无法执行。
- 当 CPU 空闲或时间片轮到该进程时,就绪进程可被调度执行。
- 阻塞状态(Blocked 或 Waiting)
- 进程在执行过程中,因等待某些事件(如 I/O 设备输入、文件读取、锁释放等)而 暂时无法运行,进入阻塞状态。
- 只有当等待的事件发生后,进程才能进入就绪状态,等待 CPU 调度。
- 创建状态(New)
- 进程刚被创建但尚未进入就绪队列,操作系统正在为其分配资源。
- 只有当进程 初始化完成 并 进入就绪队列,它才会变为就绪状态。
- 终止状态(Terminated)
- 进程执行完毕或被操作系统终止后,进入终止状态。
- 进程终止后,操作系统会回收其占用的资源,并从进程表中移除其记录。
10.2 进程状态的转换
进程在运行时,会在不同状态之间转换,主要有以下几种情况:
- 就绪态 → 运行态(获取 CPU)
- 进程在就绪队列中等待,调度程序选中了它,并将 CPU 分配给它,进入运行状态。
- 运行态 → 就绪态(时间片耗尽或被抢占)
- 进程运行过程中,如果 时间片到期 或者 更高优先级进程需要执行,操作系统会暂停该进程,将其移入就绪队列,等待下次调度。
- 运行态 → 阻塞态(等待 I/O 或资源)
- 进程在执行过程中,如果 需要等待 I/O 设备、文件输入或互斥锁等资源,它将无法继续执行,进入阻塞状态。
- 阻塞态 → 就绪态(I/O 完成或资源可用)
- 当进程等待的 I/O 设备准备就绪,或所需资源变得可用,进程会从阻塞态变为就绪态,等待调度。
- 创建态 → 就绪态(进程初始化完成)
- 新创建的进程在完成初始化(如内存分配、进程表登记等)后,会进入就绪队列,等待 CPU 调度。
- 运行态 → 终止态(进程完成或被终止)
- 进程正常执行完毕,或者由于异常(如非法操作、被杀死)导致终止,进入终止状态,系统回收资源。
10.3 进程的组织方式(PCB 组织方式)
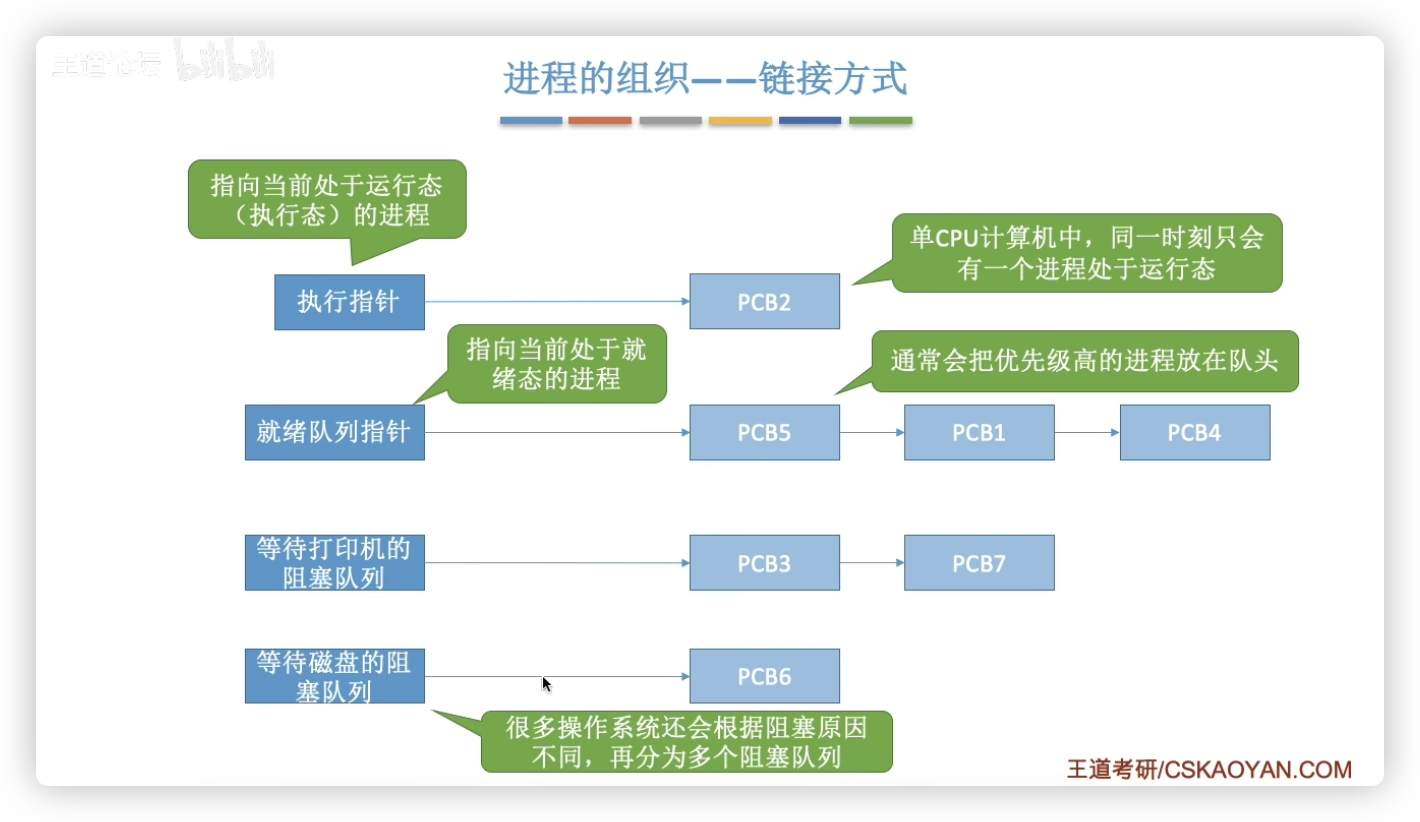
每个进程都有一个 进程控制块(PCB, Process Control Block),用于存储该进程的基本信息(进程 ID、状态、寄存器值、优先级、资源占用等)。多个 PCB 的组织方式决定了进程管理的效率,常见的组织方式包括:
11. 进程控制
11.1 什么是进程控制?
进程控制就是操作系统管理进程状态转换的过程,包括创建、运行、阻塞、终止等。其核心目标是确保进程有序、高效地执行,并合理分配系统资源。
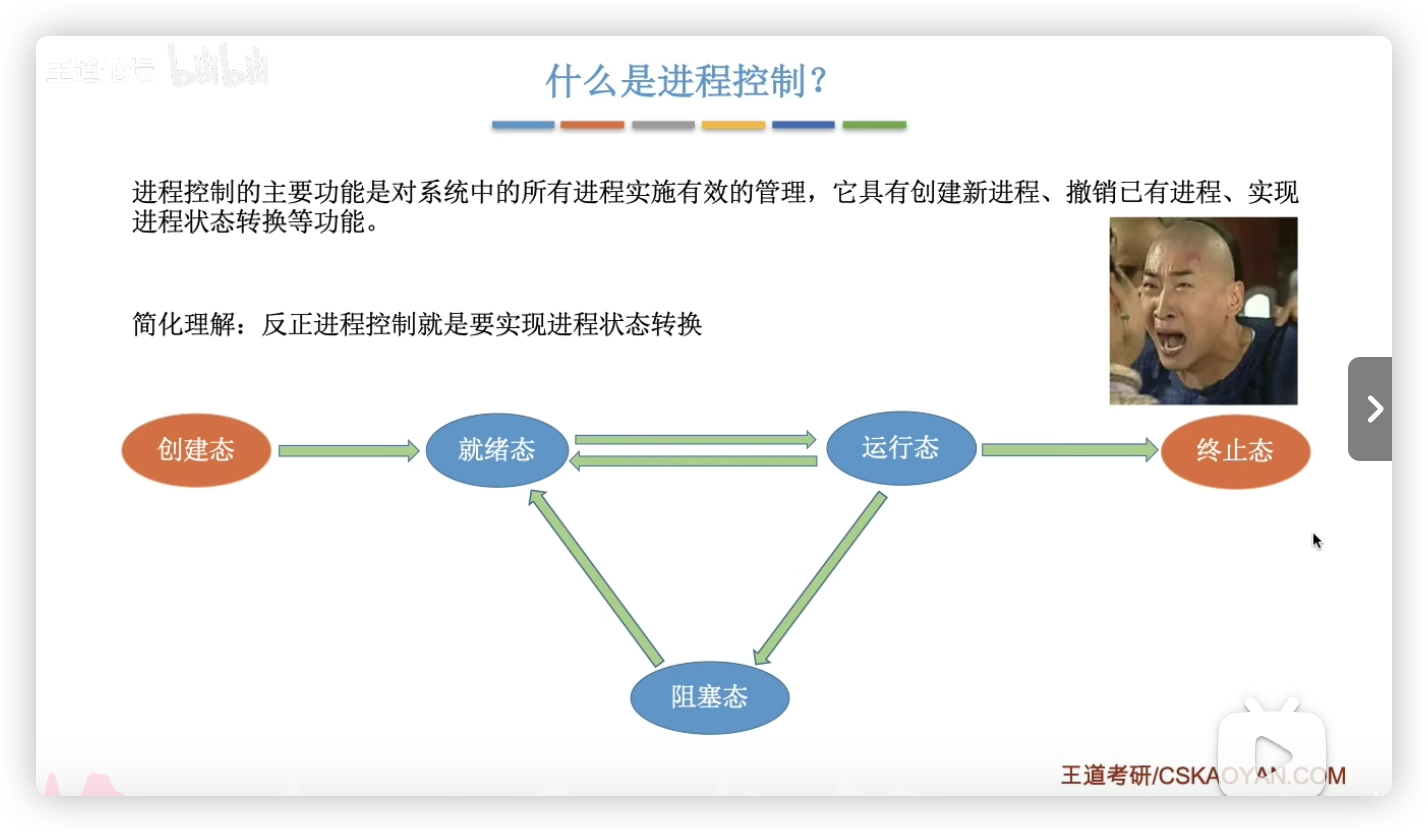
11.2 如何实现进程控制?
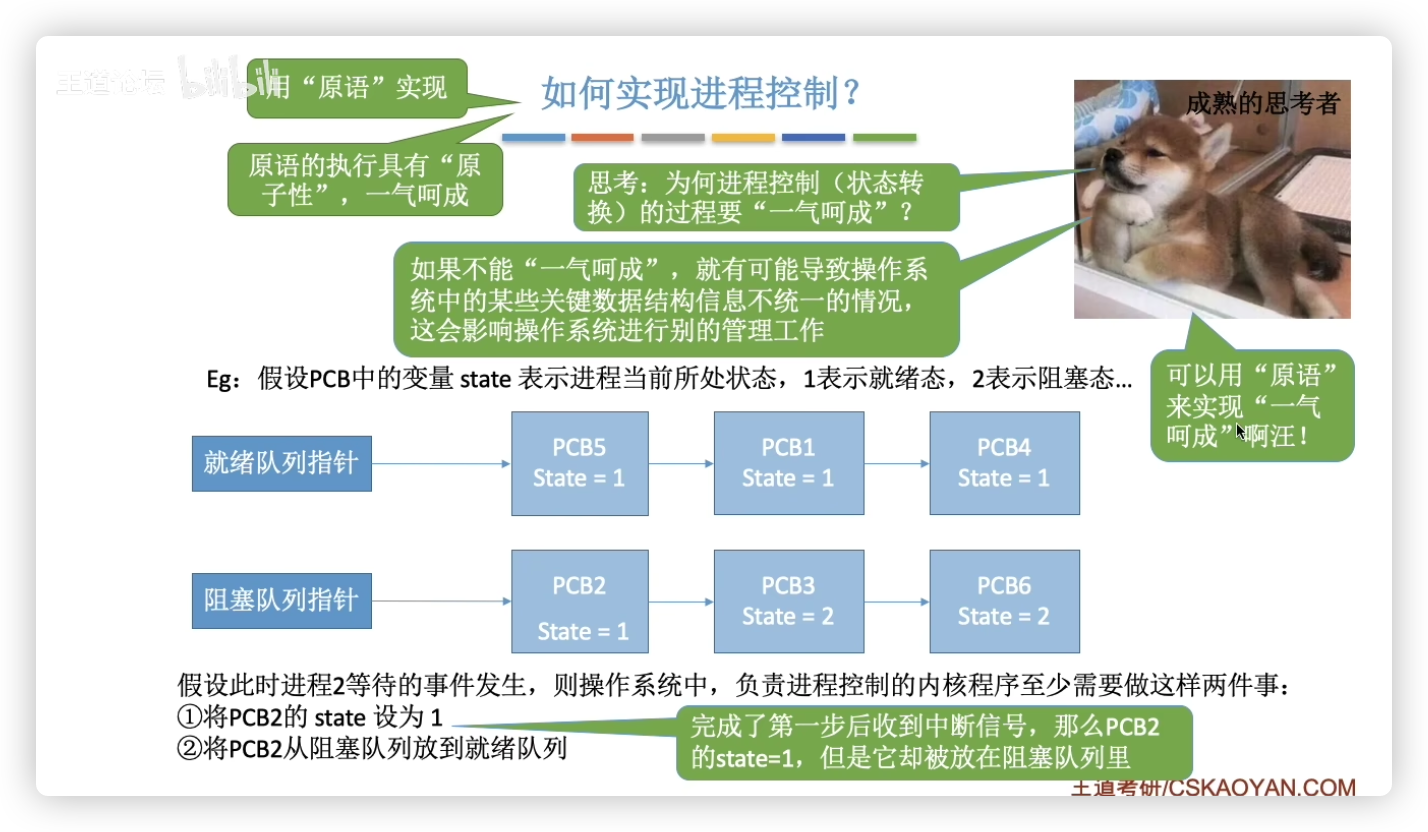
进程控制通常由**进程控制原语(Primitives)**实现。 为什么要用原语?
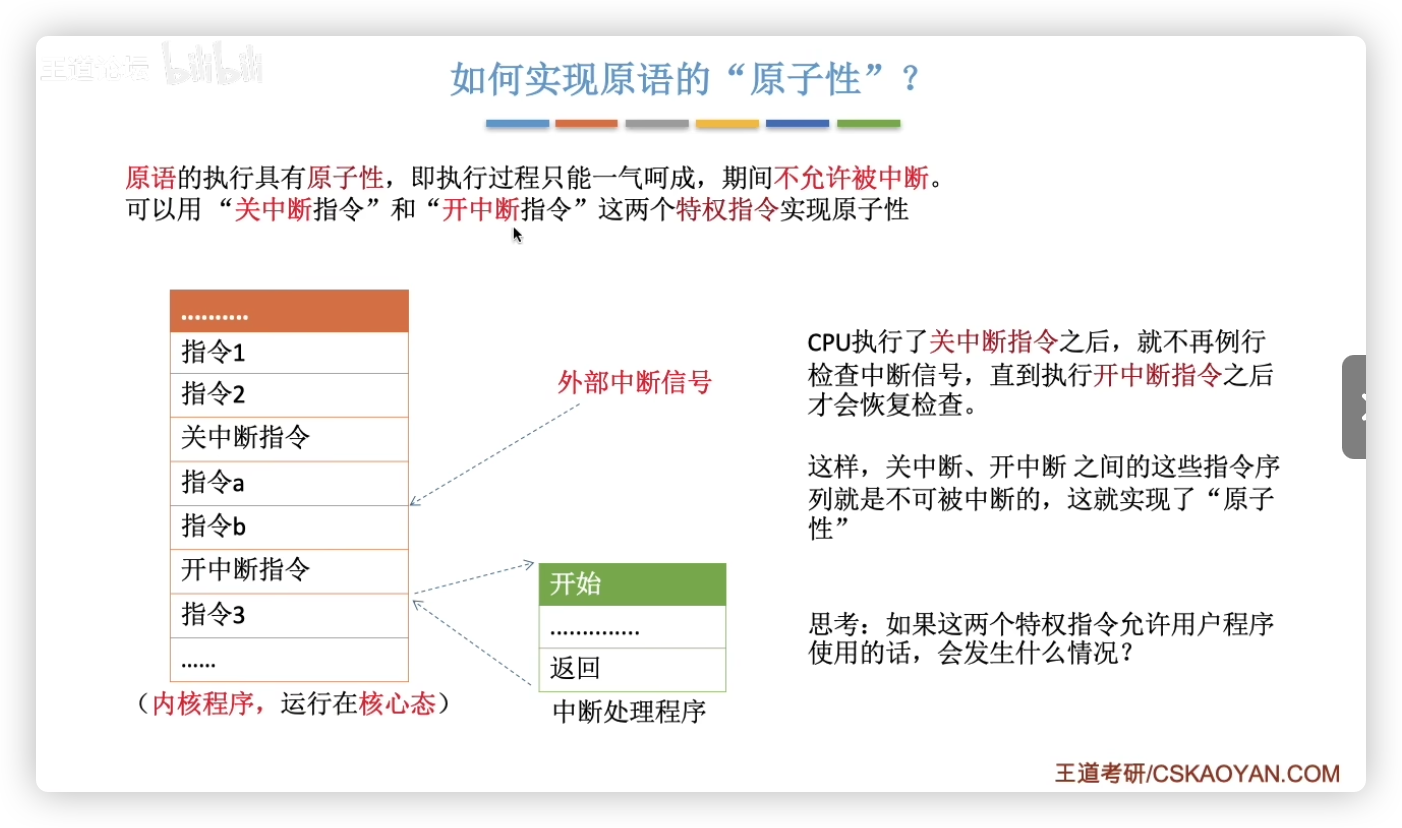
- 原语是原子操作,不可被中断(cpu不会去处理其他中断信号),能保证进程控制的正确性,避免竞态条件(Race Condition)。
- 涉及关键资源的管理,如 PCB 维护、CPU 切换、内存分配等,必须由操作系统核心代码执行。
所有的进程控制原语本质上都做三件事:
- 更新 PCB 信息(修改进程状态、保存/恢复寄存器等)。
- 调整进程队列(如将 PCB 插入/移出就绪队列、阻塞队列等)。
- 分配/回收资源(CPU、内存、I/O 设备等)。
11.3 如何实现原语的原子性
11.4 进程控制的相关原语
进程控制原语是一组由操作系统提供的、不可中断的基本操作,用于 创建、撤销、阻塞、唤醒、切换进程,确保进程状态转换的完整性和一致性。
每个原语在执行时,必须完成更新 PCB 信息、调整进程队列、分配或回收资源等关键任务。
1 进程创建原语(Process Creation Primitive)
创建一个新的进程,使其进入系统并等待 CPU 调度。
实现步骤
- 申请空白 PCB:在进程表中分配一个新的 PCB,并赋予唯一的进程 ID(PID)。
- 分配所需资源:为新进程分配内存(代码段、数据段、堆、栈)、I/O 资源等。
- 初始化 PCB:设置进程初始状态(通常为就绪态),初始化寄存器、程序计数器(PC)。
- 将 PCB 插入就绪队列:等待 CPU 调度。
触发事件
- 用户登录:分时系统中,用户成功登录时创建新进程(如 shell)。
- 作业调度:多道批处理系统中新作业调入时创建进程。
- 提供服务:服务器响应请求时创建新进程(如 HTTP 服务器)。
- 应用请求:应用程序通过
fork()创建子进程。
示例代码
pid_t pid = fork();  // 创建子进程
if (pid == 0) {
    printf("子进程:PID=%d\n", getpid());
} else {
    printf("父进程:PID=%d, 子进程PID=%d\n", getpid(), pid);
}2 进程终止原语(Process Termination Primitive)
撤销一个进程,释放其占用的系统资源。
实现步骤
- 释放进程占用资源:回收内存、I/O 设备、文件等。
- 将进程从调度队列中移除:不再让进程进入 CPU 调度。
- 更新 PCB 状态:标记进程为终止态,并从 PCB 表中删除。
触发事件
- 进程正常退出(程序运行结束)。
- 异常退出(非法操作、崩溃)。
- 父进程终止(子进程可能被撤销)。
- 系统关闭(所有进程终止)。
示例代码
exit(0); // 进程正常退出3 进程阻塞原语(Process Block Primitive)
使进程进入阻塞态,等待某个事件(如 I/O 结束)。
实现步骤
- 保存当前进程的上下文(寄存器、程序计数器 PC、堆栈指针等)到 PCB。
- 修改进程状态为“阻塞态”,从就绪队列移出,加入等待队列。
- 选择新的就绪进程(调度程序从就绪队列挑选)。
- 恢复新进程的上下文,加载它的寄存器和 PC。
- CPU 继续执行新进程。
触发事件
- I/O 操作等待(如
read()等待键盘输入)。 - 资源不可用(请求锁、信号量等)。
- 进程间通信(IPC)(等待消息)。
示例代码
wait(); // 进程等待某个事件4 进程唤醒原语(Process Wake-up Primitive)
将阻塞态的进程唤醒,放入就绪队列等待调度。
实现步骤
- 修改 PCB 状态:将进程状态改为就绪态。
- 从等待队列移入就绪队列。
- 等待 CPU 调度执行。
触发事件
- I/O 结束(进程等待的 I/O 操作完成)。
- 资源变为可用(如锁释放、信号量更新)。
- 收到 IPC 消息(如进程间的
signal())。
示例代码
signal(); // 发送信号唤醒进程5 进程切换原语(Process Switching Primitive)
暂停当前进程,切换到另一个进程执行(上下文切换)。
实现步骤
- 保存当前进程上下文:
- CPU 寄存器(PC、栈指针、通用寄存器)。
- 进程状态(就绪态、阻塞态等)。
- 内存映射信息。
- 选择新进程:
- 从就绪队列中选择优先级最高的进程。
- 恢复新进程上下文:
- 加载新进程的寄存器、PC 值,切换内存空间。
- 执行新进程。
触发事件
- 时间片到期(分时系统)。
- 高优先级进程就绪(抢占式调度)。
- 当前进程进入阻塞态(等待 I/O)。
- 用户或内核主动调用
yield()(让出 CPU)。
示例代码
sched_yield(); // 让出 CPU 触发进程切换11.5 总结
| 原语 | 作用 | 状态转换 | 示例 |
|---|---|---|---|
| 进程创建 | 创建新进程 | 创建态 → 就绪态 | fork() |
| 进程终止 | 撤销进程,释放资源 | 任何态 → 终止态 | exit(0) |
| 进程阻塞 | 进程等待事件 | 运行态 → 阻塞态 | wait() |
| 进程唤醒 | 解除阻塞,进入就绪队列 | 阻塞态 → 就绪态 | signal() |
| 进程切换 | 暂停当前进程,执行新进程 | 运行态 ↔ 就绪态 / 阻塞态 | sched_yield() |
特别注意:
- 阻塞和唤醒必须成对出现,否则进程可能会“永远等待”无法继续执行。
- 进程切换是最消耗性能的,现代操作系统会尽量减少不必要的上下文切换。
12. 进程之间通信
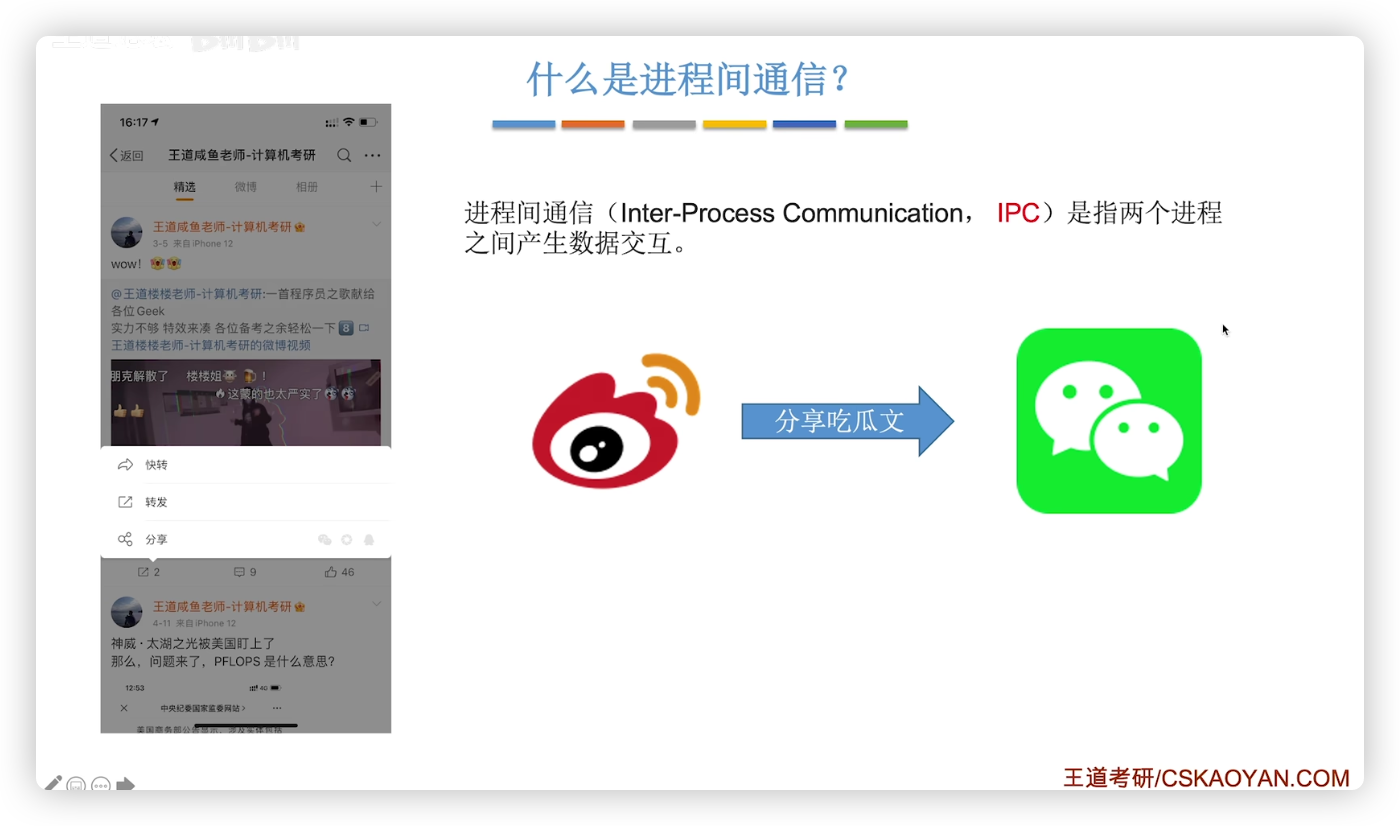
12.1 什么是进程间通信(IPC)?
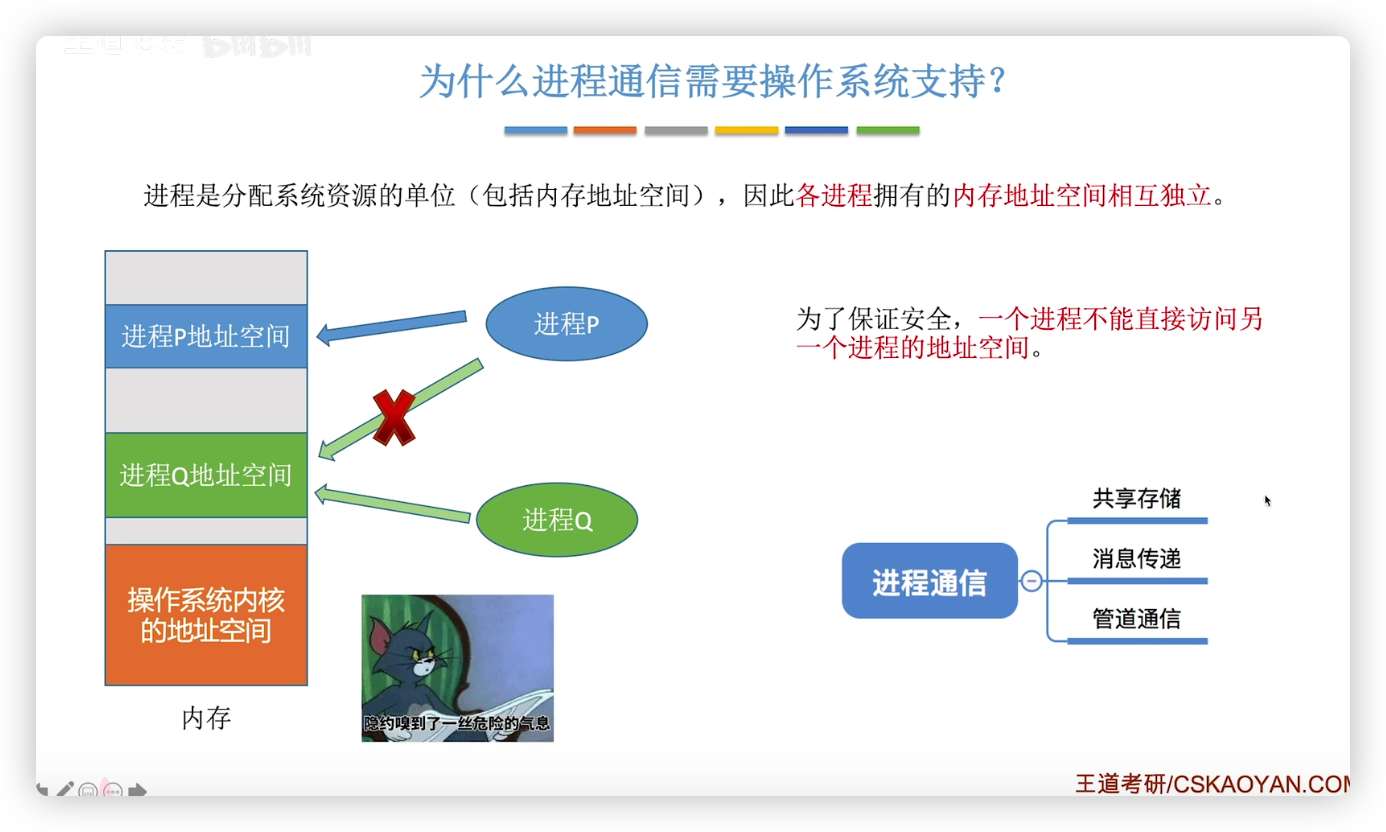
进程间通信(IPC, Inter-Process Communication)是指在不同进程之间交换数据或信息的机制。由于不同进程拥有独立的地址空间,彼此不能直接访问对方的内存,因此必须依靠操作系统提供的 IPC 机制进行交互。
12.2 为什么进程通信需要操作系统支持?
(1)进程的隔离性
- 独立地址空间:进程在不同的地址空间运行,一个进程不能直接访问另一个进程的变量、数据或代码。
- 访问受限:即使一个进程可以访问共享资源(如文件),也需要同步和权限控制,避免数据竞争。
(2)安全性问题
- 防止非法访问:未经授权的进程不能访问其他进程的数据,防止进程劫持、数据泄露。
- 避免资源竞争:多个进程并发访问共享资源时,操作系统必须提供同步机制(如锁、信号量)。
- 隔离进程故障:如果一个进程崩溃或意外修改共享内存,不应影响其他进程的运行。
(3)数据同步和一致性
- 数据完整性:多个进程同时访问共享数据时,系统必须提供同步机制,防止数据竞争(Race Condition) 和 数据不一致(Data Inconsistency)。
- 时序控制:某些进程通信必须保证顺序执行,如生产者-消费者模型。
12.3 方式一:共享存储
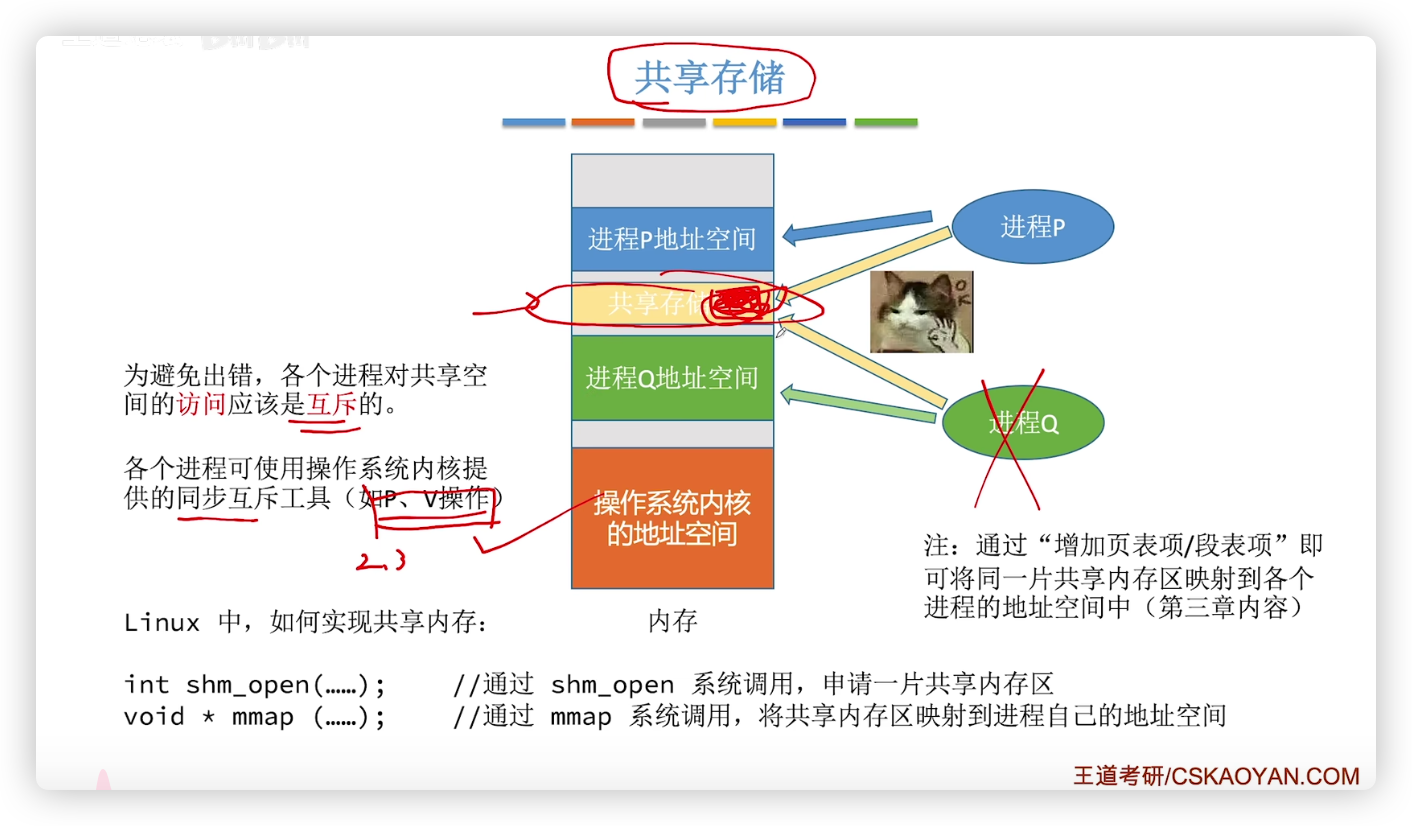
共享存储是 最快的进程间通信方式,它允许多个进程映射同一块物理内存区域,从而直接读写共享数据。不同进程通过操作系统提供的 API 将相同的内存区域映射到各自的地址空间,实现数据共享。
特点
✅ 高效:由于数据交换不需要经过内核,直接在用户态完成,因此速度比消息传递(如管道、消息队列)快。 ✅ 适合大规模数据传输:共享内存可以存储大块数据,不像消息队列那样受限于消息大小。 ⚠️ 需要同步机制:多个进程同时访问共享存储时,需要使用**互斥锁(Mutex)、信号量(Semaphore)*等方式来*防止数据竞争。
实现
在 Linux 下,常见的共享存储方法:
- POSIX 共享内存(shm_open, mmap)
- System V 共享内存(shmget, shmat, shmdt)
示例
#include <stdio.h>
#include <stdlib.h>
#include <sys/ipc.h>
#include <sys/shm.h>
#include <string.h>

int main() {
    int shmid = shmget(1234, 1024, IPC_CREAT | 0666); // 创建共享内存
    char *shmaddr = (char*)shmat(shmid, NULL, 0);    // 进程附加到共享内存
    strcpy(shmaddr, "Hello Shared Memory!");         // 写入数据
    shmdt(shmaddr);                                  // 进程分离
    return 0;
}12.4 方式二:消息传递
消息传递是一种进程间数据交换机制,它通过 发送和接收消息 实现进程间通信,而不共享内存。
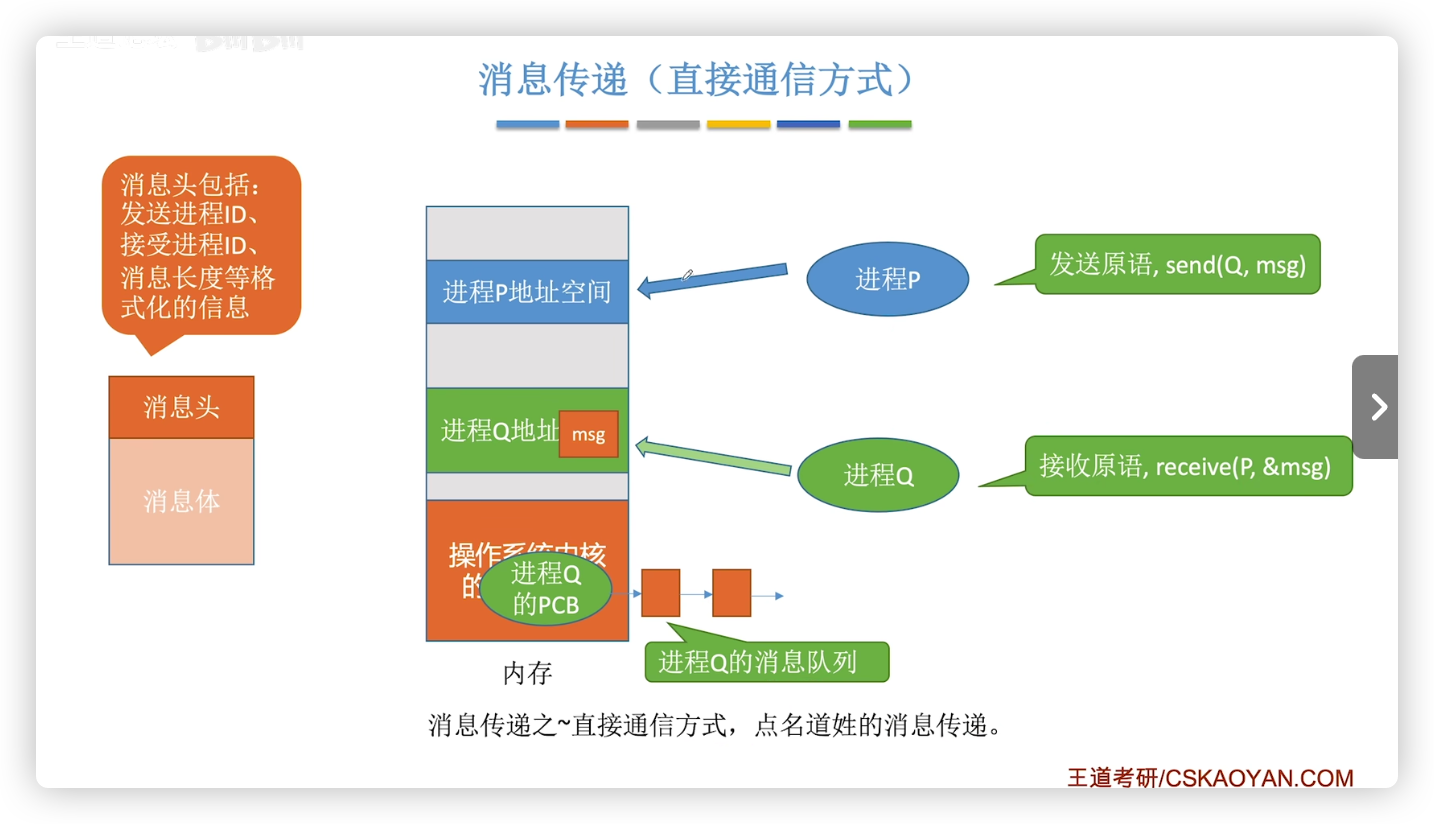
(1)直接通信
- 发送进程和接收进程明确指定对方(如
send(P, message)发送给进程 P)。 - 优点:简单直接,进程可以通过 PID 进行通信。
- 缺点:耦合性高,如果进程 ID 变化,通信关系可能失效。
(2)间接通信
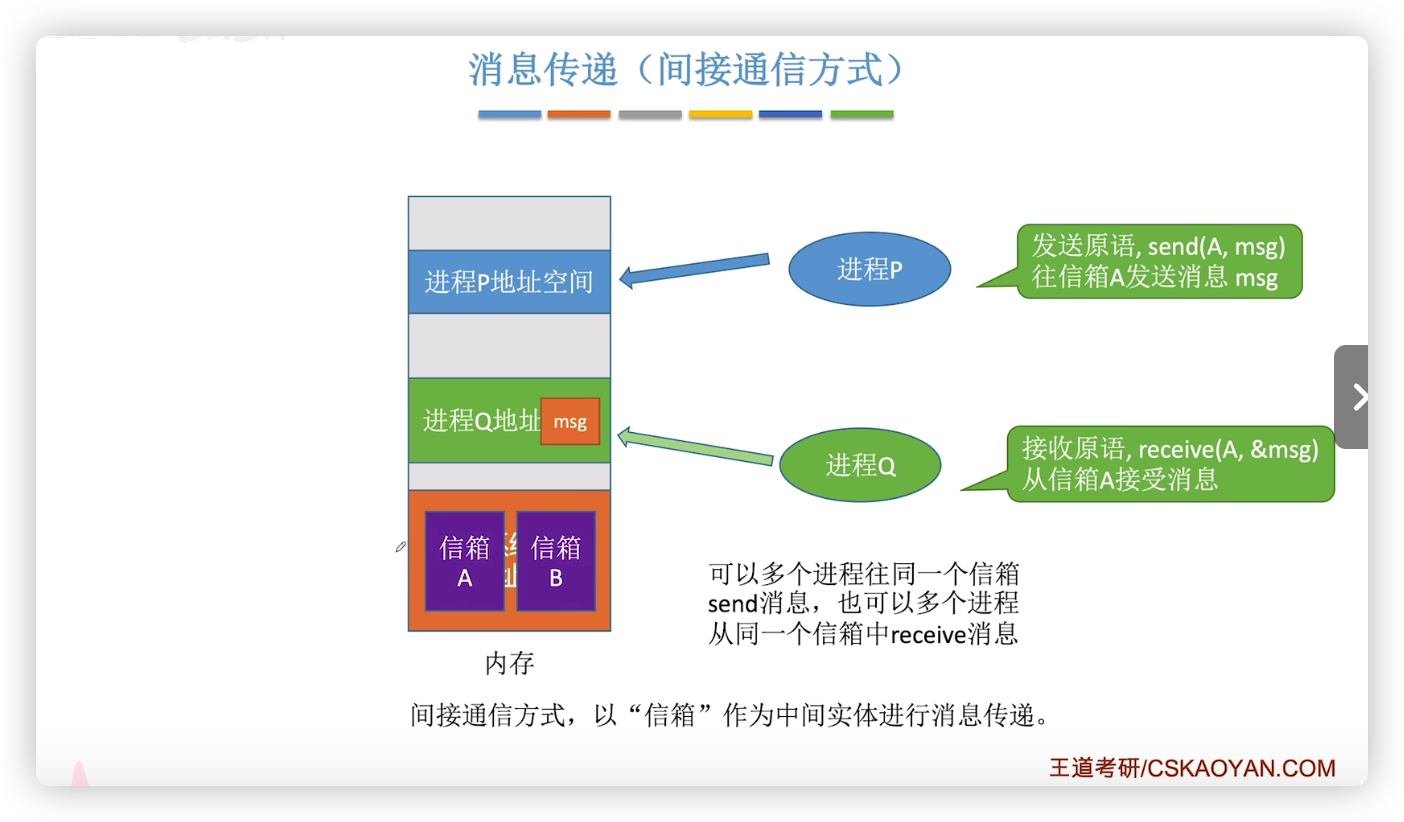
- 使用“邮箱(Message Queue)”作为中介,进程不需要直接知道对方的 PID,而是通过邮箱收发消息。
- 优点:进程间解耦,提高灵活性。
- 缺点:需要操作系统管理邮箱,并提供同步机制。
特点
✅ 适用于分布式系统:可以跨机器通信(如网络消息队列)。 ✅ 进程解耦:发送方和接收方不必共享内存。 ⚠️ 比共享存储慢:消息必须经过内核,需要进行拷贝(从用户态 → 内核态 → 目标进程)。
消息传递的实现
- System V 消息队列(msgget, msgsnd, msgrcv)
- POSIX 消息队列(mq_open, mq_send, mq_receive)
- Socket 通信(支持本地和网络通信)
12.5 方式三:管道通信
管道(Pipe)是一种基于文件的进程间通信机制,它在内存中创建一个固定大小的缓冲区,数据以先进先出(FIFO) 方式传输。
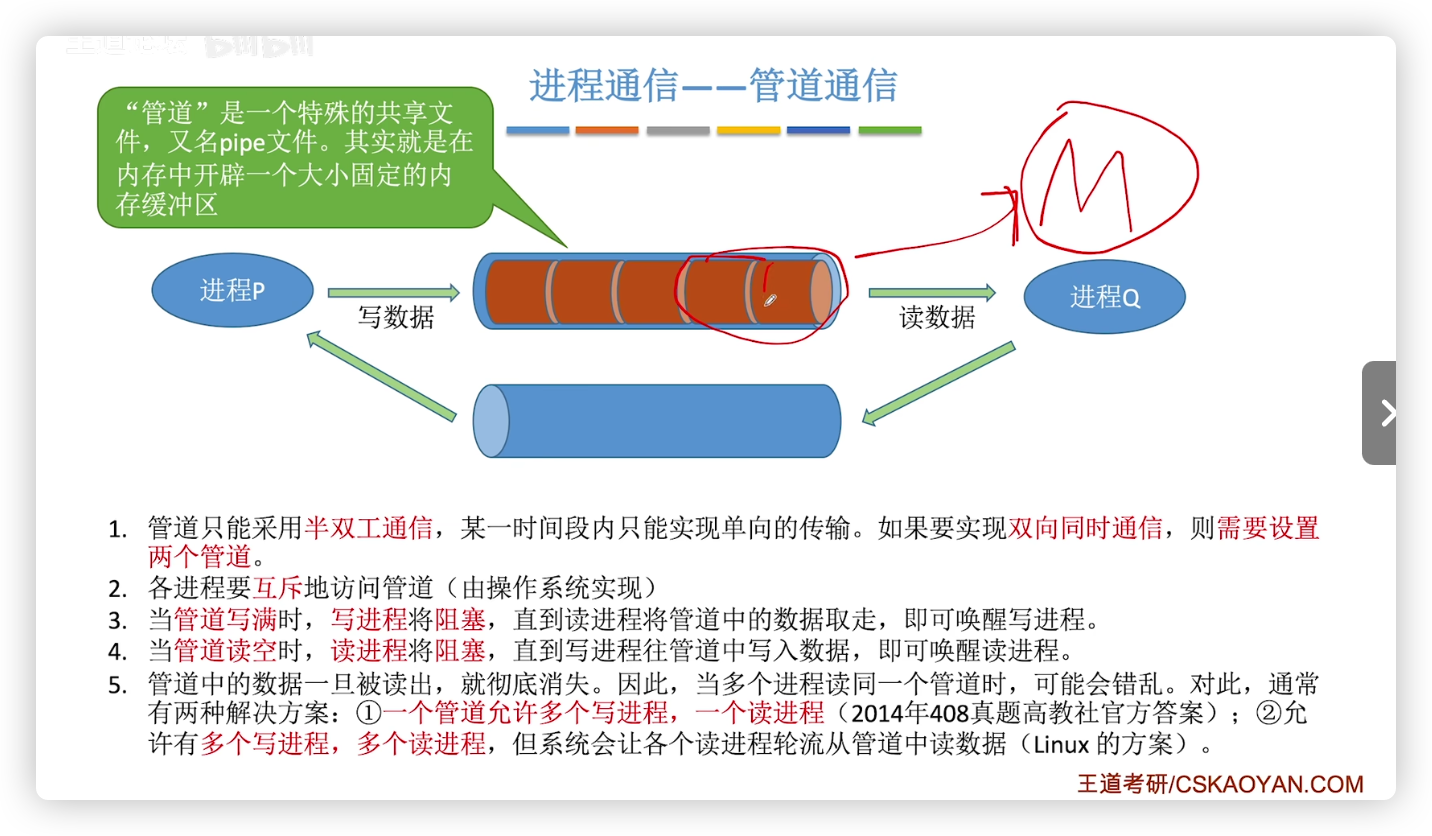
管道的本质:一个特殊的内核缓冲区,用于存储数据,写入数据的一端(写端)和读取数据的一端(读端)相互连接。
管道的特点
✅ 简单易用:适用于父子进程之间的数据流式传输。 ✅ 单向通信:数据只能单向流动(匿名管道),如果需要双向通信,可以使用命名管道(FIFO)。 ⚠️ 不能存储大数据:管道缓冲区大小有限(一般 4KB - 64KB)。 ⚠️ 只能用于具有亲缘关系的进程(父子进程)。
管道和共享存储的区别
| 对比项 | 管道通信 | 共享存储 |
|---|---|---|
| 数据存储 | 内核缓冲区(FIFO) | 共享内存 |
| 访问方式 | 只能通过 read/write 访问 | 直接访问内存 |
| 通信速度 | 较慢(需要系统调用) | 高速(用户态访问) |
| 数据持久性 | 进程终止后数据消失 | 共享存储可持续存在 |
| 适用场景 | 适用于流式数据传输 | 适用于大规模数据共享 |
13. 线程的概念和特点
13.1 为什么要引入线程?
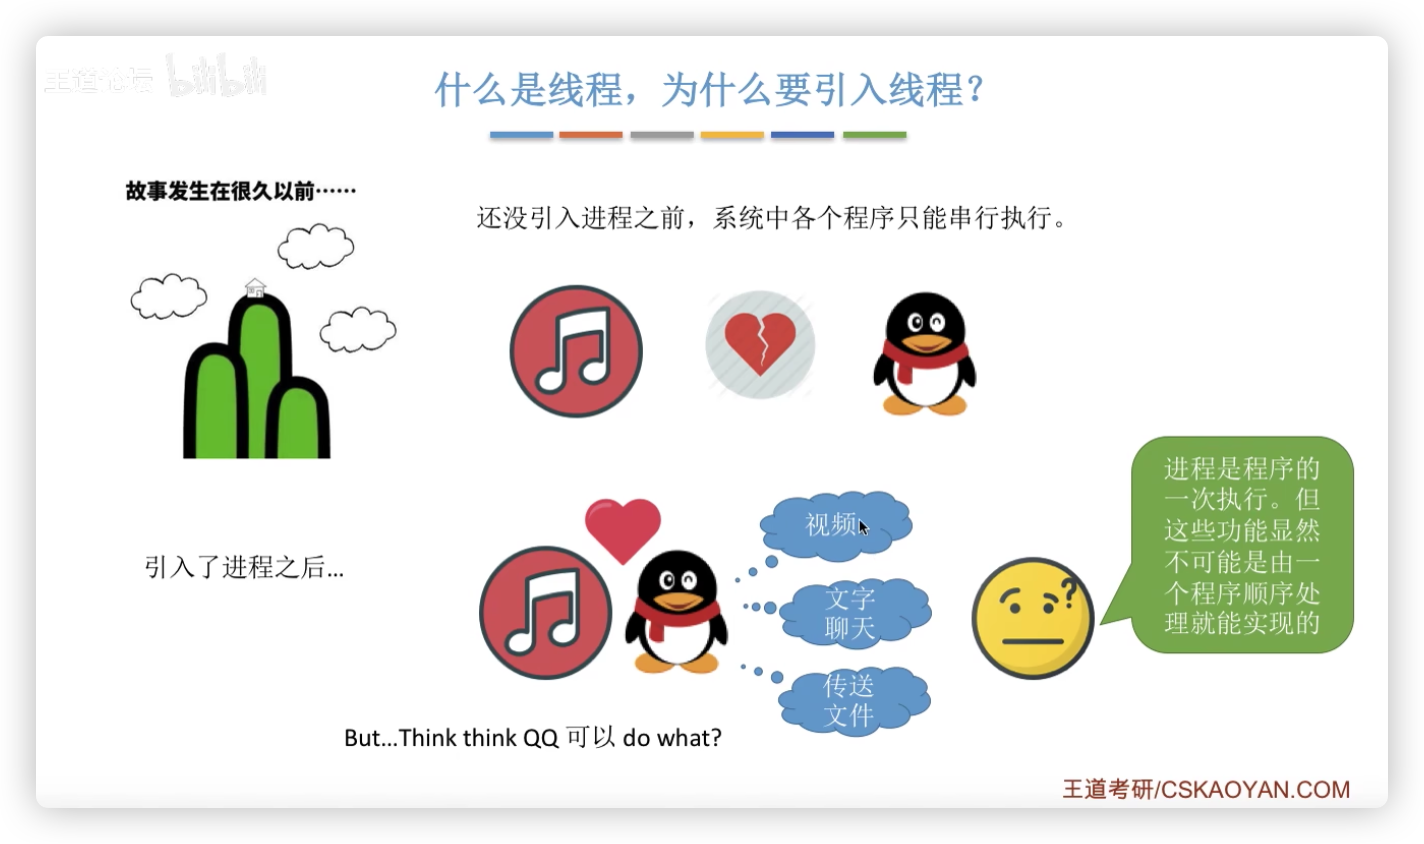
传统的程序通常是以进程为单位进行执行的,一个进程一次只能做一件事。而引入线程后,一个进程可以包含多个线程,每个线程可以并发执行不同的任务,从而提高程序的并发能力和响应速度。
13.2 线程引入带来的变化
1. 资源分配与调度机制的改变
- 传统进程机制: 进程是操作系统进行资源分配和调度的基本单位。每个进程拥有独立的资源(如内存空间、文件描述符等),进程切换时需要保存和恢复完整的上下文信息。
- 引入线程后:
- 进程仍然是资源分配的基本单位。
- 线程成为调度的基本单位。 多个线程共享同一进程的资源,每个线程独立调度,线程切换所需上下文信息远少于进程,因此调度开销更小。
2. 并发性增强
- 传统机制: 并发只能发生在进程之间,每个并发单元都是重量级的进程,系统在调度时需要频繁进行上下文切换,开销较大。
- 引入线程后: 并发不仅可以发生在进程之间,还可以发生在同一进程内部的多个线程之间,显著提升并发度。由于线程之间共享资源,线程切换无需切换整个进程环境,系统开销显著减少。
3. 系统开销的变化
- 进程切换: 涉及内存映射、页表切换、缓存刷新等操作,系统开销大。
- 线程切换: 同一进程内的线程切换只需保存和恢复线程上下文(如寄存器、栈指针等),无需切换地址空间,系统开销小。
13.3 线程切换与进程切换的上下文信息对比
上下文信息是指操作系统在调度一个执行单位(进程或线程)时需要保存和恢复的状态数据,包括寄存器内容、程序计数器(PC)、堆栈指针(SP)、内存映射信息等。
(1)进程切换(Process Switch)
需要保存和恢复的内容包括:
- CPU寄存器(通用寄存器、程序计数器、堆栈指针等)
- 内核栈和用户栈
- 内存管理信息(页表、段表、地址空间映射)
- 文件描述符表、信号处理表等资源
- 缓存失效(TLB flush):进程切换通常伴随地址空间的切换,导致需要清空并重建TLB(Translation Lookaside Buffer)
特点:
- 切换开销大,涉及MMU重新配置和页表切换
- 可能引发缓存未命中,降低执行效率
(2)线程切换(Thread Switch)
如果是在同一进程内的线程之间切换,则只需保存以下内容:
- CPU寄存器(程序计数器、堆栈指针等)
- 线程局部栈(每个线程有独立的用户栈)
- 线程私有的控制块(如线程ID、状态)
不需要切换的内容:
- 页表/内存映射信息(线程共享进程的地址空间)
- 文件描述符、I/O资源(线程共享)
- TLB 通常不需要刷新(因为没有发生地址空间切换)
特点:
- 上下文保存和恢复的内容更少
- 不涉及内存空间切换、缓存刷新,系统开销显著小于进程切换
14. 线程的实现方式和多线程模型
14.1 线程的实现方式
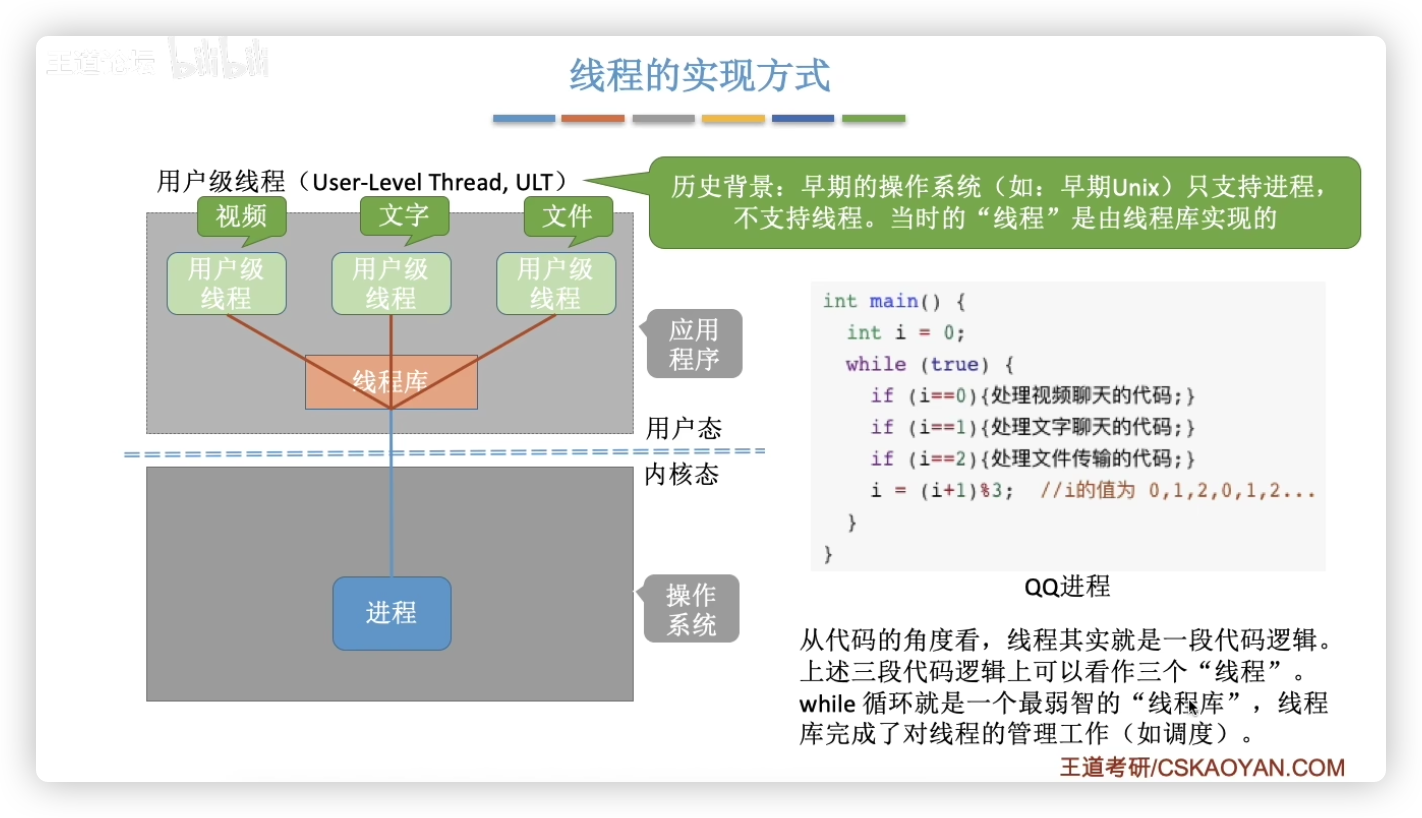
14.1.1 用户级线程(User-Level Thread, ULT)
- 定义: 线程完全由用户空间的线程库管理,操作系统内核感知不到线程的存在。
- 特点:
- 线程创建、销毁、切换等操作开销小,不涉及系统调用,速度快
- 可以在不支持线程的操作系统上实现
- 线程调度由用户级线程库负责,具有高度的灵活性和可控性
- 缺点:
- 缺乏真正的并行性:内核只看到单个进程,即使多个用户线程在运行,操作系统也只能调度一个
- 阻塞问题:当一个用户线程执行阻塞操作(如 I/O)时,整个进程都会阻塞,影响其他线程运行
14.1.2 内核级线程(Kernel-Level Thread, KLT)
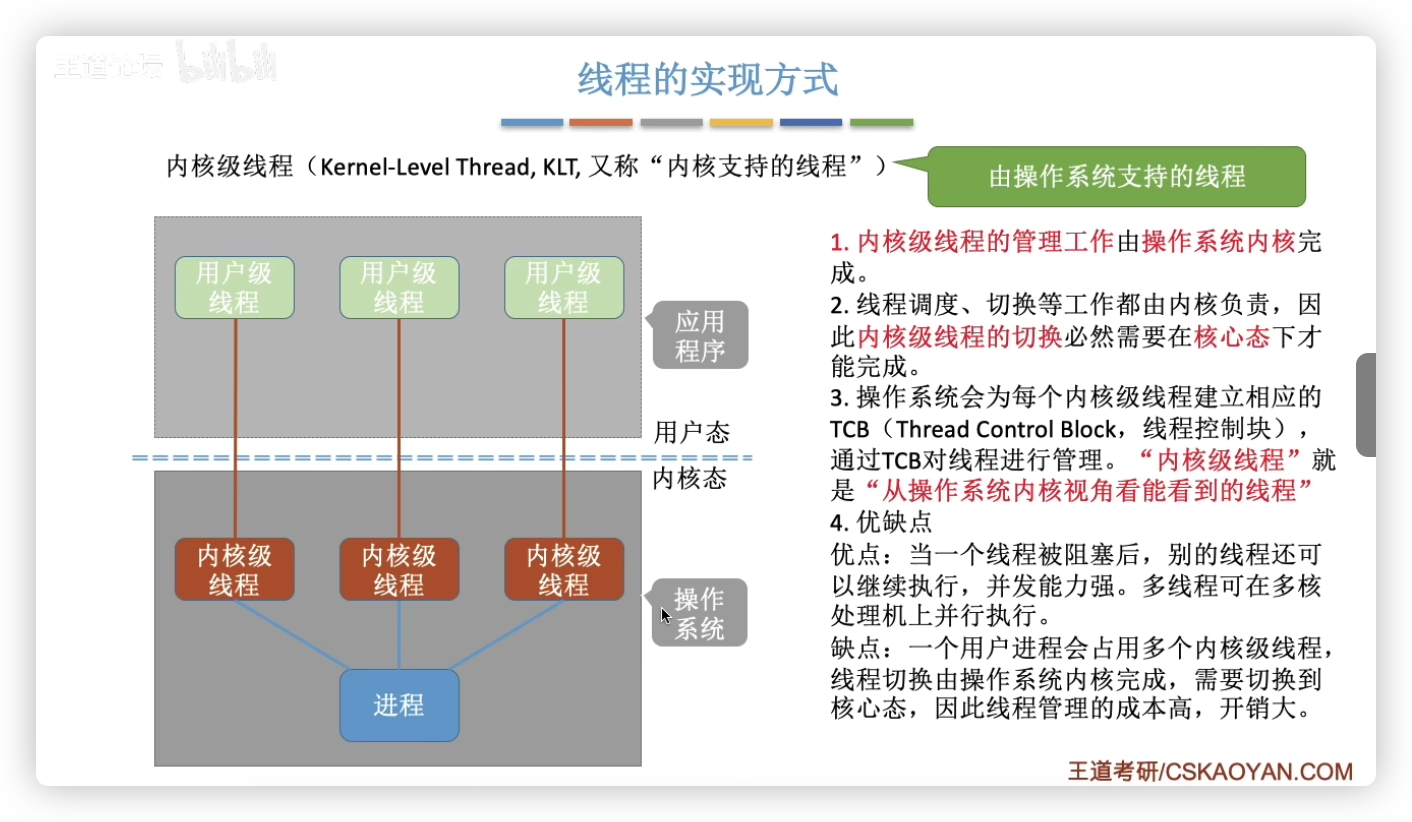
- 定义: 线程由操作系统内核直接支持和管理,内核感知到每一个线程的存在。
- 特点:
- 每个线程作为内核调度的基本单位,可以实现真正的并行执行(在多核处理器上)
- 一个线程阻塞不会影响同一进程的其他线程
- 系统级线程调度机制更健壮
- 缺点:
- 线程操作需要通过系统调用,涉及内核态与用户态切换,开销相对较大
- 创建与销毁线程的成本高于用户级线程
14.2 多线程模型
多线程模型描述了用户线程(User Threads)和内核线程(Kernel Threads)之间的映射关系,主要有三种典型模型:
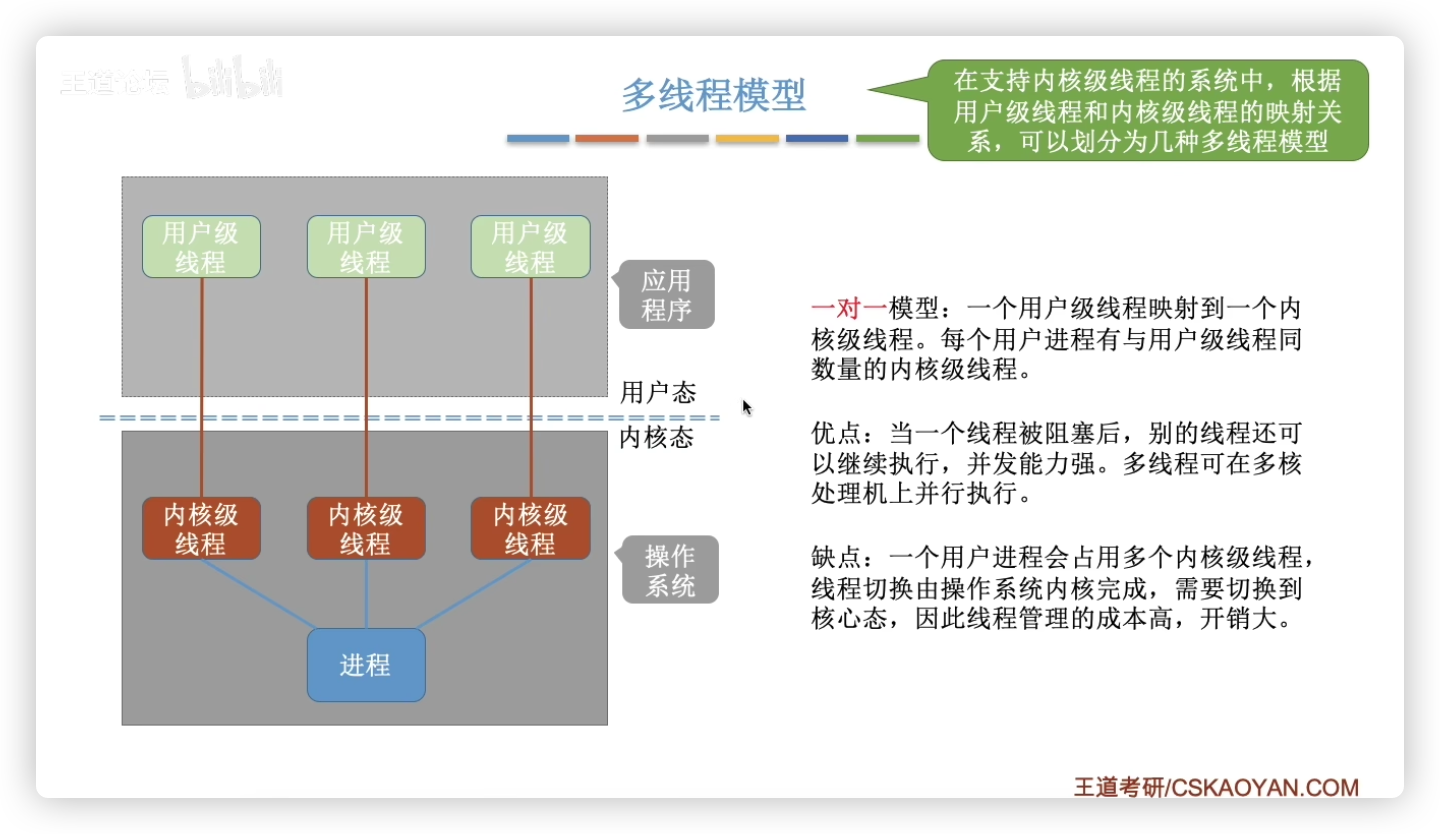
14.2.1 一对一模型(One-to-One Model)
- 定义: 每一个用户线程对应一个内核线程,二者一一映射。
- 优点:
- 支持真正的并发执行
- 线程阻塞不会影响其他线程
- 利用多处理器能力较好
- 缺点:
- 每创建一个用户线程都需创建内核线程,线程数量受限于系统资源
- 创建/销毁线程开销较大
- 代表系统: Linux(使用 POSIX Threads)、Windows
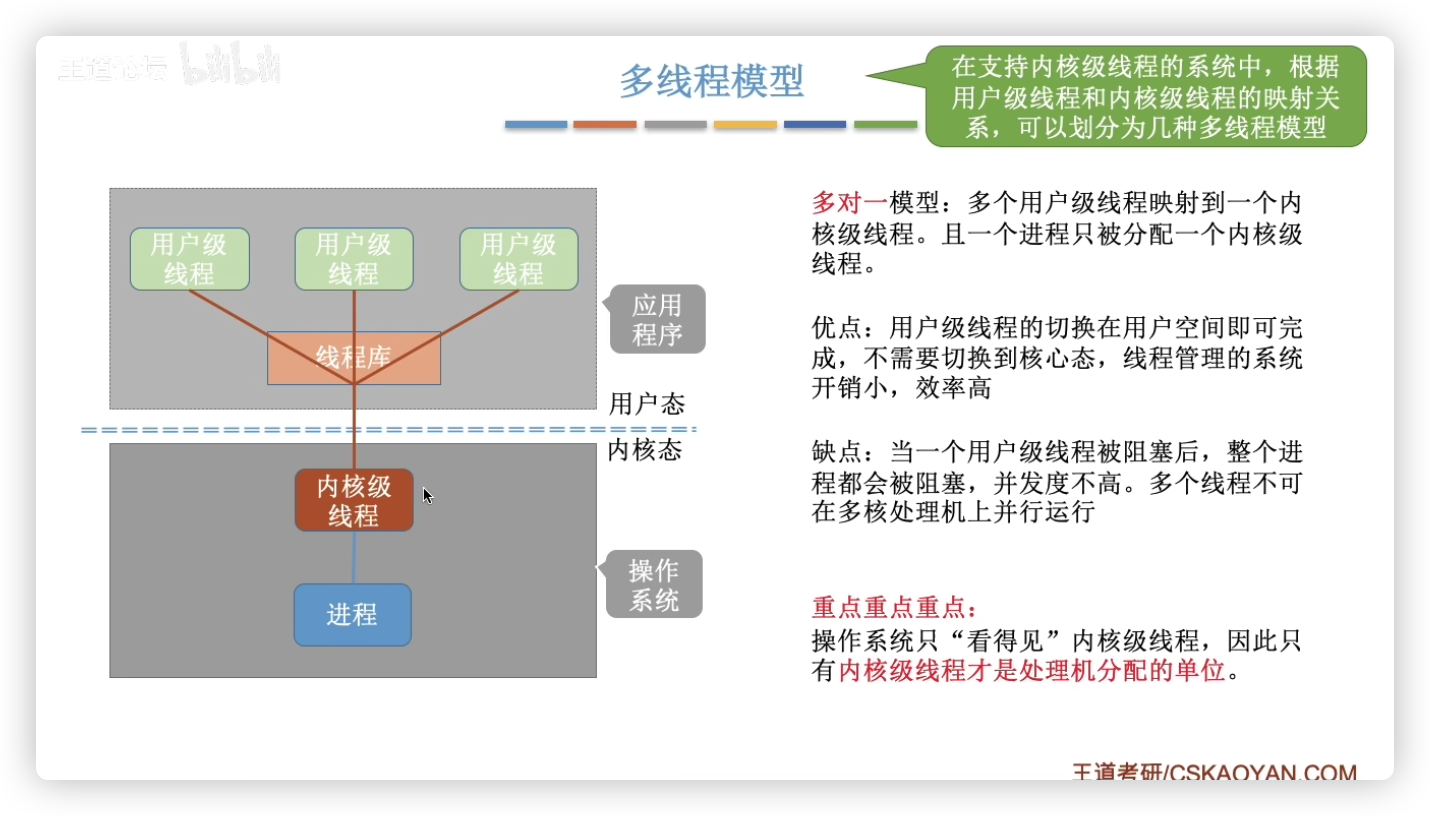
14.2.2 多对一模型(Many-to-One Model)
- 定义: 多个用户线程映射到一个内核线程,由用户线程库管理调度。
- 优点:
- 线程操作快速,无需系统调用
- 更加轻量,线程数量不受内核限制
- 缺点:
- 无法实现并行执行,所有线程共享一个内核执行上下文
- 一个线程阻塞,整个进程阻塞
- 代表系统: 早期的 Solaris、Green Threads(JVM)
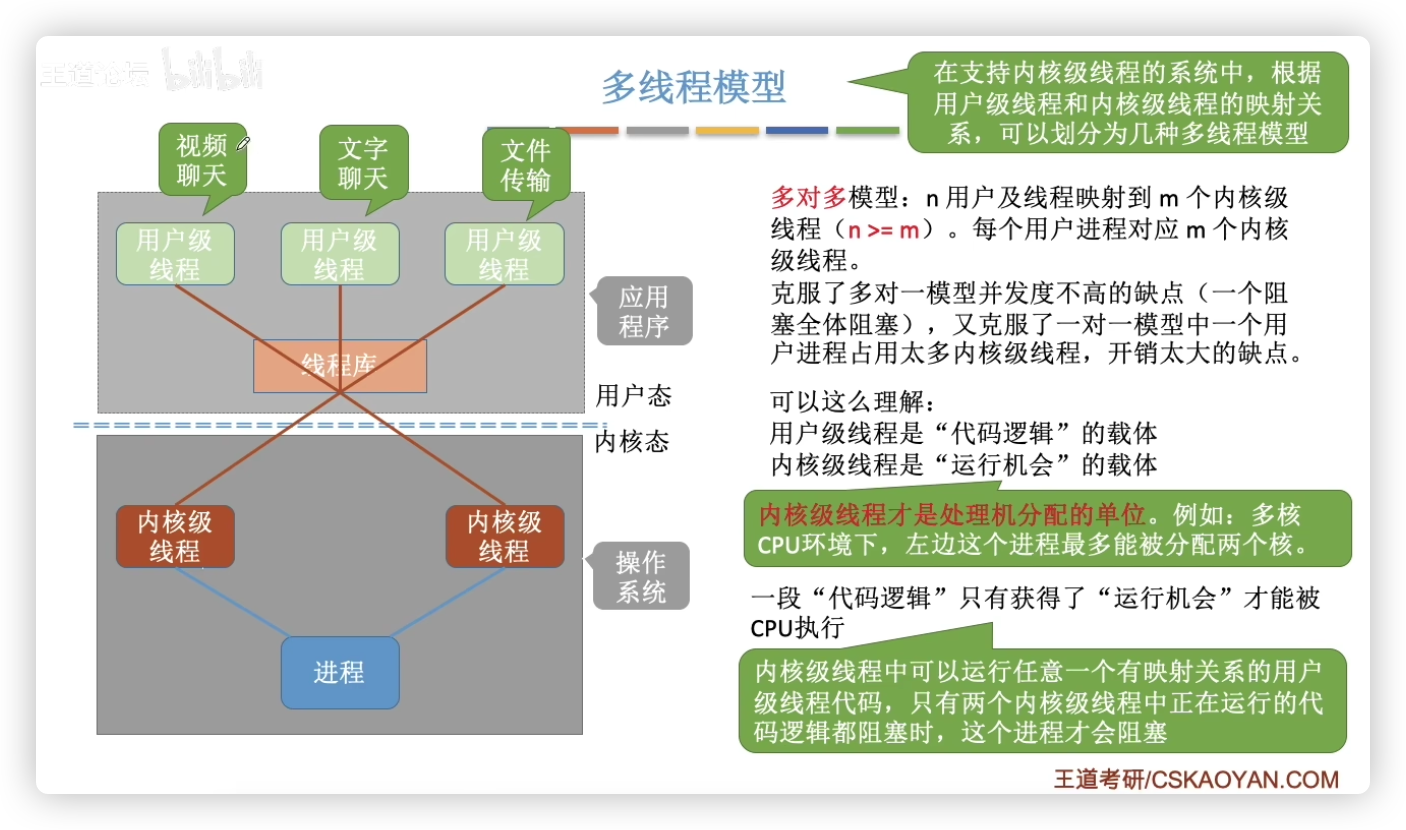
14.2.3 多对多模型(Many-to-Many Model)
- 定义: 多个用户线程映射到等量或更少的内核线程上,映射关系可动态调整。
- 优点:
- 结合前两者的优点:用户线程数量不限,支持并行执行
- 用户线程调度更灵活,且可避免阻塞问题
- 缺点:
- 实现复杂,调度机制需要在用户层和内核层配合
- 上下文切换开销相对适中,但高于纯用户级线程
- 代表系统: Solaris 9 及早期版本、Windows ThreadPool 模型(部分实现)
15. 线程控制
线程控制是操作系统或线程库对线程进行创建、同步、调度与终止等管理操作的总称。本节主要介绍线程的组织结构、控制机制,以及线程的生命周期状态及其转换过程。
15.1 线程的组织与控制
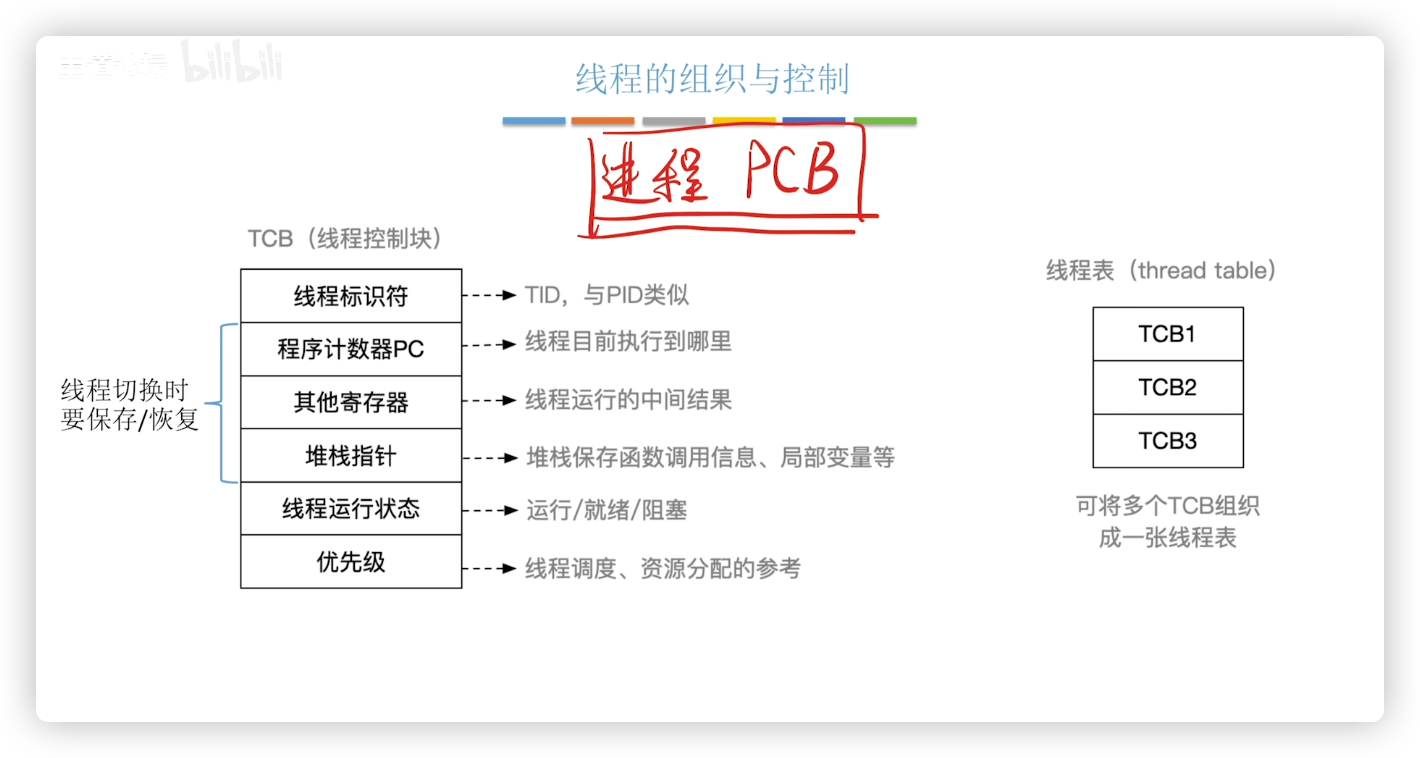
1. 线程控制块(TCB,Thread Control Block)
每个线程由操作系统或线程库通过一个数据结构——**线程控制块(TCB)**进行管理,类似于进程的 PCB。
TCB 通常包含以下信息:
- 线程标识符(Thread ID)
- 程序计数器(PC):指示当前线程执行到的位置
- 寄存器上下文:保存切换时的CPU状态
- 线程栈指针与栈空间
- 线程状态(就绪、运行、阻塞等)
- 优先级
- 调度信息
- 线程局部存储(TLS)指针
- 所属进程指针:线程属于哪个进程(共享资源)
2. 线程的创建与终止
- 创建(Creation): 通常通过系统调用或线程库函数(如 POSIX
pthread_create())创建线程。系统会分配TCB、线程栈等资源。 - 终止(Termination): 包括以下几种情况:
- 线程函数正常返回
- 主线程调用线程终止函数(如
pthread_cancel()) - 整个进程终止(所有线程随之终止)
- 其他控制操作:
- 挂起/恢复(suspend/resume)
- 阻塞/唤醒(block/wakeup)
- 等待线程结束(join)
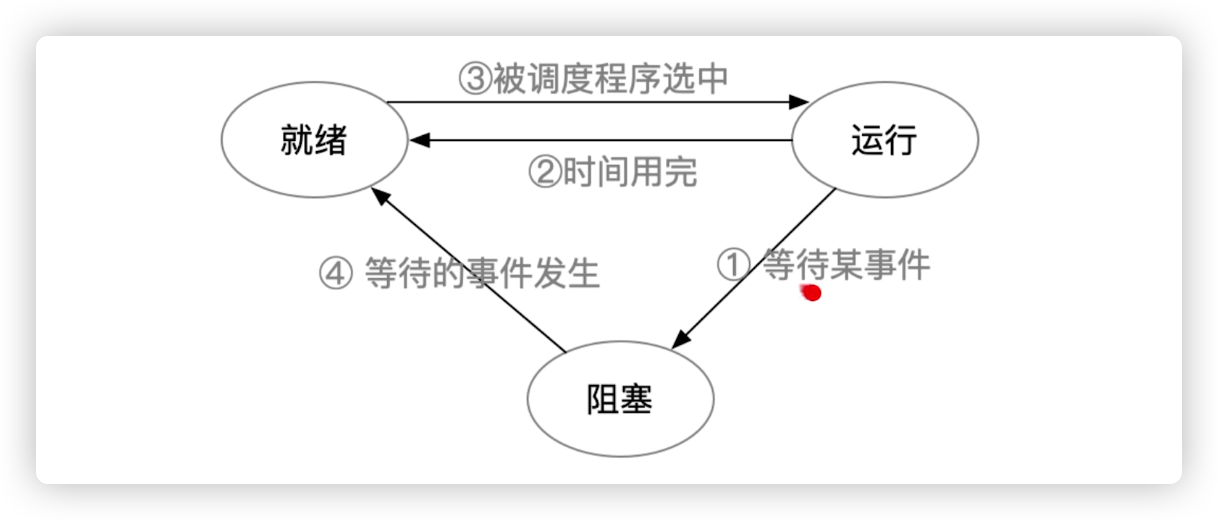
- 新建 → 就绪: 调用创建函数,初始化完成后等待调度
- 就绪 → 运行: 调度器分配 CPU,线程开始执行
- 运行 → 阻塞: 执行阻塞操作(如等待I/O、锁)
- 阻塞 → 就绪: 等待事件完成,重新进入调度队列
- 运行 → 终止: 执行完毕或被终止
- 运行 → 就绪: 被抢占或主动让出 CPU
16. 调度概念
调度是操作系统管理多任务执行的核心机制,目的是合理分配系统资源(如CPU、内存),提高系统的吞吐率、响应时间和资源利用率。根据作用层级和时机,调度可分为高级调度、中级调度、低级调度。

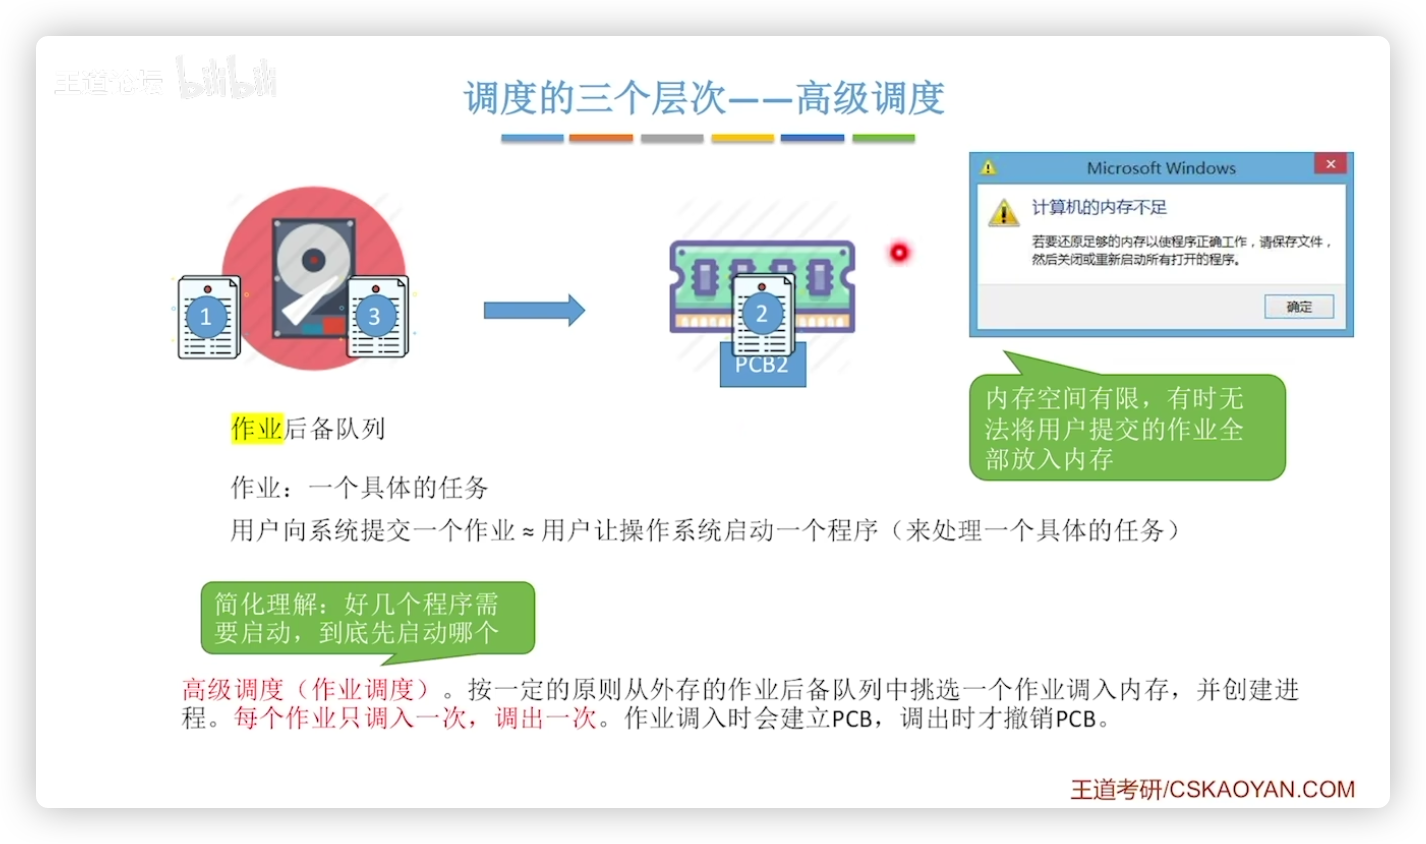
16.1 高级调度
高级调度决定哪些作业(job)可以进入系统成为进程,控制系统的作业负载量。
功能:
- 控制系统中处于就绪队列或内存中的进程数
- 保证系统负载均衡与响应能力
- 决定作业何时转化为进程(调入内存)
特点:
- 调度频率低
- 决策粒度大
- 常用于批处理系统中
策略:
- FCFS(先来先服务)
- 优先级调度
- I/O vs CPU密集型均衡策略(混合作业调度)
示例:
某批处理系统控制“每次最多只允许5个作业进入内存”,其余作业暂时保留在后备队列中。
16.2 中级调度
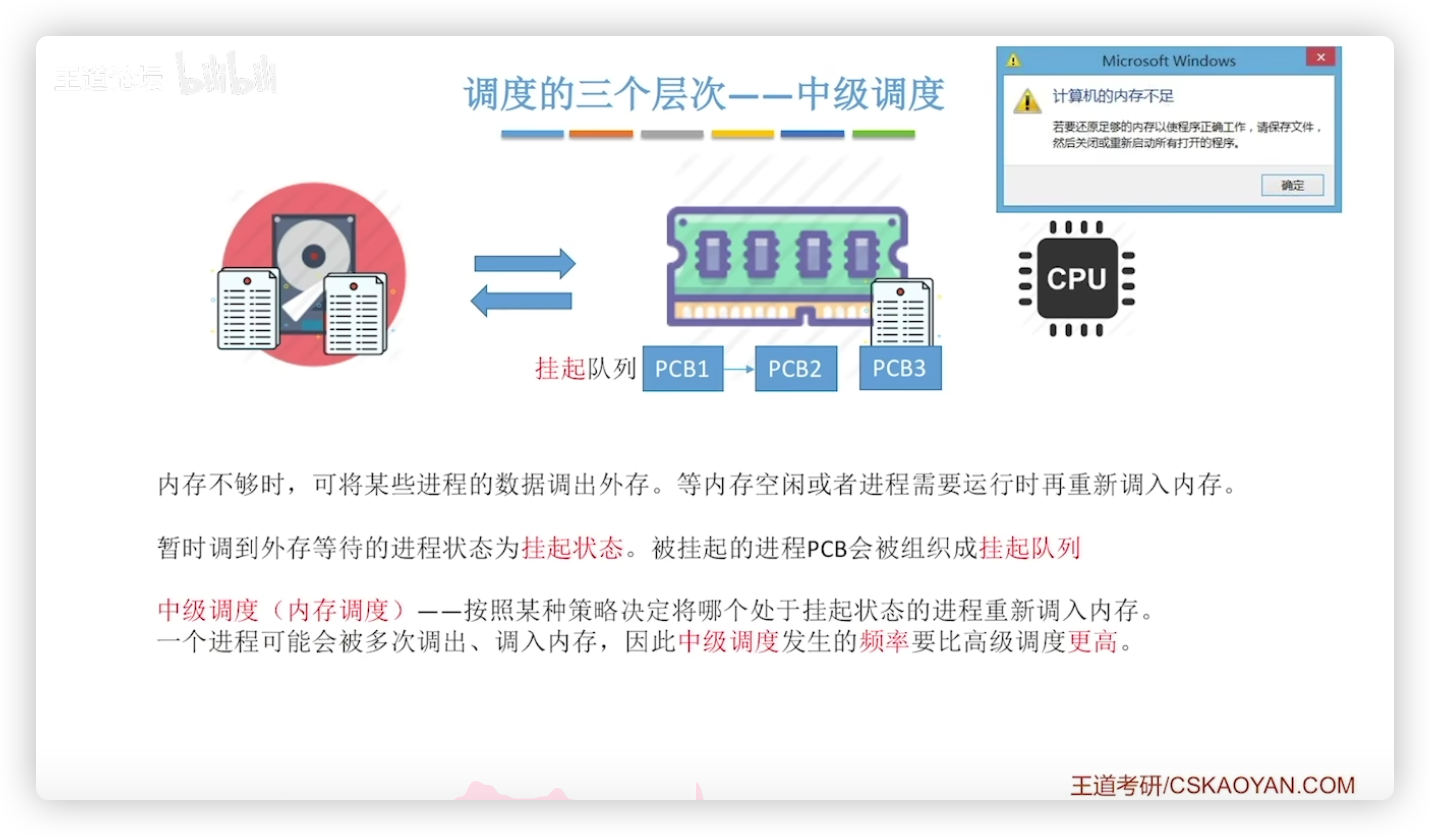
中级调度负责挂起和恢复进程,也称为进程置换调度,它控制内存中进程的数量,缓解内存压力。
功能:
- 实现进程的挂起(Suspend)与恢复(Resume)
- 减少内存占用、避免内存争抢
- 提高多道程序设计的效率
特点:
- 调度频率适中
- 依赖于系统内存压力和资源情况
- 通常与内存管理、虚拟内存机制协作工作
示例:
当系统内存紧张时,操作系统可以将部分阻塞态进程换出到磁盘(挂起),释放内存资源。
16.3 低级调度
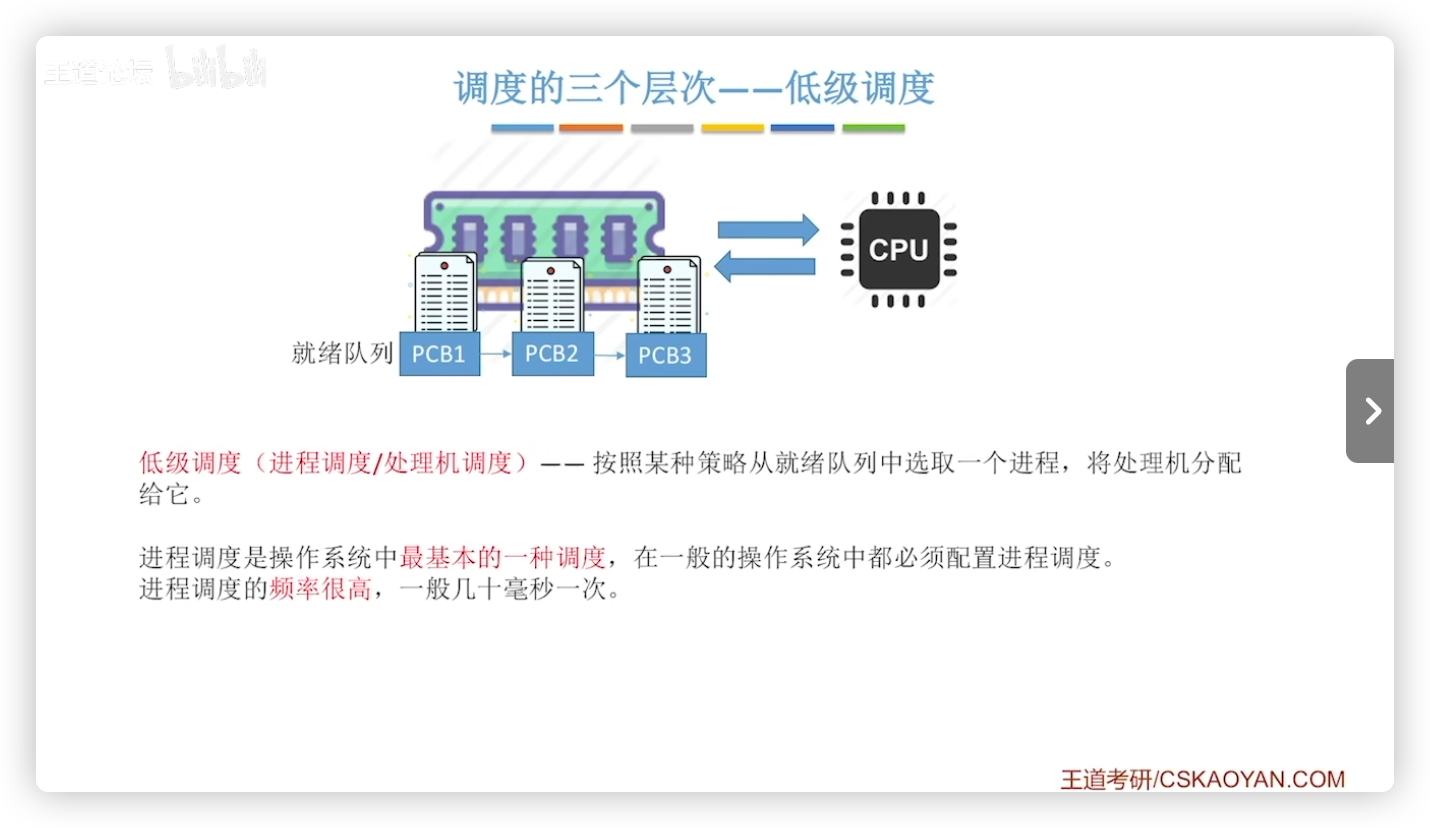
低级调度负责从就绪队列中选择一个进程/线程分配 CPU,是操作系统中最核心、最频繁的调度。
功能:
- 实时响应进程状态变化
- 控制 CPU 分配,影响系统响应时间和吞吐率
- 保证进程公平性和优先级策略
特点:
- 调度频率最高
- 响应速度要求高(通常在毫秒级甚至微秒级)
- 直接影响用户体验和系统性能
常见算法:
- 先来先服务(FCFS)
- 短作业优先(SJF)
- 时间片轮转(RR)
- 优先级调度(Priority Scheduling)
- 多级反馈队列(Multilevel Feedback Queue)
16.4 补充:7状态模型

以下是第17章:进程调度的完整内容整理与专业术语翻译,包括调度时机、不可调度情形,以及调度方式(抢占/非抢占)。
17. 进程调度
进程调度属于低级调度,其任务是在多个就绪进程中根据某种算法选择一个进程分配处理器资源(CPU),并进行上下文切换。
17.1 进程调度的时机
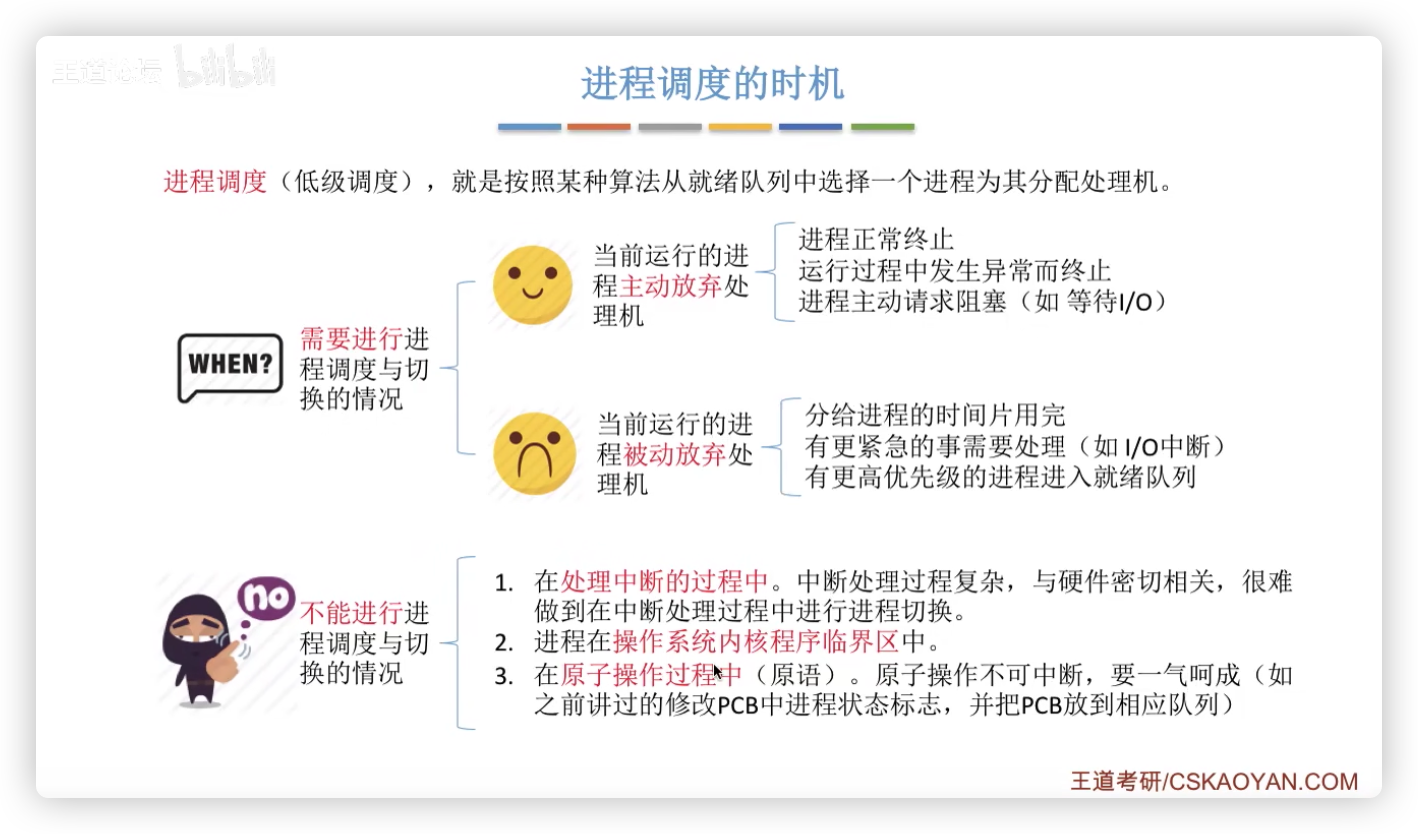
操作系统需要在特定的时机进行进程调度和切换,这些时机可以分为主动放弃和被动剥夺两大类:
(1)需要进行调度的情形:
| 事件类型 | 描述 |
|---|---|
| 进程主动放弃处理器 | 1. 进程正常终止 2. 运行中发生异常导致终止 3. 主动请求阻塞(如等待 I/O) |
| 进程被动放弃处理器(抢占) | 1. 时间片用完 2. 有更高优先级的进程进入就绪队列 3. 系统处理中断事件(如I/O完成)后唤醒了高优先级进程 |
17.12不能进行调度切换的情形:
某些关键时刻不能进行进程切换,以防系统状态不一致或破坏关键操作:
- 处理中断期间(In Interrupt Handler)
- 中断处理程序执行过程中不能切换进程,因为涉及硬件操作和中断栈的维护,状态切换复杂。
- 操作系统内核的临界区中(In Kernel Critical Section)
- 临界区内进行的是对关键数据结构的访问(如进程控制块),切换可能导致数据竞争或破坏一致性。
- 执行原子操作期间(In Atomic Operation)
- 原子操作必须“不可中断”完成(如状态标志修改、队列插入等),否则会造成系统行为异常。
17.2 进程调度方式
调度方式可分为以下两类:
(1)非抢占式调度
- 一旦调度器将 CPU 分配给某个进程,该进程必须运行到完成、阻塞或主动让出 CPU,才会触发下一次调度。
- 进程切换由当前进程控制
- 实现简单,避免频繁切换
- 适用于协作式系统或实时性要求不高的场景
示例算法:先来先服务(FCFS)、短作业优先(SJF,非抢占式)
(2)抢占式调度
- 操作系统可以在任意时刻剥夺正在运行的进程的 CPU 使用权,如时间片耗尽、优先级变化等。
- 调度器主动介入控制 CPU 分配
- 响应性高,支持高优先级任务快速执行
- 需要更复杂的同步机制(如临界区保护)
示例算法:时间片轮转(RR)、优先级调度、SJF(抢占式)、多级反馈队列
18. 进程调度算法
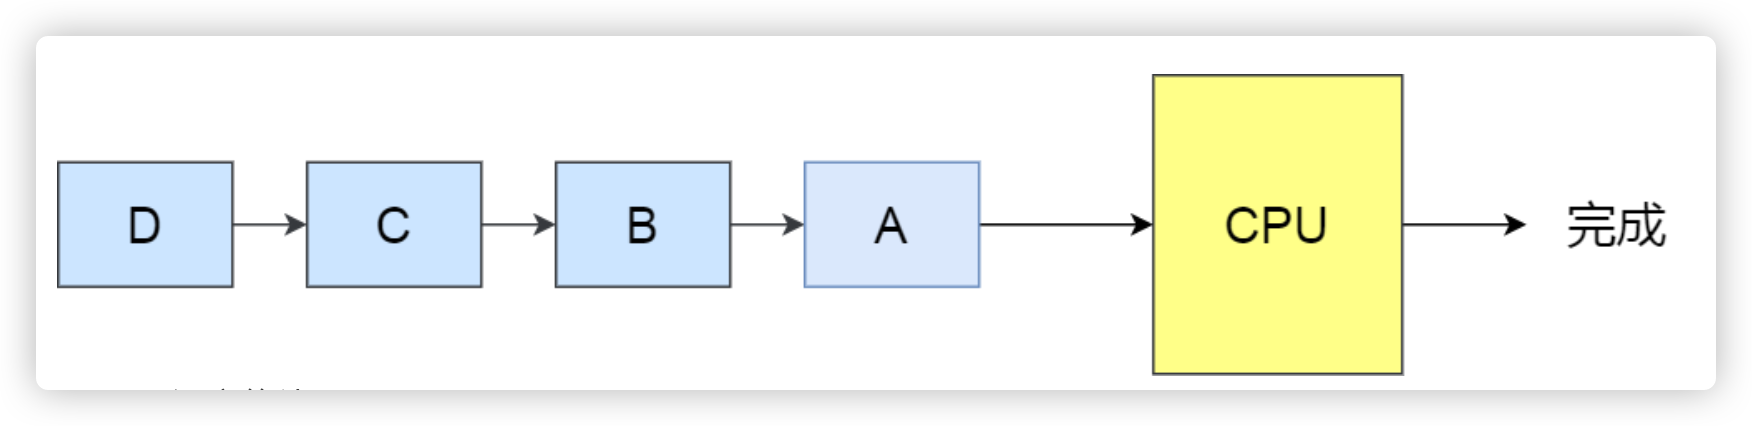
18.1 先来先服务调度算法(FCFS, First-Come, First-Served)
- 基本思想:按进程到达就绪队列的先后顺序进行调度。
- 特点:
- 简单易实现,公平性较好。
- 对 长作业有利,对 短作业不友好,可能造成“长进程阻塞短进程”。
- 是否抢占:❌ 非抢占式
- 适用场景:批处理系统
18.2 最短作业优先调度算法(SJF, Shortest Job First)
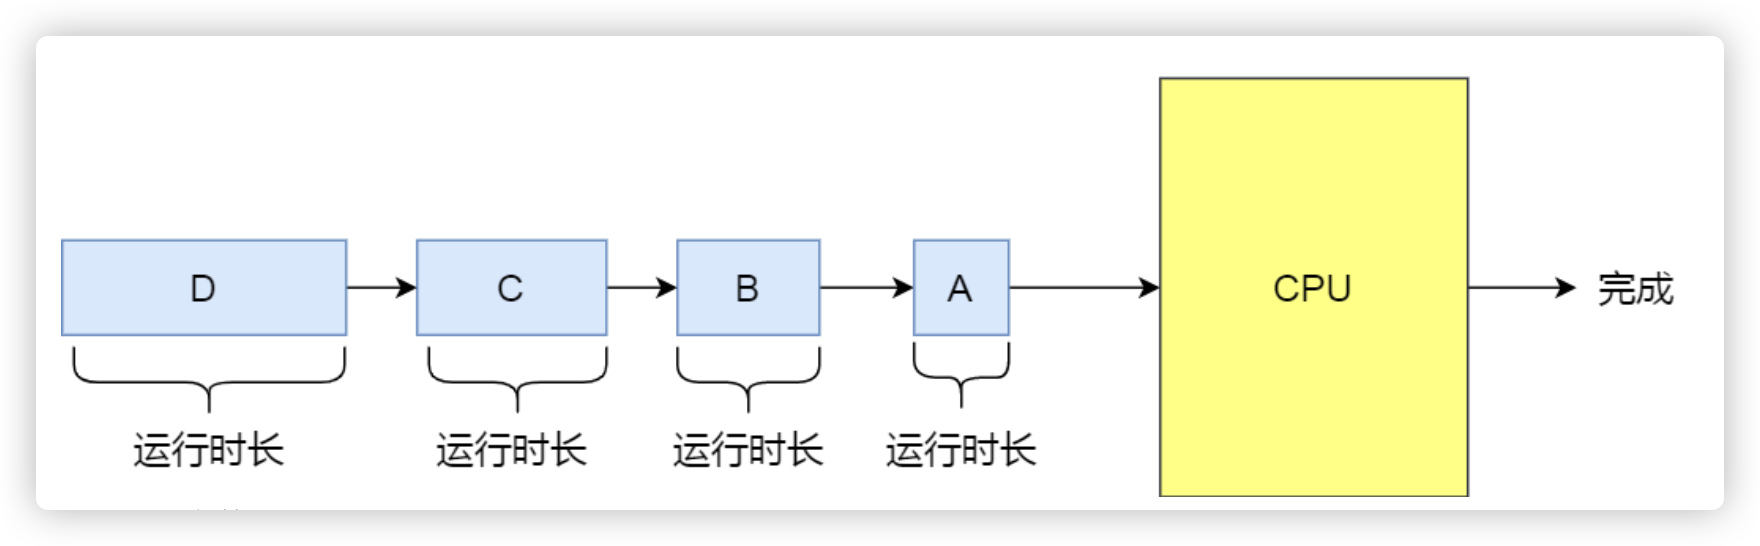
- 基本思想:优先调度预计 运行时间最短 的进程。
- 变体:
- 非抢占式 SJF:选中进程后运行到结束。
- 抢占式 SJF(也叫 SRTF,Shortest Remaining Time First):若新进程预计运行时间更短,会抢占当前进程。
- 特点:
- 可实现最小平均等待时间。
- 不公平,可能导致长作业饥饿。
- 难点在于:无法准确预测进程的执行时间。
- 是否抢占:可抢占 / 非抢占都有
- 适用场景:适用于对响应时间要求较高但运行时间易估计的场景。
18.3 高响应比优先调度算法(HRRN, Highest Response Ratio Next)
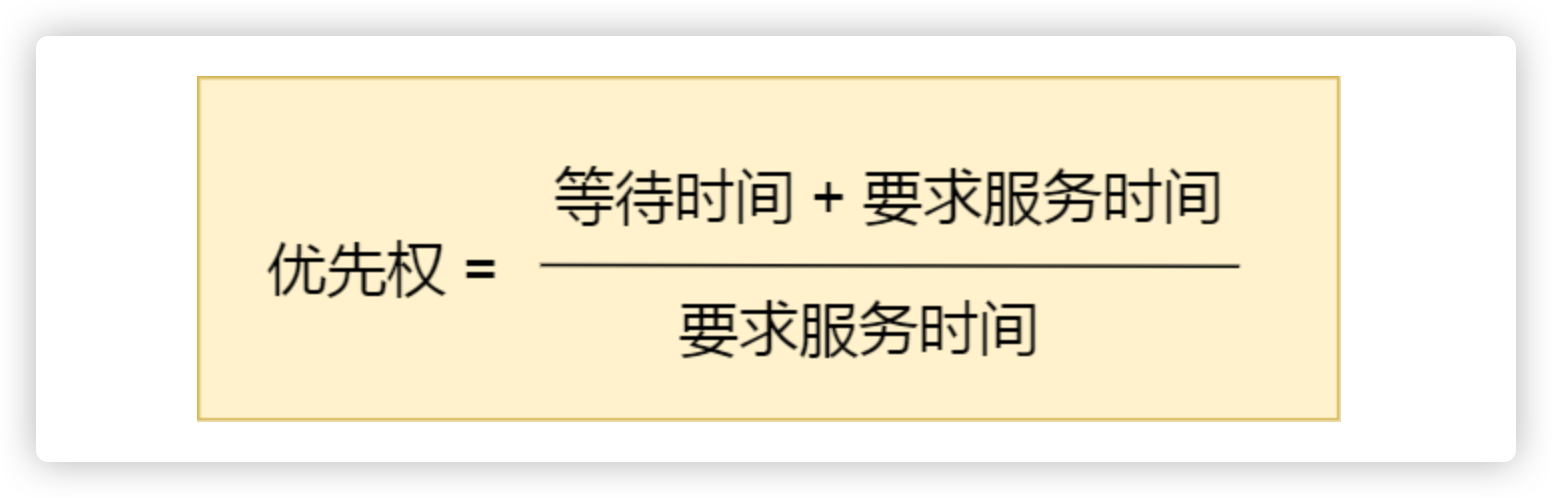
基本思想:计算每个就绪进程的“响应比”,选择响应比最高的进程。
响应比公式:
其中:
:等待时间 :服务时间(估计运行时间)
特点:
- 兼顾短作业和长作业。
- 随着等待时间增加,长作业响应比上升,可避免饥饿现象。
- 是非抢占式的 SJF 的改进型。
是否抢占:❌ 非抢占式
适用场景:适用于用户交互型系统。
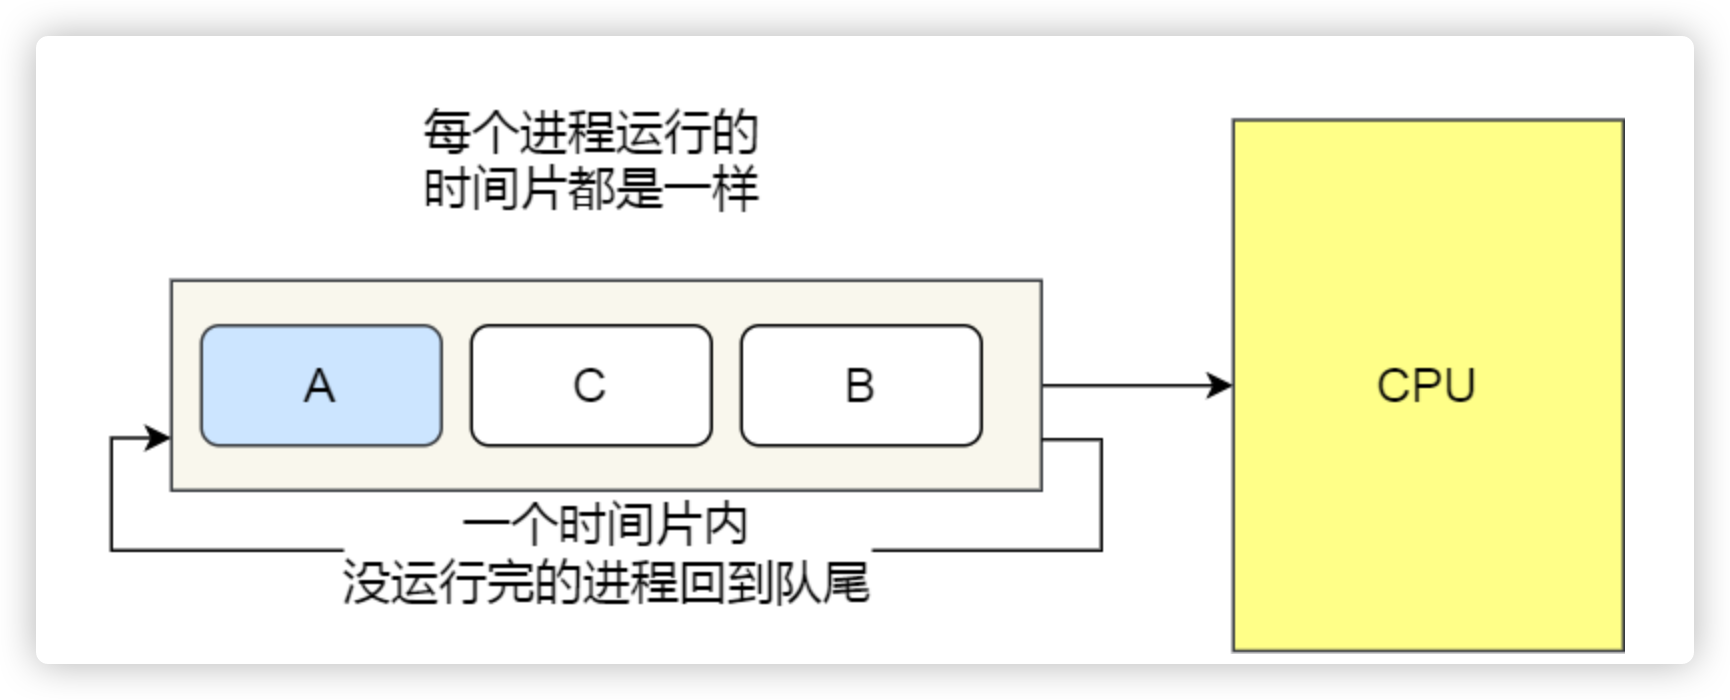
18.4 时间片轮转调度算法(RR, Round Robin)
- 基本思想:为每个进程分配固定时间片,时间片到 → 换下一个。
- 特点:
- 简单、公平性强,每个进程平均获得 CPU 时间。
- 响应速度快,适合交互式系统。
- 时间片长度选择需平衡性能:
- 太小 → 上下文切换频繁,系统开销大
- 太大 → 响应时间慢,接近 FCFS
- 是否抢占:✅ 抢占式
- 适用场景:交互式系统、多用户系统
18.5 最高优先级调度算法(Priority Scheduling)
- 基本思想:为每个进程设置一个优先级,优先级高者先调度。
- 变体:
- 静态优先级(创建时确定)
- 动态优先级(等待时间越长优先级上升,防止饥饿)
- 是否抢占:✅ 支持抢占式(也可以非抢占)
- 特点:
- 灵活,可适配多种策略
- 可能导致低优先级进程长期得不到调度(饥饿)
- 适用场景:实时系统、分级服务系统
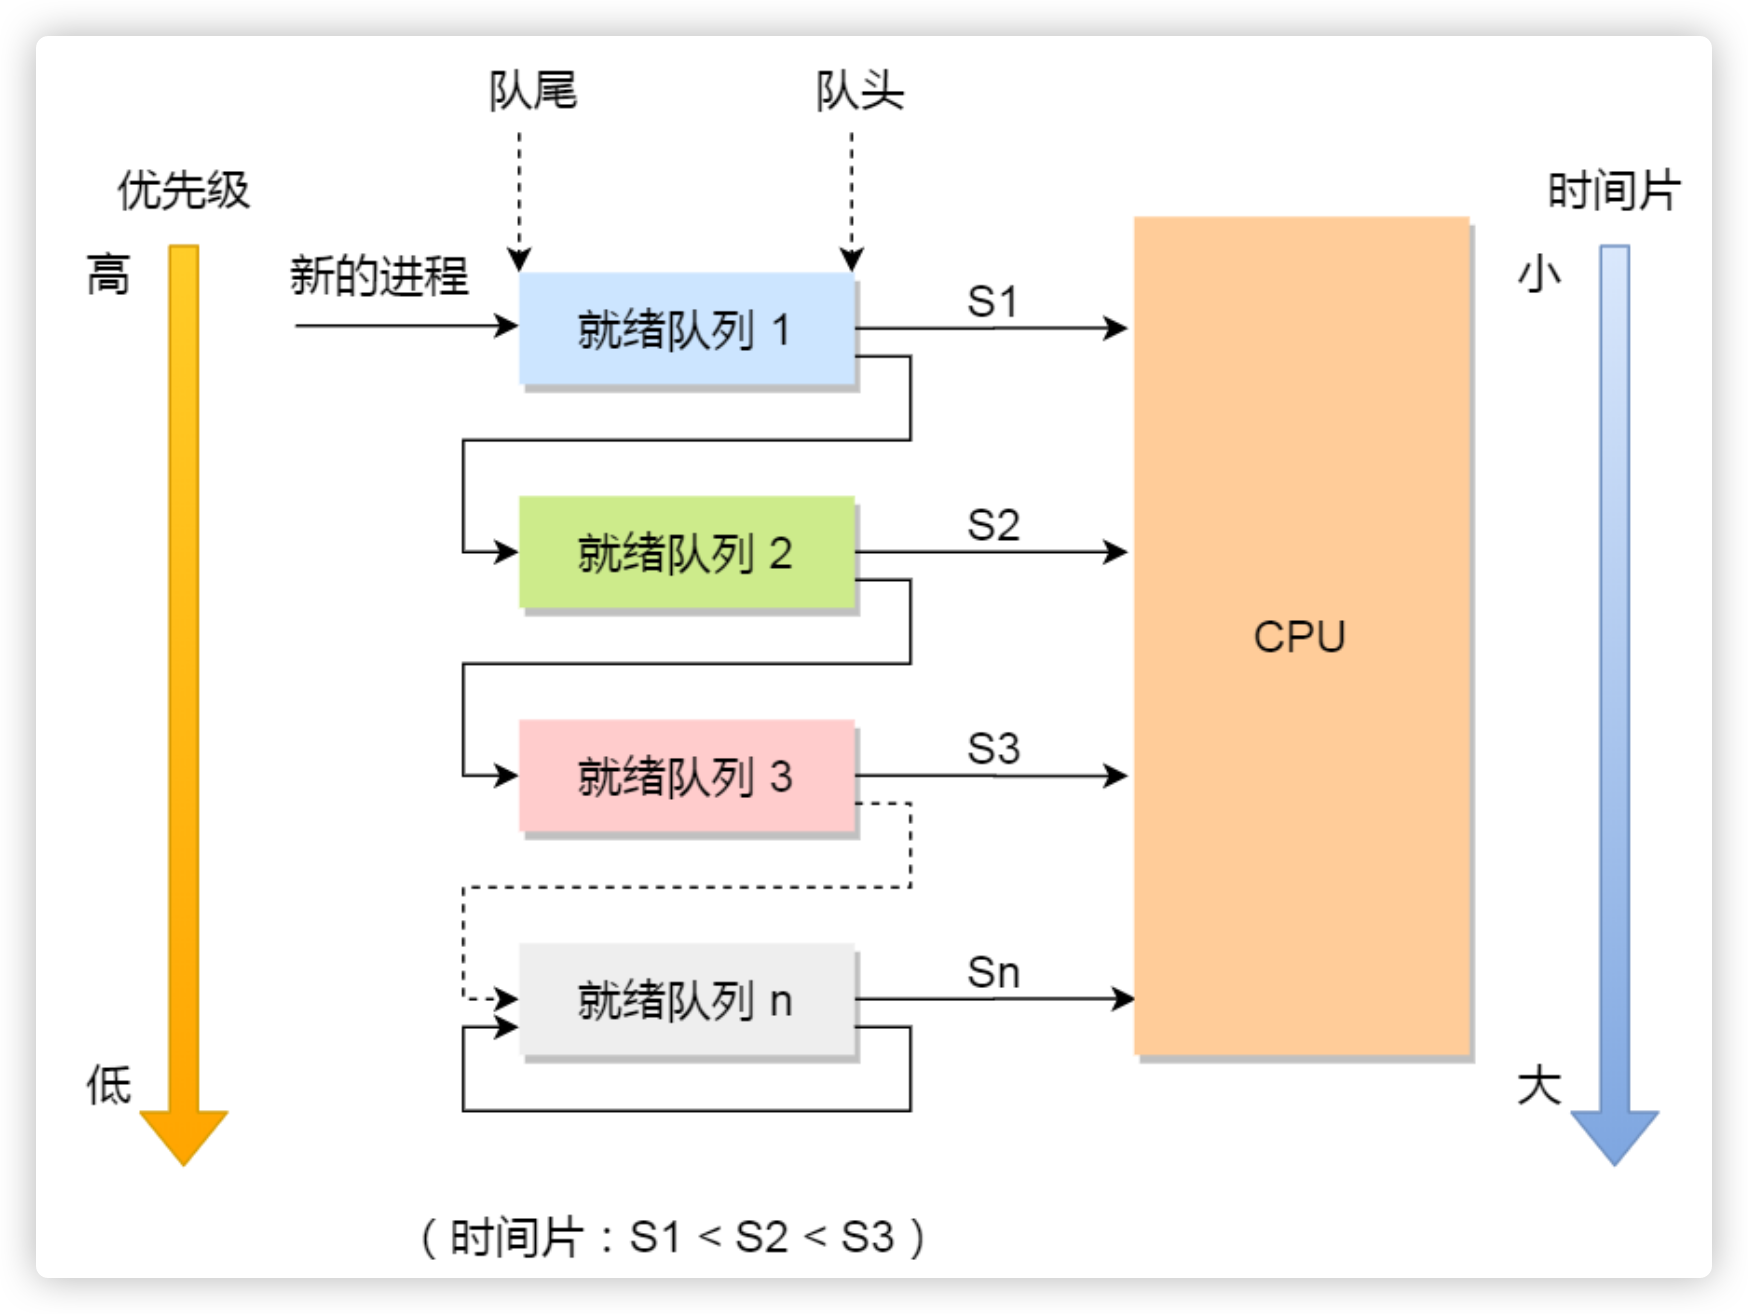
18.6 多级反馈队列调度算法(Multilevel Feedback Queue)
- 基本思想:结合多个优先级队列 + 时间片轮转策略,支持进程动态“降级”或“提升”。
- 机制:
- 初次进入:放入最高优先级队列
- 未完成:转入更低级别队列(更长时间片)
- 队列越低,优先级越低,但允许执行时间越长
- 老化机制:进程等待太久会提升优先级,避免饥饿
- 是否抢占:✅ 抢占式
- 特点:
- 适应性强,适合不同类型任务
- 实现复杂,参数设置(如队列数、时间片大小)影响调度性能
- 适用场景:通用操作系统中广泛使用,如 UNIX/Linux
19 进程同步与互斥
19.1 进程同步
进程同步是指为了完成某种任务而建立的两个或多个进程之间,为了协调执行顺序而产生的制约关系。进程同步的本质是多个进程之间由于合作而引发的直接制约关系。
19.2 进程互斥
某些资源在一段时间内只允许一个进程访问,我们称其为临界资源。访问临界资源的代码段被称为临界区。
访问临界资源通常采用如下结构:
 do {
   entry section;        // 进入区,对资源检查或上锁
   critical section;     // 临界区,访问临界资源
   exit section;         // 退出区,释放资源
   remainder section;    // 剩余区,执行其他操作
} while(true);互斥访问需满足的四个条件:
- 空闲让进:当无其他进程在临界区时,应允许进入。
- 忙则等待:已有进程在临界区时,其他进程必须等待。
- 有限等待:保证任何等待进入临界区的进程不会无限等待。
- 让权等待:若无法进入临界区,应主动让出处理器。
19.3 互斥的软件实现方法
19.3.1 单标志法
int turn = 0; // 控制哪个进程进入临界区

// P0
while(turn != 0);
critical section;
turn = 1;
remainder section;

// P1
while(turn != 1);
critical section;
turn = 0;
remainder section;**问题:**违背空闲让进原则,P1必须等待P0先进入。
19.3.2 双标志先检查
bool flag[2] = {false, false};

// P0
while(flag[1]);
flag[0] = true;
critical section;
flag[0] = false;
remainder section;

// P1
while(flag[0]);
flag[1] = true;
critical section;
flag[1] = false;
remainder section;**问题:**不满足忙则等待,存在先后时序竞争条件。
19.3.3 双标志后检查
bool flag[2] = {false, false};

// P0
flag[0] = true;
while(flag[1]);
critical section;
flag[0] = false;
remainder section;**问题:**可能两个进程都设置为true,互相等待,造成死锁。
19.3.4 Peterson 算法
bool flag[2] = {false, false};
int turn = 0;

// P0
flag[0] = true;
turn = 1;
while(flag[1] && turn == 1);
critical section;
flag[0] = false;
remainder section;**优点:**满足前三个互斥条件,但不满足让权等待。
19.4 互斥的硬件实现方法
19.4.1 中断屏蔽法
关闭中断 -> 执行临界区 -> 开中断。 仅适用于单处理器,不适用于多处理器系统。
19.4.2 TestAndSet指令(TSL)
bool TestAndSet(bool *lock) {
    bool old = *lock;
    *lock = true;
    return old;
}

while(TestAndSet(&lock));
critical section;
lock = false;**问题:**可能导致忙等待,不满足让权等待。
19.4.3 Swap 指令
void Swap(bool *a, bool *b) {
    bool temp = *a;
    *a = *b;
    *b = temp;
}

bool lock = false;
bool key = true;
while(key) Swap(&lock, &key);
critical section;
lock = false;**优点:**适用于多处理机,**缺点:**仍存在忙等待问题。
19.5 信号量机制
信号量是一种特殊变量,用于描述资源的使用情况。
19.5.1 整型信号量
int S = 1;
void wait(int S) {
    while(S <= 0);
    S--;
}

void signal(int S) {
    S++;
}存在忙等待问题。
19.5.2 记录型信号量
typedef struct {
    int value;
    struct process *L;
} semaphore;

void wait(semaphore S) {
    S.value--;
    if (S.value < 0)
        block(S.L);
}

void signal(semaphore S) {
    S.value++;
    if (S.value <= 0)
        wakeup(S.L);
}19.6 经典同步问题:生产者-消费者问题
该问题描述一个或多个生产者进程不断生产产品放入缓冲区,消费者进程从缓冲区取出产品。需保证:缓冲区不溢出、不空取。
19.6.1 有界缓冲区方案(使用信号量)
#define N 10
semaphore mutex = 1;     // 互斥访问缓冲区
semaphore full = 0;      // 表示已填充缓冲区槽数
semaphore empty = N;     // 表示空缓冲区槽数

// 生产者
do {
    produce_item();
    wait(empty);
    wait(mutex);
    insert_item();
    signal(mutex);
    signal(full);
} while(true);

// 消费者
do {
    wait(full);
    wait(mutex);
    remove_item();
    signal(mutex);
    signal(empty);
    consume_item();
} while(true);19.6.2 特点与考察重点
- 互斥:mutex 实现临界区保护
- 同步:full/empty 控制缓冲区状态
- 死锁规避:P/V操作顺序必须正确
19.7 经典同步问题:哲学家进餐问题
五位哲学家围坐在圆桌,轮流思考和进餐,每人左右各有一只筷子。筷子资源有限,每人需同时拿起左右筷子才能进餐。
19.7.1 基本模型
semaphore chopstick[5] = {1,1,1,1,1};

do {
    think();
    wait(chopstick[i]);
    wait(chopstick[(i+1)%5]);
    eat();
    signal(chopstick[i]);
    signal(chopstick[(i+1)%5]);
} while(true);**问题:**五人同时拿左边筷子 → 死锁。
19.7.2 常见解决方案
- 限制最多4人同时尝试进餐
- 奇数号哲学家先左后右,偶数号反之(破坏环路等待)
19.8 经典同步问题:读者-写者问题
多个读者可同时读取数据,写者独占写入。必须保证写时无读,读时无写。
19.8.1 第一类读者优先方案
semaphore mutex = 1;     // 保护 readcount
semaphore rw = 1;        // 控制写操作
int readcount = 0;

// 读者
wait(mutex);
readcount++;
if (readcount == 1) wait(rw); // 第一个读者阻止写者
signal(mutex);

read_data();

wait(mutex);
readcount--;
if (readcount == 0) signal(rw); // 最后一个读者释放写权限
signal(mutex);

// 写者
wait(rw);
write_data();
signal(rw);**问题:**写者饥饿。可采用第二类“写者优先”方案优化。
19.9 管程(Monitor)
管程是实现进程同步的高级语言机制,它将共享数据和操作封装为一个模块,内部自动提供互斥访问机制。
19.9.1 管程基本结构
monitor Buffer {
    condition not_full, not_empty;
    Item buffer[N];
    int count, in, out;

    procedure insert(Item x) {
        if (count == N) wait(not_full);
        buffer[in] = x;
        in = (in+1)%N;
        count++;
        signal(not_empty);
    }

    procedure remove(Item *x) {
        if (count == 0) wait(not_empty);
        *x = buffer[out];
        out = (out+1)%N;
        count--;
        signal(not_full);
    }
}19.9.2 管程特点
- 自动互斥:过程一次只允许一个进程执行
- 条件变量实现同步:通过
wait和signal管理等待/唤醒 - 高层封装:比P/V原语更安全、易于调试
19.10 死锁与处理策略
**死锁(Deadlock)**指多个进程因竞争资源而造成的一种互相等待现象,系统无法推进。
19.10.1 死锁产生的四个必要条件
- 互斥条件:资源一次仅能被一个进程占用。
- 占有且等待:已占有资源的进程可请求新资源。
- 不可抢占:已占资源不可被强行剥夺。
- 循环等待:进程形成资源等待环。
19.10.2 死锁处理策略
- 预防:破坏上述条件之一(如一次性申请全部资源)
- 避免:如银行家算法(Banker’s Algorithm)动态检查安全性
- 检测与恢复:
- 检测:构建资源分配图,寻找环
- 恢复:撤销进程、回滚操作
- 鸵鸟策略:在某些系统中,忽略死锁问题(如 UNIX)
20. 内存管理
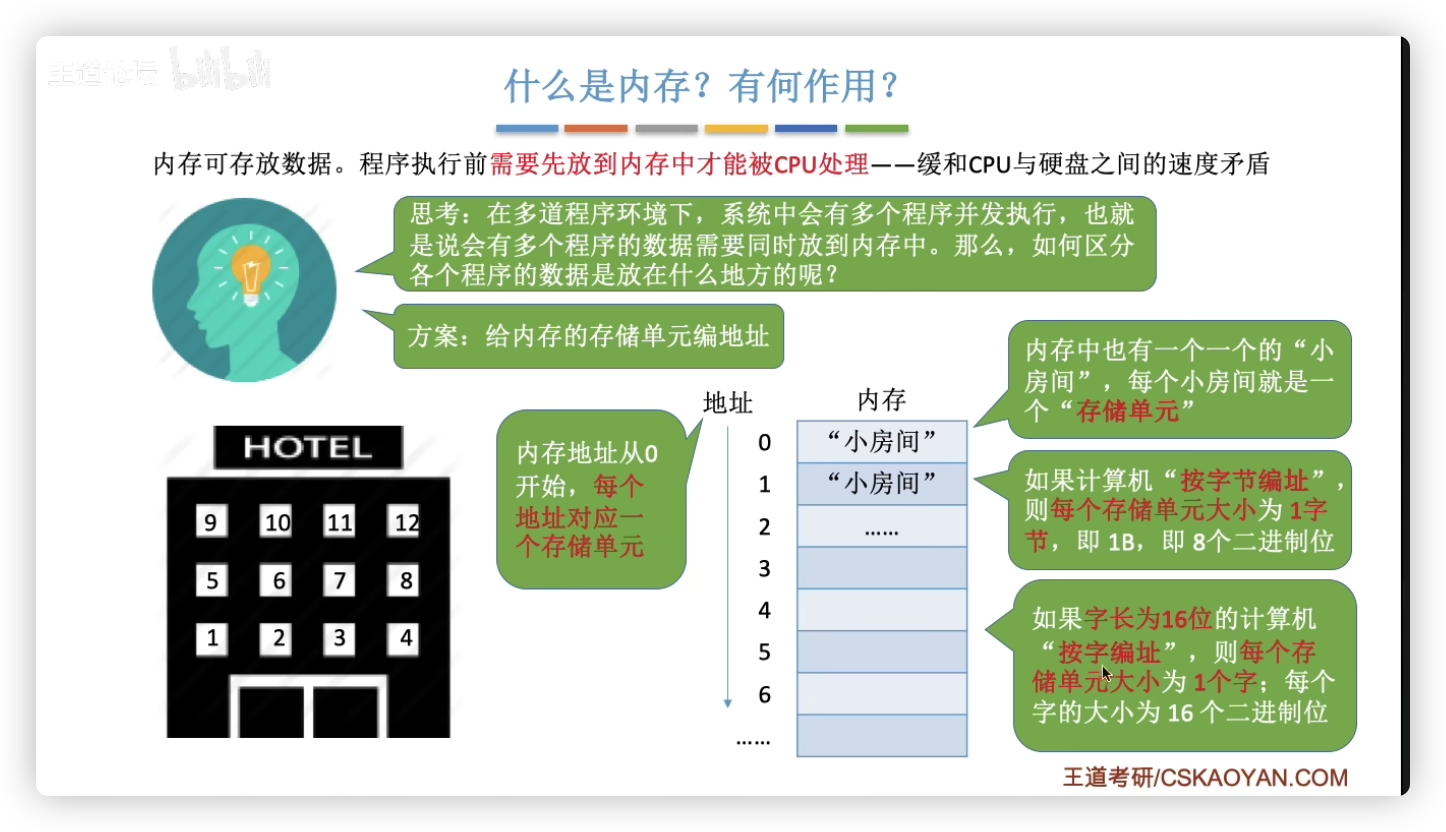
**内存(Memory)**是计算机系统中用于临时存放正在运行的程序和数据的存储器。内存的读写速度远快于外存(如磁盘),是CPU与其他硬件交互的核心资源之一。
20.1 内存的分配与回收
20.11 连续分配
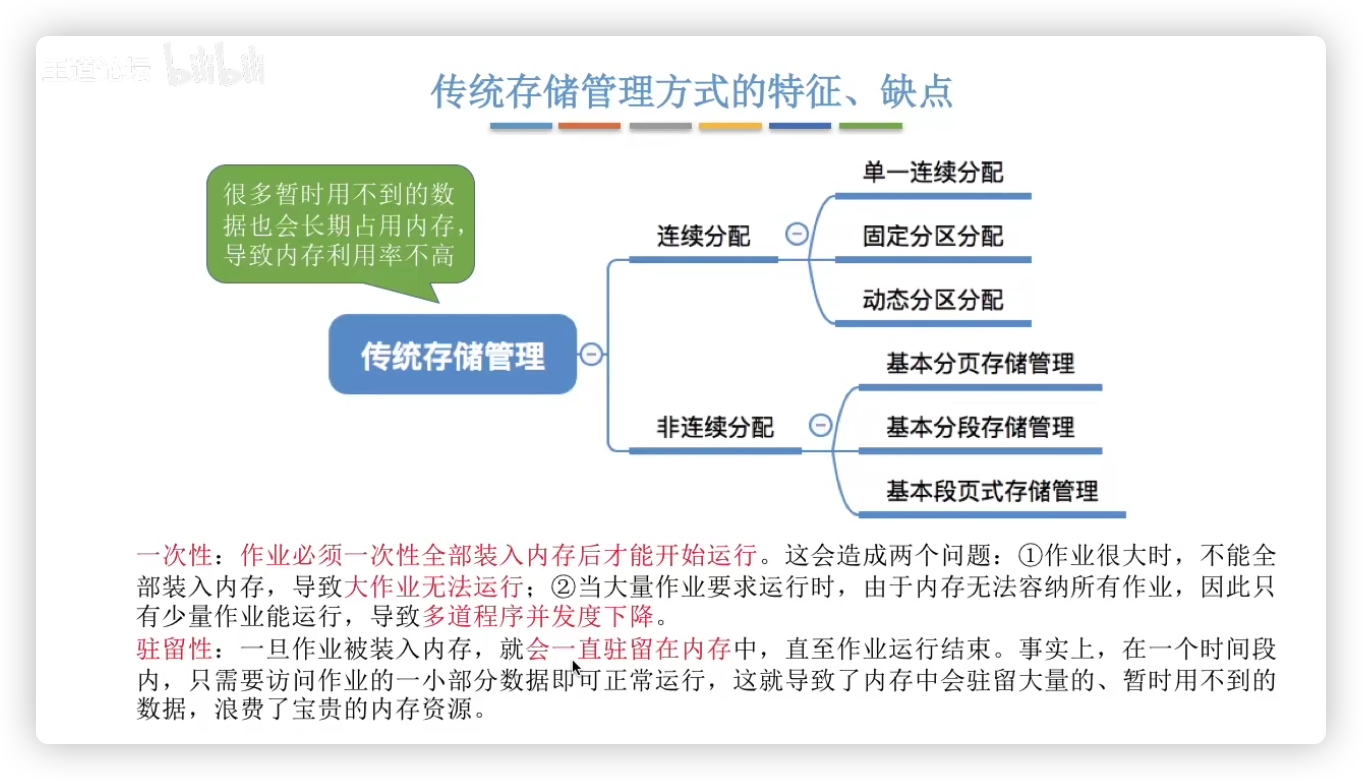
连续分配是一种早期的内存管理方式,其特点是为每个进程分配一块连续的物理内存空间。连续分配实现简单,但存在严重的碎片问题。
1. 实现方式
- 单一连续分配(Single Contiguous Allocation) 操作系统与用户程序共享一整块内存,内存被划分为两个部分:操作系统驻留在低地址部分,用户程序占用剩余部分。一次只能运行一个用户程序,管理简单但资源利用率极低。
- 固定分区分配(Fixed Partition Allocation) 将内存预先划分为若干个固定大小的分区,每个分区装载一个进程。空闲分区通过空闲分区表管理。
- 优点:实现简单,分配快速。
- 缺点:内碎片严重,即分区大小固定导致内部空间浪费。
- 动态分区分配(Dynamic Partition Allocation) 不预先划分内存,而是根据进程实际需要分配内存大小,分区大小动态变化。
- 优点:减少内碎片,提高内存利用率。
- 缺点:可能产生外碎片,即内存中未被使用的小碎片分布在各处。
2. 空闲空间管理策略
- 首次适应算法(First Fit):从头开始查找,找到第一个满足进程大小要求的空闲区。
- 最佳适应算法(Best Fit):遍历所有空闲区,找到最小但能满足需求的空闲区。
- 最坏适应算法(Worst Fit):选择最大的空闲区进行分配,试图留下较大剩余空间。
3. 内存回收 当进程结束或释放内存时,操作系统将其占用的内存回收到空闲链表中,并尝试与相邻空闲区合并,以减少碎片。
4. 连续分配的不足
- 分区间不可共享内存。
- 分配和释放操作较为频繁时,易形成碎片,影响长时间运行系统的稳定性。
- 需要复杂的压缩操作以合并碎片。
20.12 非连续分配
为了克服连续分配造成的内存碎片问题,非连续分配允许一个进程分配到多个不连续的物理内存块。这种方式提高了内存利用率,是现代操作系统的主流做法。
1. 基本思想 将程序划分为若干段或页,每段/页独立分配到物理内存的任意位置。逻辑地址不再直接等于物理地址,而需借助地址映射机制。
2. 非连续分配的典型实现方式:
- 分页(Paging) 将进程地址空间和物理内存划分为固定大小的页(Page)和页框(Frame)。通过**页表(Page Table)**实现逻辑地址到物理地址的映射。
- 优点:消除外碎片,页大小统一便于管理。
- 缺点:可能产生内碎片;地址转换需额外开销。
- 分段(Segmentation) 将进程划分为若干逻辑段(如代码段、数据段、栈段等),每段可独立分配到内存中。通过**段表(Segment Table)**管理。
- 优点:更贴近程序逻辑结构,支持共享和保护。
- 缺点:可能出现外碎片;实现较分页复杂。
- 段页式(Segmented Paging) 综合分页与分段的优点。先将地址空间分段,每段再分页。通过段表和页表的结合完成地址转换。
- 优点:既有逻辑结构清晰的优点,又可消除碎片。
- 缺点:地址转换过程复杂。
3. 内存回收
- 操作系统记录每个页/段的使用状态,回收时只需标记相应的页框/段为“空闲”即可。
- 非连续分配由于分散存放,回收更灵活,且不需合并碎片。
20.2 内存地址转换
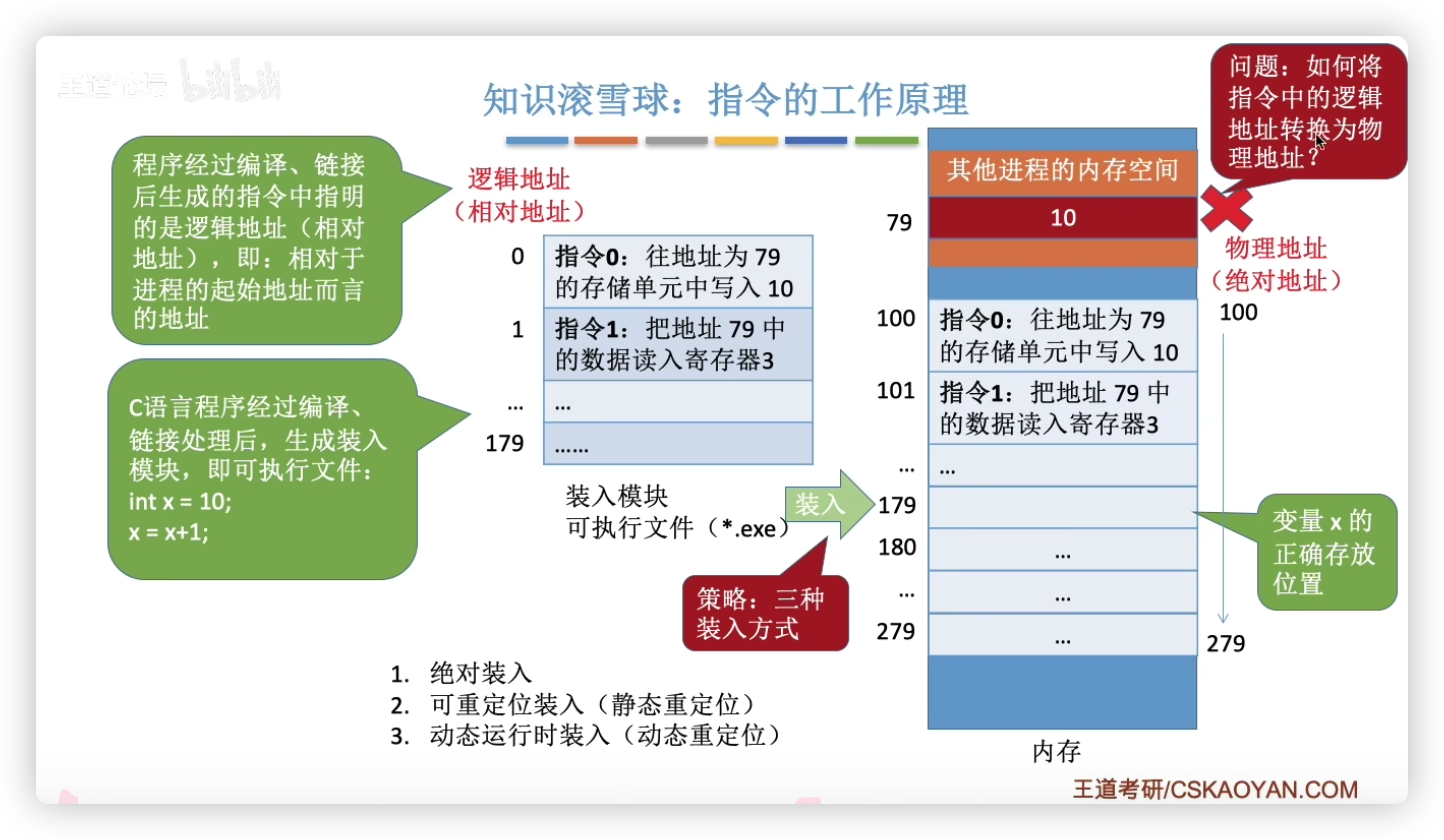
20.21 从写程序到程序运行的过程
1. 编写程序: 程序员用高级语言(如 C、Java)编写源代码。
2. 编译过程:
- 使用编译器将源代码编译为目标代码(机器语言的中间形式)。
- 编译器生成的代码中使用的是逻辑地址(尚未确定运行时位置)。
3. 链接过程:
- 使用链接器将多个目标文件、库函数等合并成一个完整的可执行文件。
- 链接方式可能为静态链接或动态链接。
- 生成的可执行文件中仍然使用逻辑地址。
4. 装载(加载)过程:
- 由操作系统的装载器将程序从磁盘载入内存。
- 为程序分配内存空间,并进行地址重定位,必要时填充基址。
5. 运行时过程:
- CPU 开始执行指令,发出逻辑地址。
- 通过 MMU 完成逻辑地址到物理地址的转换。
- 程序正式运行,进行内存访问、跳转、函数调用等操作。
20.21 逻辑地址vs物理地址
| 类型 | 描述 |
|---|---|
| 逻辑地址(Logical Address) | 程序员编写代码时使用的地址,也称为虚拟地址,由 CPU 生成。 |
| 物理地址(Physical Address) | 实际访问内存单元时使用的地址,由内存管理单元(MMU)产生。 |
- 当程序运行时,CPU 访问内存时发出的地址其实是逻辑地址,需要经过地址转换机制才能得到真正的物理地址。
- 地址空间:
- 逻辑地址空间:由程序使用的所有逻辑地址组成。
- 物理地址空间:由内存中实际存在的物理地址组成。
20.22 地址转换方式
在操作系统的内存管理中,地址转换(Address Translation)指的是将程序中使用的逻辑地址(Logical Address)或虚拟地址(Virtual Address)转换为物理地址(Physical Address)的过程。由于用户程序在运行时无法直接访问物理内存,因此地址转换机制是实现多道程序设计、内存保护和虚拟存储等功能的基础。
一、基本方式:基址寄存器(Base Register)+ 限长寄存器(Limit Register)
适用于单一连续分配或动态分区管理方式:
- 逻辑地址 + 基址寄存器值 = 物理地址
- 系统还会用限长寄存器检查逻辑地址是否合法(防止越界)
示例: 逻辑地址 = 200,基址寄存器 = 1000,则物理地址 = 1200 如果限长寄存器 = 500,则只有逻辑地址在 0,4990,4990,499 之间才是有效访问。
二、分页机制中的地址转换(适用于非连续分配)
分页(Paging)**机制中,用户的逻辑地址被划分为**页号(Page Number)**和**页内偏移量(Page Offset),地址转换时通过**页表(Page Table)**将页号映射为物理页框号(Frame Number):
- 逻辑地址结构:
逻辑地址 = 页号(p) + 页内偏移量(d) - 地址转换过程:
物理地址 = 页框号(f) × 页大小 + 页内偏移量(d)
系统中的页表存储了逻辑页号与物理页框号的对应关系。
例:
- 页大小为 1KB,逻辑地址为 2049B(即第2页第1B)
- 页表中页号2对应物理页框号为5
- 则物理地址 = 5×1024 + 1 = 5121
为提高效率,现代系统还使用**快表(TLB)**缓存页表项,加快转换速度。
三、分段机制中的地址转换(适用于逻辑分段管理)
**分段(Segmentation)**机制将程序分为多个逻辑段(如代码段、数据段、栈段等),逻辑地址包括:
- 段号(Segment Number)
- 段内偏移(Offset)
每个段有其段表(Segment Table),存放段的起始地址和段长。
地址转换过程如下:
- 从段表中查找段号对应的基址
- 加上段内偏移得到物理地址
- 同时检查偏移是否超过段长(用于越界保护)
例: 段1基址为3000,段长为500,若访问段1中偏移为100的位置: → 物理地址 = 3000 + 100 = 3100,且偏移100小于段长500,访问合法
四、段页式机制中的地址转换(分页 + 分段的结合)
段页式结合了分页和分段的优点。逻辑地址结构如下:
复制编辑
逻辑地址 = 段号 + 页号 + 页内偏移地址转换过程:
- 根据段号查段表,得到该段对应的页表地址
- 根据页号在对应页表中查页框号
- 最终物理地址 = 页框号 × 页大小 + 页内偏移
20.3 内存空间扩充
在现代操作系统中,由于物理内存的有限性,如何有效扩充内存空间,以支持多任务并行、程序的大规模运行以及提高内存的利用率,成为了内存管理中一个重要的课题。操作系统通过以下几种技术来扩充内存空间:
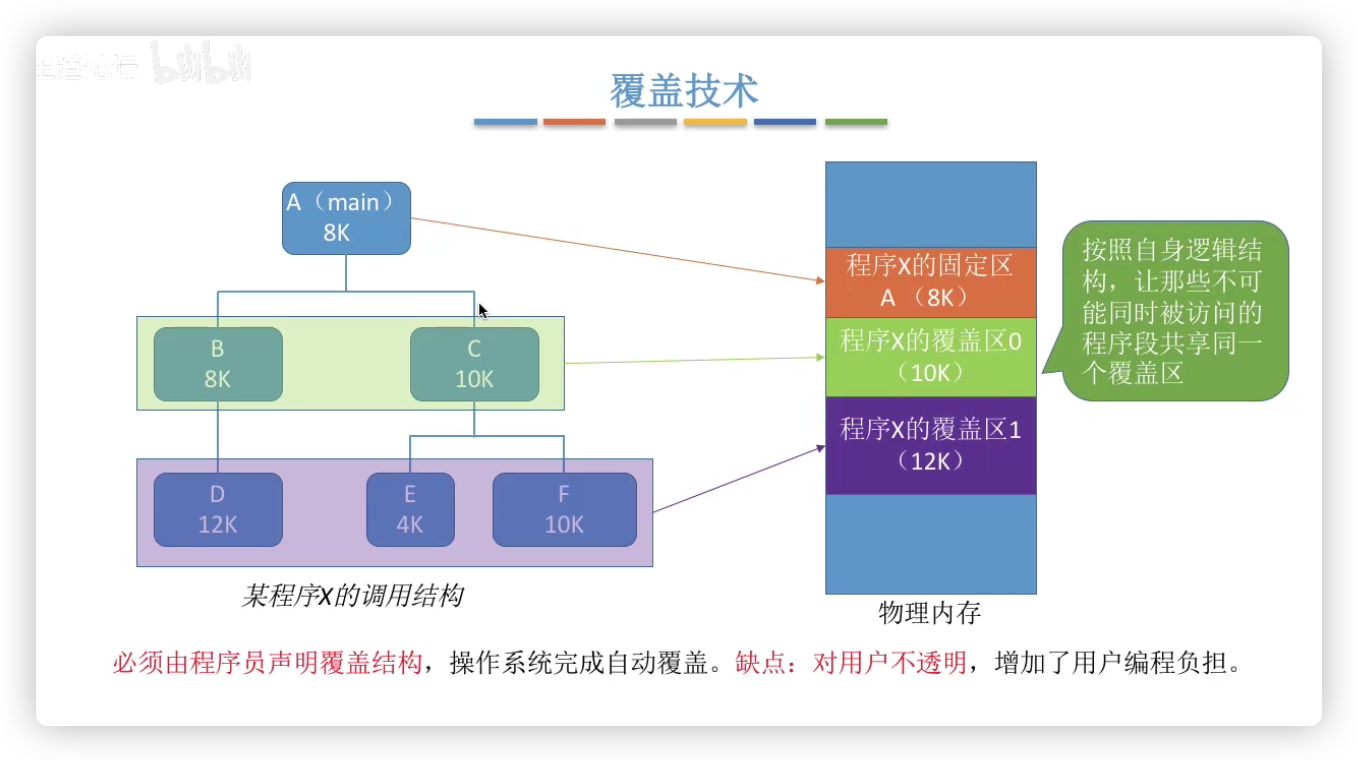
20.31 覆盖技术
覆盖技术是一种传统的内存管理技术,主要用于程序执行时需要的内存超出可用物理内存大小的情况。通过覆盖技术,程序可以将其各个部分分成不同的模块,每次只加载一个模块到内存中,其他模块则存储在外部存储设备上(如磁盘)。程序在运行时根据需要,动态地将不同的模块加载到内存中。
工作原理:
- 将程序分成多个模块(例如主程序、子程序等),每次只加载其中一部分。
- 在运行期间,当程序需要某个未加载模块时,将当前内存中的模块替换出去,加载新的模块。
优缺点:
- 优点:有效节省内存空间,可以运行超出物理内存的程序。
- 缺点:程序加载和替换过程可能导致大量的磁盘I/O操作,影响性能;程序需要手动设计和管理模块的覆盖关系,增加了程序的复杂性。
20.32 交换技术
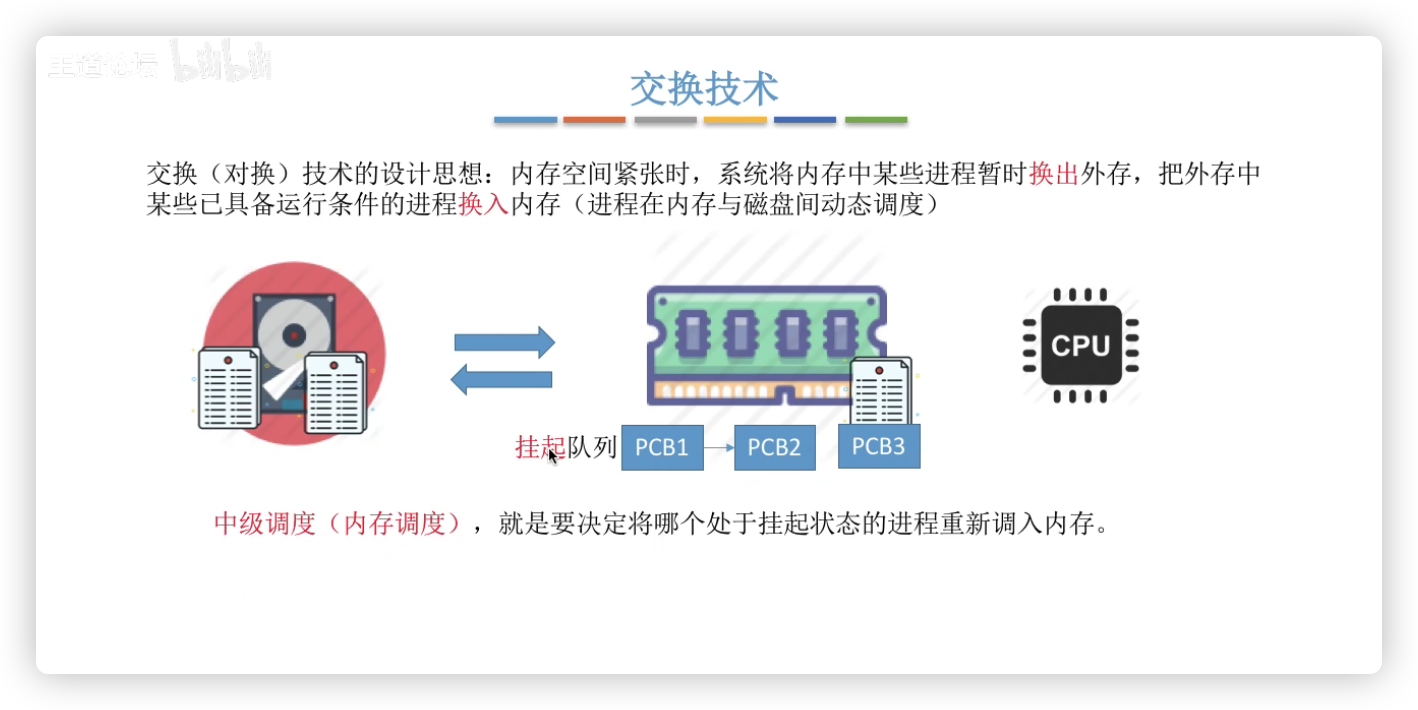
交换技术是一种通过将整个进程从内存交换到外存(如磁盘)以释放内存空间的技术。在内存空间不足时,操作系统将一个或多个进程的全部内容从内存中交换到外存,当需要执行该进程时,再将其从外存交换回内存。
工作原理:
- 当系统的内存不足以容纳所有的进程时,操作系统选择将一个进程交换到外部存储设备(通常是硬盘)中。
- 当系统需要这个进程时,会将其从外存加载回内存并进行执行。
- 交换是通过**交换空间(Swap Space)**来实现的,通常位于硬盘上。
优缺点:
- 优点:系统可以运行比物理内存更大的程序集,提高了内存利用率。
- 缺点:频繁的交换操作会引起较大的磁盘I/O,导致性能下降,尤其是在交换频繁时,可能会出现“交换抖动”(thrashing)现象,极大地影响系统性能。
20.33 虚拟技术
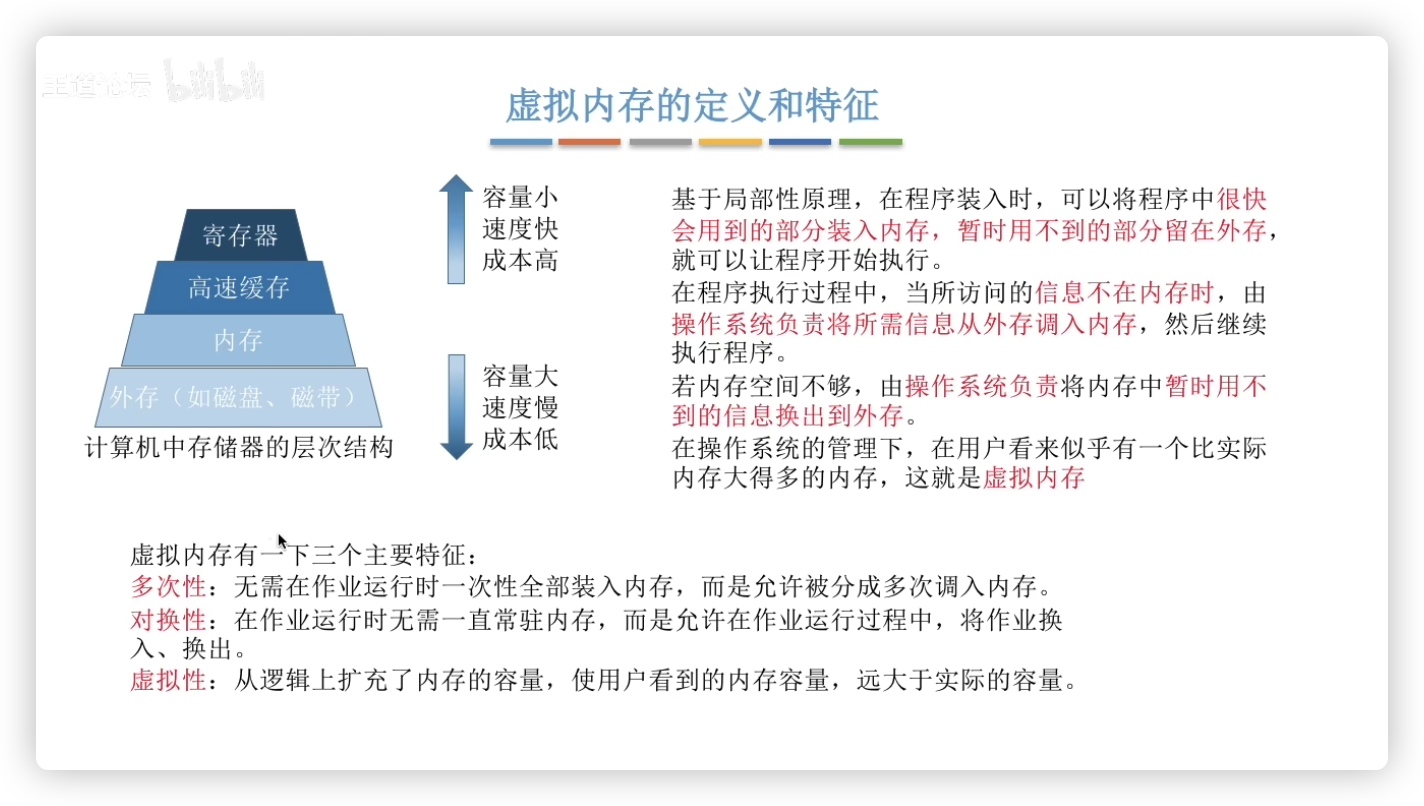
虚拟内存是现代操作系统中常用的一种内存扩充技术。虚拟内存通过将程序使用的逻辑地址空间映射到物理内存或外存上,使得每个进程能够认为它拥有连续的、足够大的内存空间,尽管实际物理内存的大小有限。虚拟内存是通过分页、分段和**页面交换(paging)**等技术实现的。
工作原理:
- 每个程序都有自己的虚拟地址空间,虚拟地址通过**页表(Page Table)或段表(Segment Table)**映射到物理地址。
- 当程序需要的内存空间超出物理内存的限制时,操作系统将部分数据从物理内存移到磁盘上的交换空间或文件中,而在需要时再将其从磁盘加载到内存中。
- 页面置换算法(如LRU、FIFO等)决定哪些页面应该被换出,哪些页面应该被换入内存。
优缺点:
- 优点:
- 为每个进程提供了几乎无限的内存空间,程序员不需要关心内存大小。
- 操作系统能够将物理内存按需分配,提高了内存的利用率。
- 支持进程间的内存隔离,提高了系统的安全性和稳定性。
- 缺点:
- 虚拟内存技术依赖磁盘I/O,当内存与磁盘之间交换频繁时,会降低系统的性能。
- 增加了操作系统的复杂度,需要进行高效的地址转换和页面管理。
20.4 内存保护
操作系统通过硬件和软件的结合来实现内存保护。以下是内存保护的几个关键机制:
20.41 地址空间隔离
每个程序在运行时都有自己的虚拟地址空间,操作系统通过内存管理单元(MMU)将虚拟地址映射到物理地址。这样,即使两个程序使用相同的虚拟地址,它们实际上访问的是不同的物理内存区域。
- 在CPU中设置一堆上下限寄存器,存放用户作业在主存中的上限地址与下限地址。当CPU要访问内存的时候,分别用这两个地址和要访问的地址做比较。
- 基址寄存器和界地址寄存器。重定位寄存器存储改作业的物理地址最小值;界地址寄存器存储改作业逻辑地址最大值。当CPU要访问内存的时候,分别用这两个地址数值之和与要访问的地址做比较。
20.42 内存分段和分页
操作系统使用分段和分页技术来管理内存。分段将内存划分为逻辑段(如代码段、数据段等),而分页则将内存划分为固定大小的页。通过分段和分页,操作系统可以更灵活地管理内存,并为每个程序分配独立的内存区域。
20.43 权限控制
操作系统为每个内存页或段设置访问权限(如读、写、执行)。当程序试图访问某个内存区域时,硬件会检查该区域的权限。如果程序没有相应的权限,操作系统会触发一个异常,阻止程序继续执行。
评论区
欢迎分享你的思考、补充或问题。