第三部分:提出研究计划
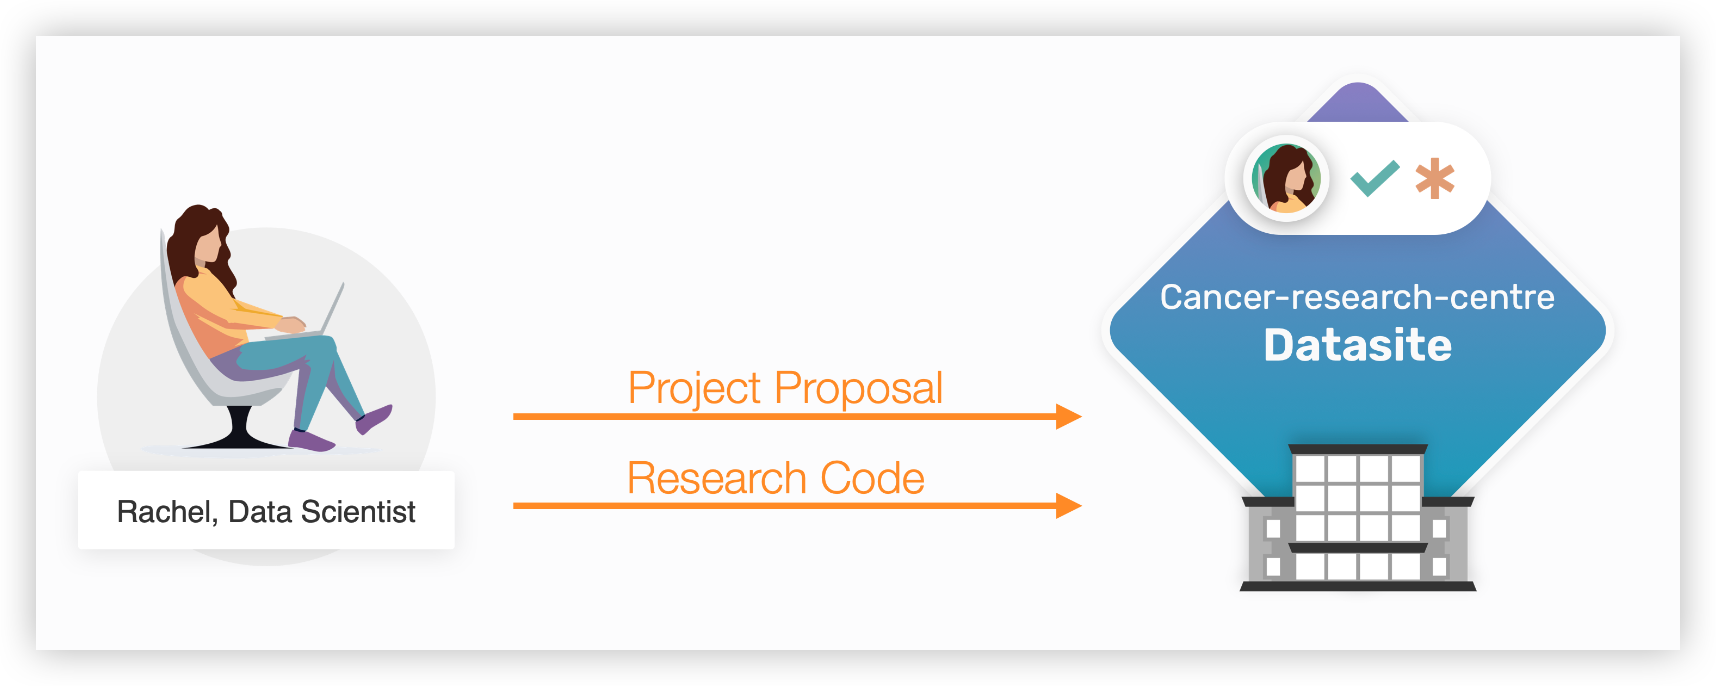
在第一部分和第二部分中,我们完全从数据所有者的角度学习了PySyft的功能。
根据自己的职责,实验室经理和PySyft数据所有者Owen通过创建并上传“乳腺癌生物标志物”数据集,并为Rachel创建远程访问凭据,成功设置了Datasite。
接下来,我们将探讨Rachel如何作为数据科学家与Datasite进行交互,以及PySyft如何确保外部用户永远无法看到或打开非公开信息。
使用PySyft对私密数据进行远程数据科学分析的工作流包括三个部分:
- 准备研究项目:这是最彻底的一部分,数据科学家在每个步骤中都有参与,将是本部分的重点。
- 对真实数据进行计算:使用私密数据作为输入,运行研究项目中嵌入的代码,计算真实结果(见第四部分)。
- 结果批准和发布:检查真实结果,确保其符合数据集的隐私政策;如果一切正常,结果将返回给数据科学家(见第五部分)。
进行非公开数据研究的第一步是准备研究项目提交。
你将学到什么?
通过第三部分的学习,你将能够:
- 作为数据科学家访问Datasite,并探索可用数据集;
- 使用模拟数据准备数据分析代码;
- 创建PySyft远程代码请求;
- 创建并提交研究项目提案至Datasite。
3.1 登录Datasite
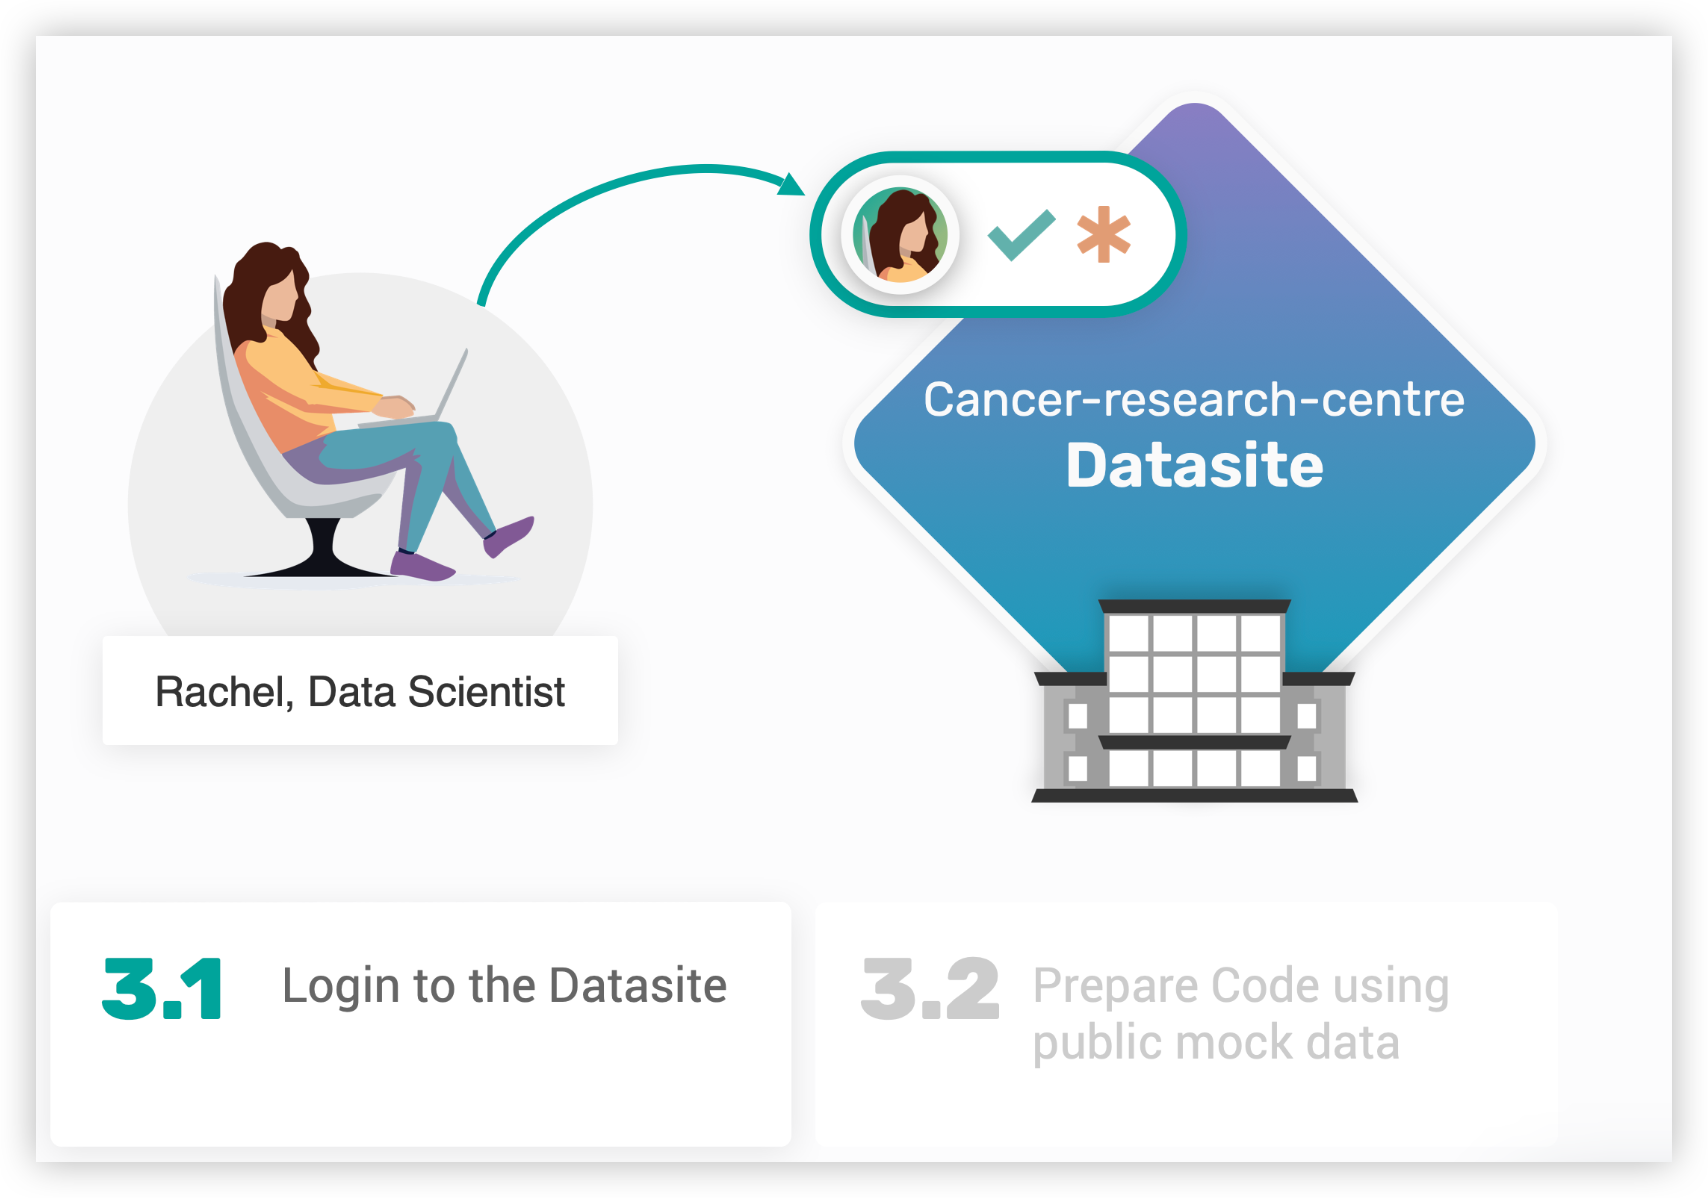
首先,确保本地开发的Datasite正在运行。如果没有,syft.orchestra.launch将重新启动服务器实例。
import syft as sy

data_site = sy.orchestra.launch(name="cancer-research-centre")现在是时候让Rachel使用Owen单独发送给她的凭据登录Datasite了:
client = data_site.login(email="rachel@datascience.inst", password="syftrocks")登录到域后,Rachel作为数据科学家可以探索Datasite中可用的数据集。我们可以通过访问client.datasets来轻松查看:
client.datasets如预期所示,Datasite包含一个数据集,名为“乳腺癌生物标志物”,包含2个资产。
一旦确定了我们感兴趣的数据集,我们可以通过索引或其唯一名称访问这些资产:
bc_dataset = client.datasets["Breast Cancer Biomarker"]我们获得了bc_dataset,它是指向远程数据集的指针。
使用指向远程数据集的指针,我们可以通过索引或唯一名称访问其内部资产。在本示例中,我们可以创建指向特征资产和目标资产的指针:
features, targets = bc_dataset.assets # 使用Python元组解包接下来,让我们验证假设,即数据科学家只能访问模拟数据,不能访问真实数据。我们将使用这两个变量features和targets,它们确实是指向相应远程资产的指针。
请记住:
在第一部分中,两个资产是作为pandas.DataFrame对象创建和存储的。
features.mock.head(n=3) # pandas.DataFrame我们尝试对targets做同样的事情:
targets.mock.head(n=3)太棒了!那么数据呢?🧐
features.data
targets.data正如预期的那样,Rachel作为数据科学家,没有读取权限(也没有其他权限)访问存储在远程资产中的非公开信息。
资产的主要组成部分之间的这一明确区别具有以下优势:
- 模拟数据是公开访问的,向外部共享非公开信息时不会对数据所有者造成风险;
- 为数据科学家创建了一个模拟的环境,使他们能够以现实的方式模拟其预期的研究;
- 降低了数据科学家的责任,他们不再需要负责安全存储非公开数据;
- 使数据所有者能够控制数据科学家如何使用非公开资产进行研究。
3.2 使用模拟数据准备代码
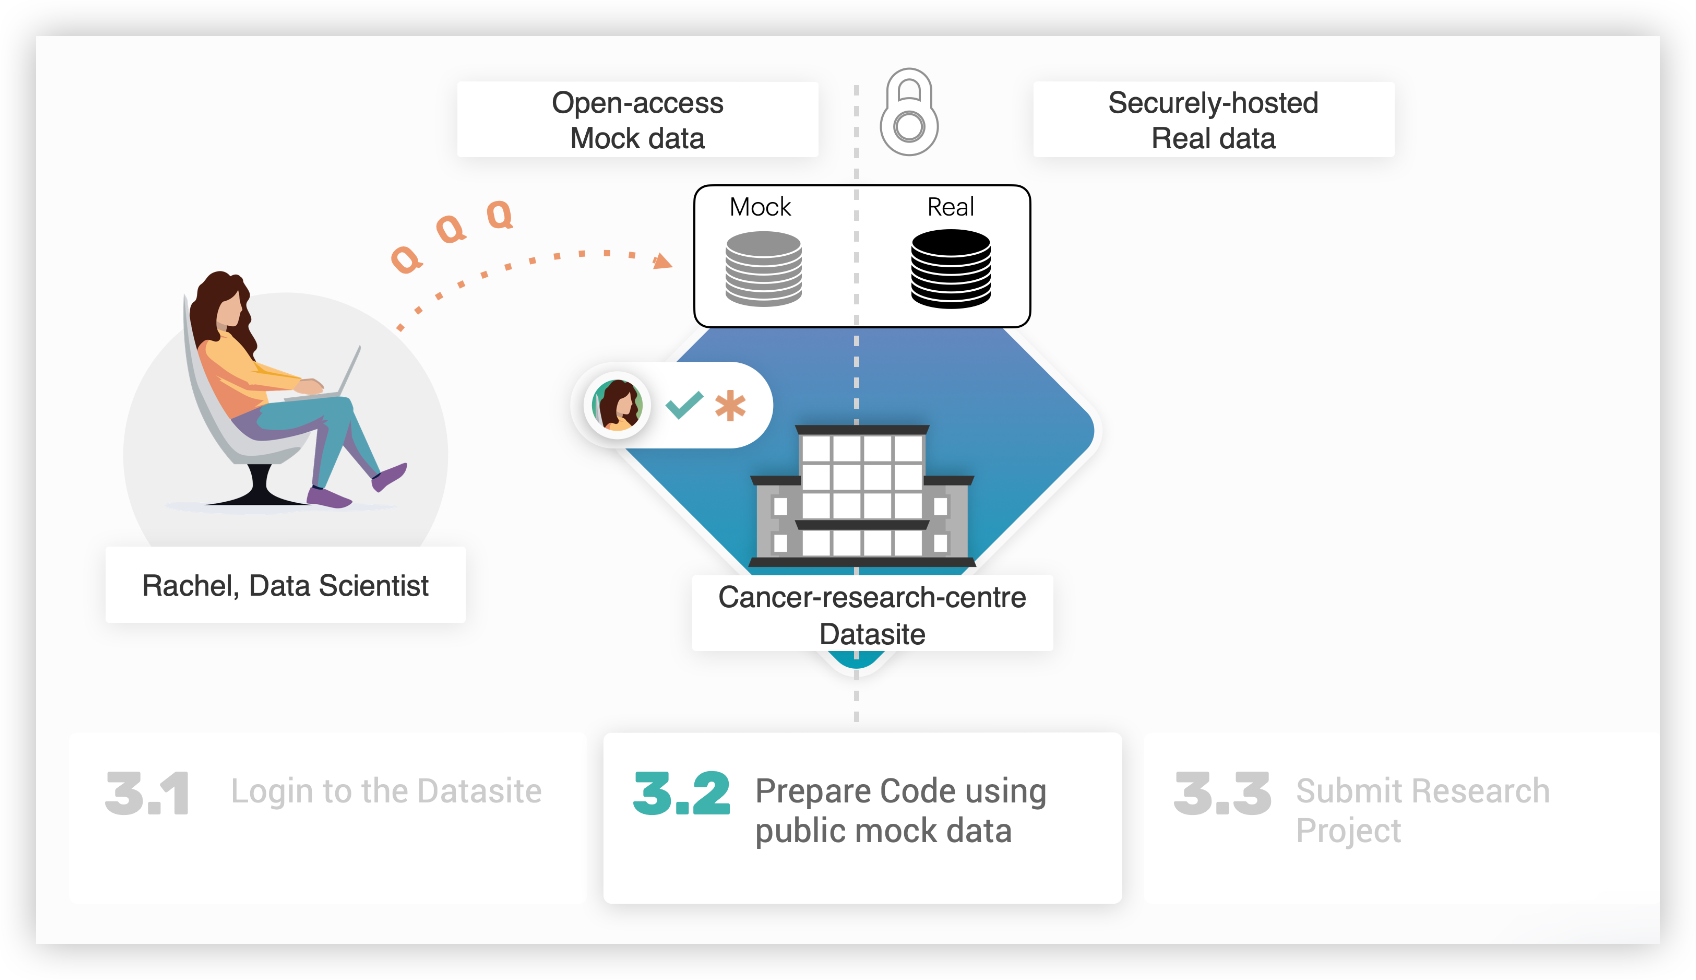
获得模拟数据可以让我们大致了解真实数据的样子。因此,我们可以使用这些数据开始准备代码,以便在这些数据上运行。
Rachel决定通过使用scikit-learn库,运行一个简单的监督学习实验来研究乳腺癌数据。数据集表示为pandas.DataFrame,特征已经是机器学习模型所期望的格式:样本x特征矩阵。通过查看模拟数据,Rachel得出结论,真实数据也应具有相同的格式。
X, y = features.mock, targets.mock简而言之,这是Rachel计划进行的机器学习实验的步骤:
- 使用
train_test_split函数生成训练和测试数据集; - 使用
StandardScaler对特征进行归一化; - 训练
LogisticRegression模型; - 计算训练数据和测试数据上的准确度。
为简便起见,我们将整个管道封装成一个Python函数。这样,在准备提交给PySyft远程执行的代码请求时,将更为简便。
def ml_experiment_on_breast_cancer_data(features_data, labels, seed: int = 12345) -> tuple[float, float]:
    # 包含所需的导入语句,准备提交代码时PySyft会需要这些
    from sklearn.model_selection import train_test_split
    from sklearn.preprocessing import StandardScaler
    from sklearn.linear_model import LogisticRegression
    from sklearn.metrics import accuracy_score

    X, y = features_data, labels.values.ravel()
    # 1. 数据划分
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=seed, stratify=y)
    # 2. 数据归一化
    scaler = StandardScaler()
    scaler.fit(X_train, y_train)
    X_train = scaler.transform(X_train)
    X_test = scaler.transform(X_test)
    # 3. 模型训练
    model = LogisticRegression().fit(X_train, y_train)
    # 4. 计算准确度
    acc_train = accuracy_score(y_train, model.predict(X_train))
    acc_test = accuracy_score(y_test, model.predict(X_test))

return acc_train, acc_test我们先在模拟数据上调用该函数,检查一切是否正常工作:
ml_experiment_on_breast_cancer_data(features_data=features.mock, labels=targets.mock)3.3 提交研究项目
现在,我们的代码已经在本地测试通过,准备将其代码转换为远程执行的请求,并创建一个新的研究项目提交到Datasite。
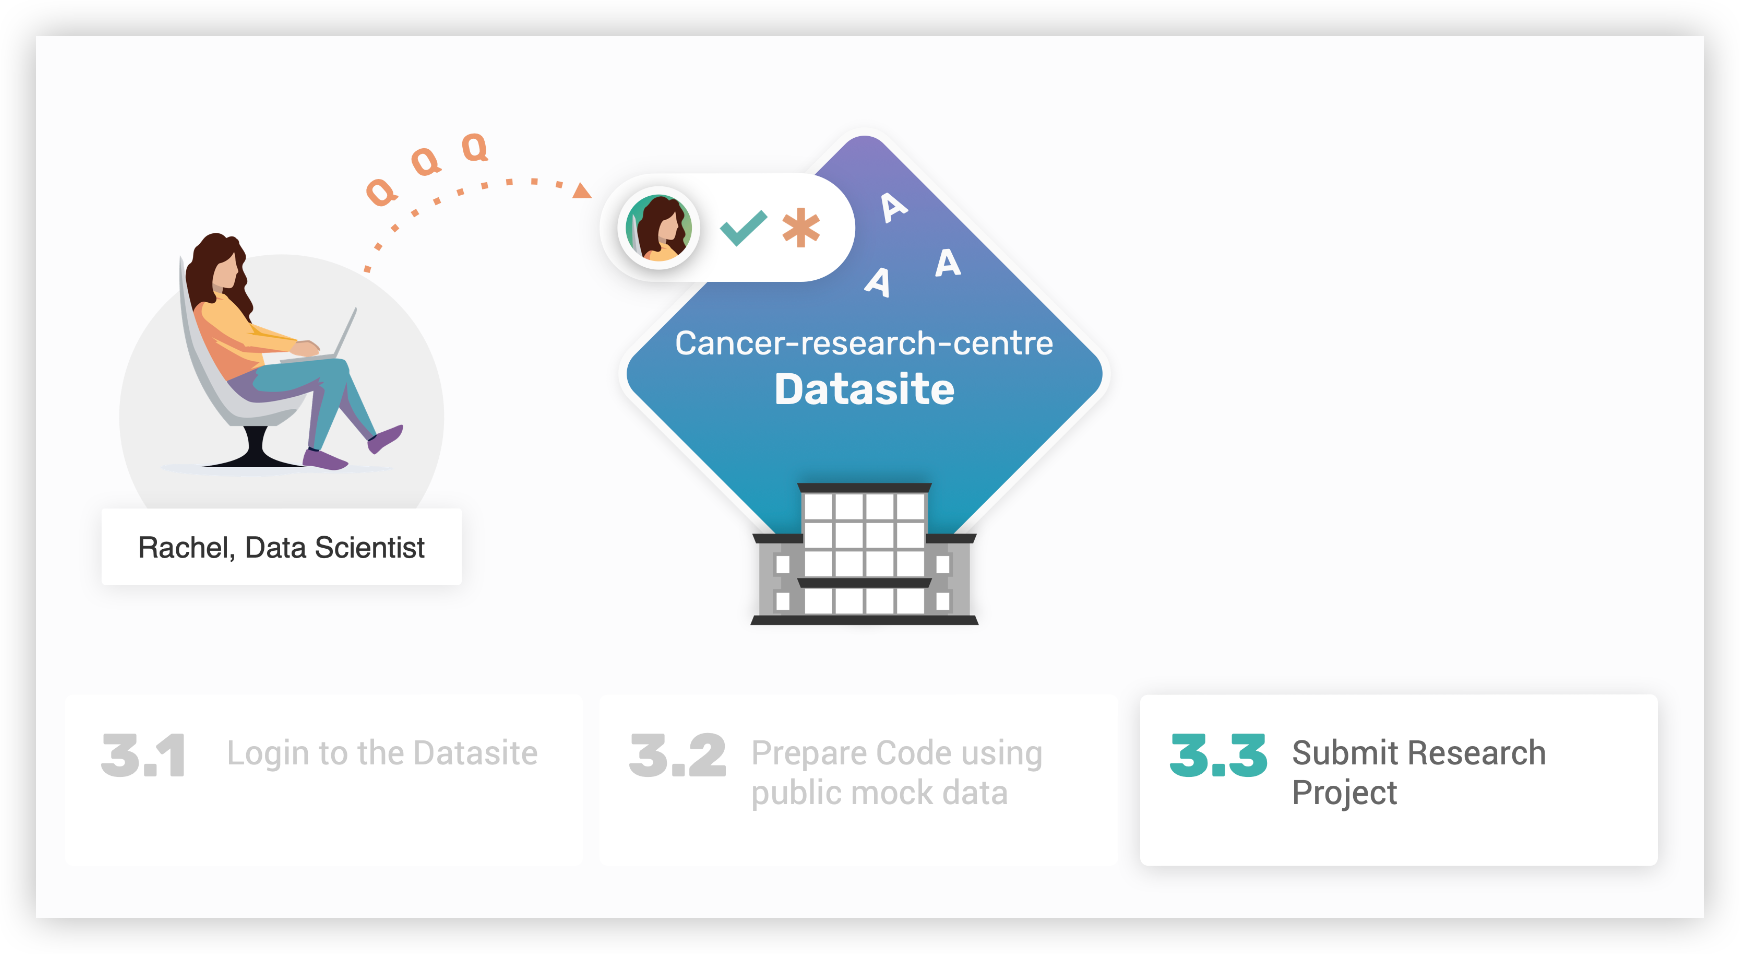
在上一节中,我们已经验证了函数 ml_experiment_on_breast_cancer_data 能够在模拟数据上成功运行。现在,我们有兴趣使用 PySyft 在真实数据上测试该函数。特别地,我们需要将本地 Python 函数转换为远程代码请求:一个可以被 PySyft 处理并在存储真实数据的 Datasite 上执行的函数。
为此,我们只需要用一个特殊的装饰器 syft_function_single_use 包裹该 Python 函数。
remote_user_code = sy.syft_function_single_use(features_data=features, labels=targets)(ml_experiment_on_breast_cancer_data)syft_function_single_use 装饰器
syft_function_single_use 装饰器是一个简单的快捷方式,基于更通用的 syft_function 装饰器。该装饰器需要两个主要参数:input_policy 和 output_policy。
input_policy提供给数据所有者信心,确保提交的代码只会在选定的输入资产上运行;output_policy用于在多次执行中维护状态,例如限制指定代码允许运行的最大次数。
想了解更多细节,请查阅 Syft Policy 组件。
此时,我们可以直接提交 remote_user_code 请求。然而,这会让 Owen 感到困惑,因为他完全不知道代码的意图,也不清楚 Rachel 想对“癌症研究中心”的数据进行什么样的研究!
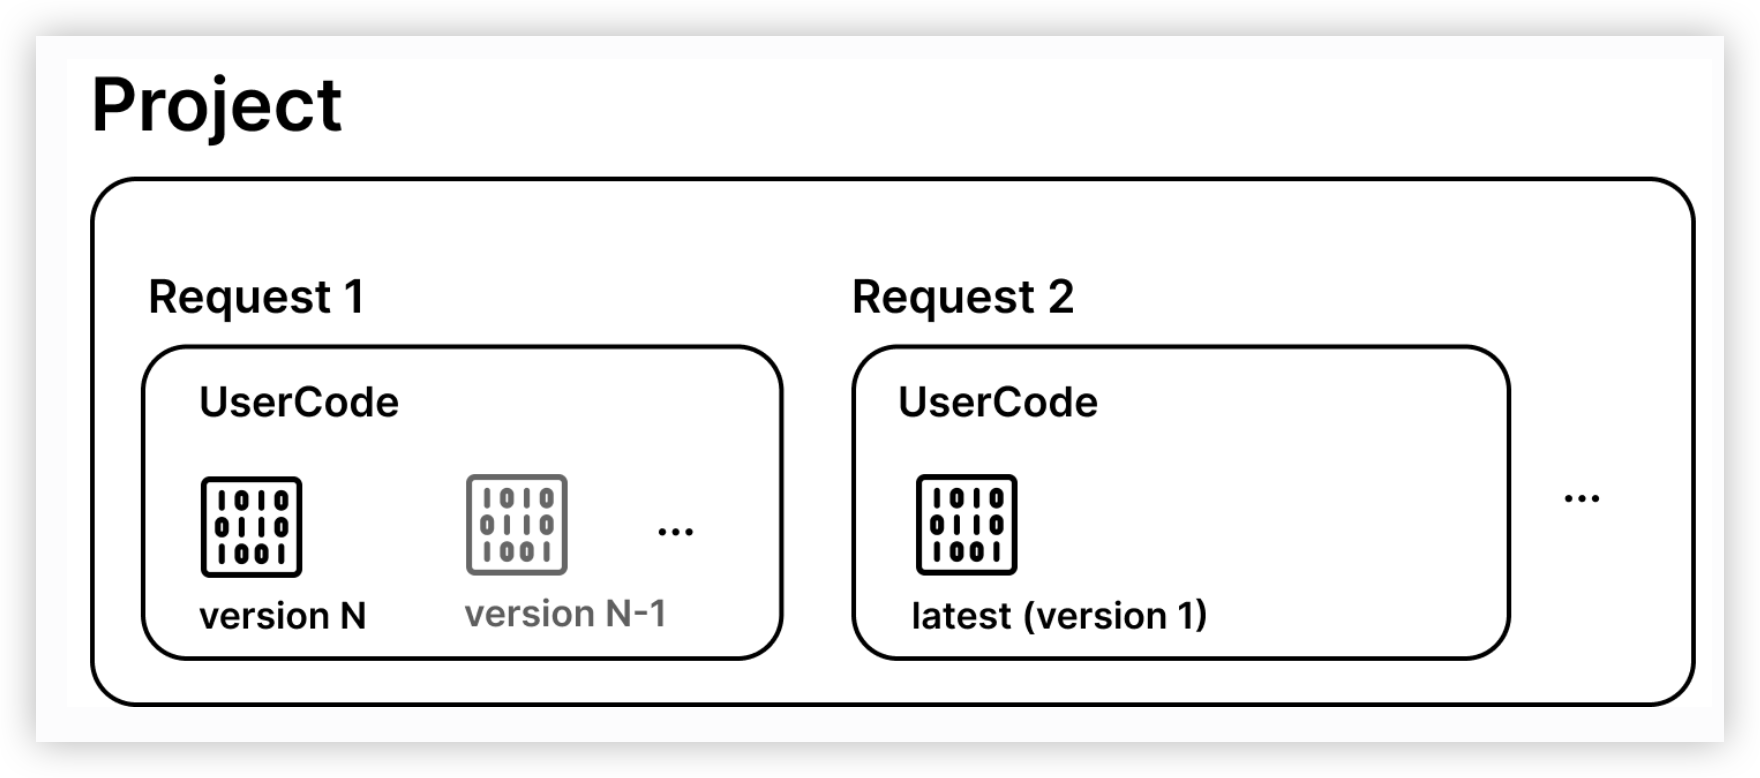
为了解决这些问题,PySyft 支持创建并提交一个研究项目!本质上,一个项目(即 syft.Project)由一个或多个代码请求组成,并包括一个简短的描述,用于向数据所有者传达研究的意图。
description = """
    本研究的目的是对乳腺癌数据运行一个机器学习实验流水线。
    第一次尝试包括对特征和标签的标准化步骤,
    使用 StandardScaler 和 LabelEncoder。
    选定的机器学习模型是 Logistic 回归,目的是
    获取训练和测试数据划分的准确度分数。
"""

# 创建项目
research_project = client.create_project(
    name="Breast Cancer ML Project",
    description=description,
    user_email_address="rachel@datascience.inst"
)我们可以通过客户端访问可用项目的列表:
client.projectsNOTE
项目通过其唯一名称标识。这意味着重复的提交会导致 PySyft 抛出错误。
我们可以使用 create_code_request 方法将代码请求附加到 syft.Project 实例(例如 research_project):
code_request = research_project.create_code_request(remote_user_code, client)我们可以检查代码请求是否成功添加到项目中:
client.code确实有一个代码请求,并且处于 PENDING 状态。类似地,我们可以通过访问 client.requests 查看已有的请求:
client.requests有关用户代码和请求的更多信息,请参阅 组件部分。
强制执行未审批请求
假设 Rachel 非常心急,尝试强制执行尚未审批的请求。让我们看看 PySyft 的响应:
client.code.ml_experiment_on_breast_cancer_data(features_data=features, labels=targets)如预期的那样,如果尝试执行未审批的代码请求,PySyft 会返回 SyftError!
恭喜完成第三部分 🎉
完成教程的第三部分! 👏
Rachel 现已准备好并提交了研究项目,等待 Owen 审核。该项目包含 Rachel 准备并在模拟数据上测试的机器学习流水线,并已附加到项目中,供在真实数据上远程执行。
在第四部分中,我们将探讨代码请求审核流程在 PySyft 中的工作方式,再次切换到数据所有者的视角,了解如何审核并审批请求。
评论区
欢迎分享你的思考、补充或问题。